首页/文章/ 详情

深度洞察:AI来了,工业软件为什么反而更难看清了?
12分钟前浏览0


AI来了,工业软件为什么反而更难看清了?

从技术革命、产业护城河到价值重构:建立理解工业软件未来的六个坐标

全球工业软件与 AI Native Engineering 产业观察|2026年10月


当信息不再稀缺,真正稀缺的是什么?

最近,与几位关注工业软件的朋友交流时,一个问题反复出现:

AI 已经发展到今天这个阶段,我们究竟应该怎样看待工业软件产业的未来?

这个问题并不容易回答。

对于传统工业软件企业来说,AI 既意味着新一轮技术创新机会,也意味着产品架构、研发体系、客户关系和商业模式可能受到挑战。

对于 AI 创业公司来说,工业软件似乎是一个极具吸引力的市场。这个领域拥有大量高价值专业知识,客户对工程效率、产品质量和研发成本有明确需求,而传统软件的复杂操作与较高学习门槛,又为新的交互方式提供了想象空间。

对于资本市场来说,情况更加复杂。

一方面,工业软件是经过数十年发展、形成了相对稳定竞争格局的成熟产业。另一方面,AI 正在降低软件开发成本、改变专业知识的使用方式,并可能重新组织工程任务。

于是,投资者面临一个问题:究竟应该继续投资拥有深厚技术积累的传统工业软件企业,还是寻找可能改变原有产业格局的 AI 原生公司?毕竟这个行业还是值得投资以及可看到受益的,尤其是中国,还没有海外那种体量的上市企业。

而对于地方政府、产业园区和产业服务机构来说,困惑同样存在。

过去可以按照 CAD、CAE、CAM、EDA、PLM、MES 等软件类别识别企业、绘制产业地图、建设产业链生态。

但当一家新公司仅凭数十名开发人员、若干开源技术组件和 AI 编程工具,就能迅速推出具有专业功能的软件原型时,传统的产业分类和企业能力判断方法,还是否足够?

这些困惑有一个共同特点:

AI 带来了前所未有的技术可能性,但技术可能性的增加,并不等于产业发展方向变得更加清晰。

甚至恰恰相反。

AI 降低了信息获取成本,让每个人都可以快速生成行业报告、技术分析、商业计划和产业预测。

但这些内容究竟哪些重要、哪些可靠、哪些具有战略意义,反而需要更强的专业判断。

今天,普通信息越来越容易获得。

真正稀缺的,正在从信息本身转向三个方面:

提出正确问题的能力、理解复杂系统的能力,以及判断技术价值的能力。

这也是我认为专业产业研究在 AI 时代不仅不会失去意义,反而可能变得更加重要的原因。

因为产业研究的真正价值,从来不只是告诉别人发生了什么。

而是解释:

为什么发生,改变了什么,什么不会轻易改变,以及未来应该观察哪些变量。

要理解 AI 对工业软件的影响,我认为需要先跳出单个技术、单个产品和单家企业的视角,建立一套更加完整的产业分析框架。


一、第一重坐标:AI 改变的是市场份额,还是市场本身?
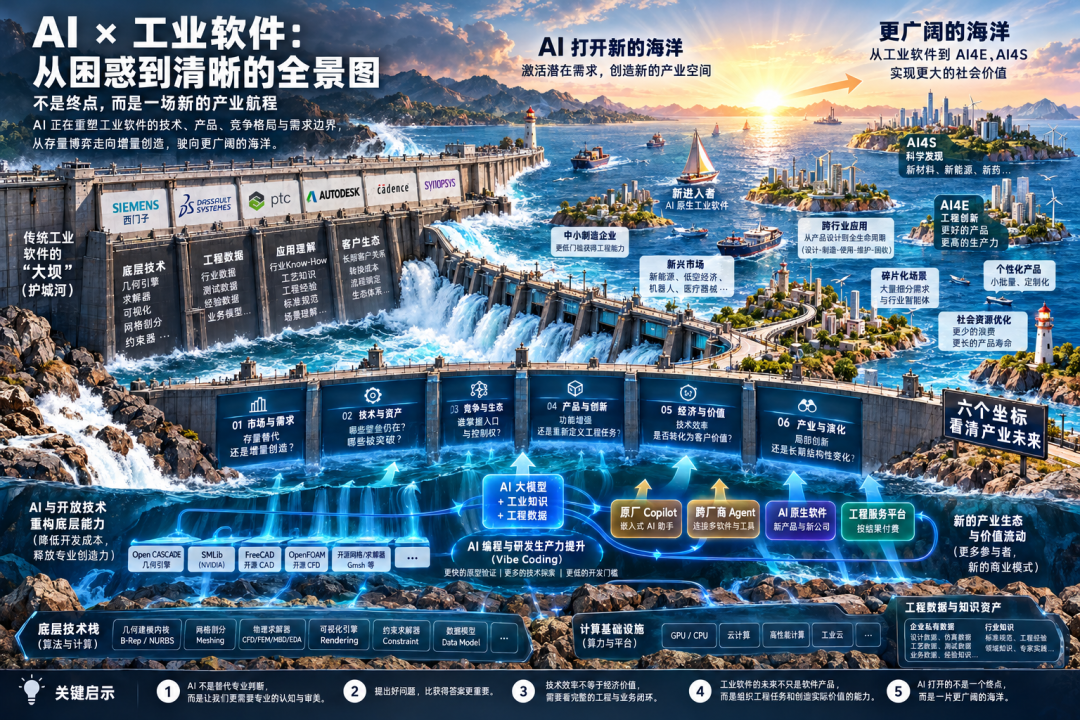
不妨把全球工业软件市场想象成一片广阔的海洋。

过去六七十年,西门子、达索系统、PTC、Autodesk、Cadence、Synopsys 等企业,通过长期技术研发、产品迭代、客户经营和产业生态建设,在这片海洋中建立了庞大的工程基础设施。

它们拥有自己的水坝、水库、航道和港口。

这些基础设施不是一天建成的。

几何建模、约束求解、网格剖分、物理仿真、设计管理、数据交换、产品生命周期管理以及复杂工业流程,构成了这些企业长期积累的技术与商业资产。

随着大量制造企业将研发、设计、生产和管理活动建立在相关软件体系之上,工业软件巨头逐渐形成了稳定的市场地位。

从这个角度看,AI 的出现,确实可能使原有的大坝出现裂缝。

一些过去需要购买专业软件才能完成的工作,可能通过 AI 工具完成;一些原来被单一厂商控制的用户入口,可能被第三方 Copilot 或 Agent 重新组织。

市场中的部分预算,可能从传统许可证、订阅产品和专业软件服务,转移到新的 AI 工具、算力服务和工程智能体。

但这里首先需要回答一个问题:

AI 的出现,是否会让这片海洋中的水突然增加?

答案并不是必然的。

从短期看,制造企业能够用于工业软件的预算,仍然受到经营规模、研发投入、盈利能力和投资回报要求的约束。

即使出现了令人惊艳的 AI CAD 产品,客户也不一定立即增加总体软件预算。

它可能只是减少传统 CAD 支出,转而购买 AI 工具。

或者降低原有软件使用量,把节省下来的资金投入其他业务。

这属于存量市场的重新分配。

但是,如果只看到这一点,又可能低估 AI 的长期影响。

因为工业软件市场中还存在另一类需求:过去因为技术门槛、实施成本或专业人才不足,而始终没有转化为实际购买行为的潜在需求。

一家中小制造企业可能一直希望进行复杂仿真,但负担不起专业软件和人员成本。

一家非标设备公司可能希望自动生成部分设计和工艺方案,却无力开发相应的软件系统。

一家零部件企业可能希望在设计阶段直接获取供应商报价、库存和交付周期,但现有软件流程无法经济地满足这一需求。

这些需求并不是不存在。

而是过去满足它们的成本过高。

假设某项工程任务能够为企业创造10万元经济收益,但完成它需要投入15万元,那么企业大概率不会实施。

如果 AI 与成熟工业软件技术的结合,使完成同样任务的综合成本下降到3万元,情况就发生了变化。

原来没有形成市场交易的工程需求,现在可能转化为新的有效需求。

于是,AI 对工业软件市场的影响,就存在两种不同机制。

一种是存量替代:改变现有市场预算的分配方式。

另一种是增量创造:使原来不具备经济可行性的工程任务进入市场。

这两种机制可能同时发生。

而市场最终是扩大还是收缩,还要看新增需求数量、软件价格下降幅度和价值分配方式之间的关系。

即使未来 CAD、CAE 的使用量显著增长,软件行业的总收入也不一定同比增长。

因为单位工程任务的价格可能下降。

技术使用规模、客户获得的经济价值与软件企业实现的商业收入,是三个必须分别观察的指标。

这是研究 AI 时代工业软件市场的第一个基本坐标。


二、第二重坐标:AI 究竟能够突破传统工业软件的哪些护城河?

讨论 AI 对工业软件的影响,不能回避一个基本事实:

传统工业软件企业并不是缺乏技术创新能力的传统产业公司,它们本身就是经过长期技术竞争成长起来的高科技企业。

对于这些企业,几十年的历史积累绝不只是代码数量和客户数量。

一套成熟的几何建模内核,价值不仅在于能够执行拉伸、旋转、布尔运算等基本操作,还在于它能否稳定处理复杂曲面、退化几何、极小边、拓扑异常和数值容差等工程问题。

一个成熟的仿真求解器,价值也不仅在于实现了某种数学算法,还在于它经过多少实际工程场景的验证,能否正确处理边界条件、计算收敛、复杂材料模型和各种异常情况。

这些能力经过长期积累,逐渐形成了工业软件企业深层的技术壁垒。

但如果进一步分析,这些护城河并不是一个整体。

它们至少包含底层算法与软件技术、工程验证与测试体系、工业知识、工程数据结构、客户业务理解、组织流程以及产业生态等不同层次。

而 AI 对不同层次的影响,并不相同。

对于软件界面、重复性操作、文档检索和部分代码开发,AI 已经具备较强的辅助能力。

对于复杂几何建模、物理仿真、工程决策和高可靠性系统,则仍然需要专业算法、可信验证和实际工程经验的支持。

因此,不能因为 AI 能够迅速开发一个三维建模原型,就认定它已经突破商业 CAD 的全部技术壁垒。

同样,也不能因为传统企业拥有成熟几何内核和数十年客户积累,就认为其竞争地位永远不会受到挑战。

真正需要研究的是:

哪些历史积累仍然是创造工程价值的必要条件,哪些可以通过技术开放被复用,哪些可能因为新的软件架构而失去原来的战略意义?

这里还涉及一个常被忽视的问题:传统工业软件公司的技术吸收能力。

这些公司拥有大量优秀的软件工程师、数学研究人员和行业专家,具有成熟的研发体系和持续迭代能力。

它们没有率先发明大语言模型,不代表它们没有能力应用大语言模型。

事实上,传统企业已经开始积极推进 AI 产品化。

西门子在 Designcenter NX 中引入 Copilot,帮助用户理解专业设计流程并使用软件功能;PTC 于2026年4月推出 Windchill AI Assistant,将自然语言交互引入产品生命周期管理系统,以改善工程数据的查询与使用。

2026年3月,NVIDIA 还宣布与 Cadence、达索系统、PTC、西门子和 Synopsys 等工业软件企业开展工业 AI 合作,涉及专业智能体、GPU 加速及工程计算。

这说明,传统工业软件企业并非只能被动防御。

它们同样可以利用 AI 提升研发效率、改善软件体验、扩展专业功能,并探索新的商业模式。

这就形成了一种双向作用。

AI 既可能降低新进入者的技术门槛,也可能放大传统企业已经积累的专业能力。

因此,新兴企业能否获得竞争优势,不能仅仅取决于谁更早使用 AI。

还取决于既有企业的技术吸收速度、组织反应能力、既有商业模式的约束,以及新企业能否找到不同于传统产品架构的价值创造路径。

这也是为什么我们不能将工业软件的未来简单理解为“AI 企业替代传统企业”。

我们面对的实际上是一场不同技术资产、组织能力和商业模式之间的动态竞争。


来源:工业软件产业发展探索
Windchill通信海洋材料SYNOPSYSCadencePLM控制曲面
著作权归作者所有,欢迎分享,未经许可,不得转载
首次发布时间:2026-10-23
最近编辑:12分钟前
易赋
签名征集中
获赞 5粉丝 6文章 92课程 0
点赞
收藏
作者推荐

2023-2025全球AI产业战略级全景复盘:大分流与新共识

摘要2023年至2025年不仅是人工智能技术的爆发期,更是全球地缘政治与科技战略深度重构的三年。从ChatGPT的“iPhone时刻”到DeepSeek R1引发的“推理平权”,全球AI产业经历了从单点突破到系统性工业化的剧变。本报告基于海量数据与深度调研,围绕思想人物、核心科研、学术论文、领袖观点、工程突破五大核心维度,构建了一份长达两万字的深度复盘报告。分析显示,全球AI产业已形成鲜明的“中美双核”驱动格局,但两者的演进路径呈现出战略性的大分流(The Great Bifurcation):美国以OpenAI、Google、NVIDIA为代表,坚定践行“大力出奇迹”的缩放定律(Scaling Laws),通过构建吉瓦级(Gigawatt)能源设施与万卡集群,试图以绝对的算力霸权构筑通向AGI的护城河;而中国以DeepSeek、阿里Qwen、百度为代表,在硬件受限的背景下,被迫并在事实上走出了一条“极致效率与应用导向”的非对称竞争之路,通过架构创新(如MoE、MLA)与强化学习(RL)的突破,实现了在推理能力上对美方顶级模型的逼近甚至反超。2025年标志着行业从“Chat”向“Act”的代际跃迁。随着推理成本在18个月内下降超过280倍,以及Agent2Agent(A2A)等互操作协议的标准化,AI正从生成内容的“副驾驶”进化为执行任务的“智能体”。本报告将详细拆解这一进程中的关键节点、技术细节与战略博弈。第一章 战略宏图:中美双核驱动下的路径大分流在2023至2025年的周期内,中美两国在AI发展上的顶层设计与底层逻辑发生了根本性的分野。这种分野并非简单的“领先”与“追赶”,而是两种不同资源禀赋下的战略选择。1.1 美国战略:算力霸权与“基建即命运”美国AI产业的核心叙事围绕着“规模”(Scale)展开。在OpenAI、Microsoft、Google和Anthropic等巨头的推动下,美国确立了以基础设施为核心的竞争壁垒。1.1.1 “基建即命运”的战略宣言OpenAI首席执行官Sam Altman在2025年提出的“基建即命运”(Infrastructure is Destiny)成为了美国AI战略的注脚。他明确指出,通往AGI的道路是由芯片、电力和数据中心铺就的,这不仅是技术问题,更是国家安全问题 1。Altman在内部提出的“星际之门”(Stargate)计划及后续披露的宏大目标——到2033年确保250吉瓦(GW)的电力供应以支持AI计算——震惊了全球能源与科技界。这相当于美国当前峰值电力消耗的三分之一,甚至需要启动类似曼哈顿计划级别的国家动员来建设核电站与电网 2。这一战略背后的逻辑是:通过构建天文数字级别的资本与能源门槛,使得AGI的研发成为只有极少数国家级实体才能参与的“皇冠游戏”,从而在物理层面锁定技术优势。1.1.2 资本与算力的正反馈循环美国市场的资本投入呈现出惊人的爆发性。2024年,美国私人AI投资达到1091亿美元,是中国的近12倍 3。这种资金优势转化为对NVIDIA高性能GPU(H100/Blackwell系列)的垄断性采购。Meta首席执行官Mark Zuckerberg宣布建立拥有60万块H100等效算力的庞大集群,为Llama 4的训练奠定了硬件基础 4。美国科技巨头相信,只要Scaling Laws依然有效,堆叠算力就是通往超级智能的最短路径。1.2 中国战略:效率革命与“新质生产力”面对美国的高端芯片禁运与出口管制,中国AI产业无法复 制美国的“暴力美学”,转而被迫在算法效率、模型架构与工业应用上寻求非对称突破。1.2.1 架构创新的“DeepSeek时刻”2024年末至2025年初,DeepSeek(深度求索)的崛起成为中国AI战略转型的标志性事件。DeepSeek-V3及其后的R1推理模型,通过改进的混合专家架构(MoE)和多头潜在注意力机制(MLA),在训练成本仅为美国同类模型几十分之一的情况下,实现了性能的对齐 5。这种“效率革命”打破了“只有万卡集群才能训练顶级模型”的迷信。DeepSeek R1证明了,通过纯强化学习(Pure RL)激励模型进行自我进化,可以在不依赖大规模人工标注数据(SFT)的前提下,激发出强大的逻辑推理能力 7。这一突破被Kai-Fu Lee(李开复)等行业领袖评价为改写了AI发展的范式,证明了在算力受限条件下,算法创新可以弥补硬件短板 8。1.2.2 “应用驱动”与产业内化与美国追求通用的AGI不同,中国更强调AI与实体经济的深度融合。百度创始人李彦宏在2025年多次强调“应用驱动”战略,指出“不要卷模型,要卷应用”。他提出企业应将AI能力“内化”,转化为核心竞争力,服务于制造、自动驾驶、生物医药等实体产业,这与中国政府倡导的“新质生产力”高度契合 10。1.2.3 开源生态的非对称打击中国企业在2024-2025年期间采取了激进的开源策略。阿里巴巴的Qwen(通义千问)系列、DeepSeek系列以及01.AI的Yi系列,通过开源高性能模型(如Qwen 2.5-72B),迅速占领了全球开发者社区 12。这一策略有效地瓦解了美国闭源模型(如GPT-4/5)的商业护城河,将大模型的基础能力商品化(Commodification),迫使全球竞争重心从“拥有模型”转向“应用模型”。1.3 2023-2025 中美AI战略核心对比表维度 美国 (USA) 中国 (China) 核心哲学Scaling Laws (规模定律) Efficiency & Application (效率与应用) 硬件路径无限制获取最先进GPU (NVIDIA Blackwell) 受限硬件下的软硬协同优化 (Ascend, H800) 发展目标AGI (通用人工智能) & 超级智能 新质生产力 & 产业赋能 模型形态闭源主导 (OpenAI, Google) + Meta开源 激进开源 (Qwen, DeepSeek) + 垂直整合 能源观吉瓦级智算中心 (Stargate) 绿色算力与东数西算 关键战役2025: GPT-5.2 / Llama 4 2025: DeepSeek R1 / Qwen 3 第二章 思想人物:观念的碰撞与领袖的抉择在这场技术变革中,关键人物的言论与决策不仅塑造了企业的命运,更定义了行业的价值观。我们观察到三类典型的领袖画像:激进的扩张者、理性的科学家、以及务实的实业家。2.1 扩张者:Sam Altman 与 Jensen Huang2.1.1 Sam Altman:从理想主义到基建狂魔Sam Altman的角色在三年间发生了剧烈转变。早期他以非营利组织的理想主义者面目示人,但在2024-2025年,他成为了全球最大的“算力推销员”。他在《基础设施即命运》的演讲和文章中,将AI竞争上升到文明高度,认为如果不建立绝对的算力优势,民主社会的价值观将无法在AI时代存续 1。他关于AGI将在“数千天内”到来的预言,虽然被部分科学家质疑,但成功地动员了资本市场为OpenAI的万亿级融资买单 15。2.1.2 Jensen Huang:AI工厂的包工头NVIDIA CEO黄仁勋(Jensen Huang)在GTC 2025上进一步固化了他的“AI工厂”理论。他认为,未来的数据中心不仅仅是存储数据的仓库,而是生产“智能”这一新产品的工厂。通过发布Blackwell Ultra和Rubin架构,他实际上定义了AI产业的物理极限 16。他的观点非常直接:算力需求没有天花板, sovereign AI(主 权AI)将促使每个国家都必须拥有自己的AI基础设施。2.2 科学家阵营:LeCun 的世界模型与 Hassabis 的科学革命2.2.1 Yann LeCun:孤独的清醒者Meta首席AI科学家Yann LeCun在2023-2025年期间始终保持着对LLM(大语言模型)的批判态度。他反复强调,LLM只是在进行“自回归预测”,并不具备真正的逻辑推理或物理世界常识。他认为,通往AGI的道路不是更大的LLM,而是“世界模型”(World Models)——即能够像人类或动物一样,在内心模拟物理世界因果关系的系统 18。他在2025年推出的V-JEPA架构,正是这一思想的工程化体现,试图摆脱生成式AI对像素级重建的依赖,转而在特征空间进行预测 21。2.2.2 Demis Hassabis:AI for Science的布道者Google DeepMind的掌门人Demis Hassabis在2024年获得诺贝尔化学奖后,其影响力达到了顶峰。他的核心观点是“AI是科学发现的终极工具”。他预测2025年将是“AI for Science”的爆发之年,AlphaFold 3、AlphaGenome等工具将不仅仅是预测结构,而是开始设计自然界不存在的蛋白质和材料 22。他认为,AI最大的价值在于加速人类的知识发现过程,而非仅仅替代人类的文本工作。2.3 中国务实派:李彦宏、周鸿祎与杨植麟2.3.1 李彦宏:泡沫中的冷静面对百模大战,百度李彦宏在2025年表现出了极大的战略定力。他公开泼冷水,指出“超级应用”尚未出现,并批评行业内对模型参数的盲目追求。他的战略核心是“降本增效”,自豪地宣布文心大模型的推理成本在一年内下降了90%以上,认为这才是AI应用爆发的前提 11。2.3.2 周鸿祎:安全与模型监管360创始人周鸿祎则将关注点放在了安全与“以模制模”上。在2025年的两会提案及多次演讲中,他提出“不发展AI是最大的不安全”,同时针对DeepSeek等开源模型的崛起,提出了利用专业小模型监督大模型、利用知识库校正幻觉的务实方案 25。他认为,AI必须从云端落地到企业私有环境,成为“专业智能体”而非泛泛的聊天机器人。2.3.3 杨植麟与李开复:从理想走向商业落地月之暗面(Moonshot AI)创始人杨植麟坚持“长上下文”(Long Context)是通往AGI的关键路径,他在2025年继续强化Kimi在处理超长文本和无损记忆方面的优势 27。而创新工场的李开复则在2025年做出了重大战略调整,宣布01.AI不再盲目追求训练超大模型,转而聚焦于“AI Agent”和商业化变现,认为2025年是AI企业必须证明自己造血能力的决胜之年 8。第三章 核心科研:从“系统1”到“系统2”的跃迁2023-2025年科研领域最显著的特征,是AI模型从依靠直觉、概率的“快思考”(系统1),向具备逻辑、规划、自我修正能力的“慢思考”(系统2)演进。3.1 推理模型的崛起:OpenAI o3 与 DeepSeek R13.1.1 强化学习激发的推理涌现OpenAI发布的o1和后续的o3模型,标志着“推理链”(Chain-of-Thought, CoT)技术的成熟。与以往通过Prompt诱导模型推理不同,o3通过大规模强化学习,内化了思维过程。o3在ARC-AGI基准测试中取得了88%的惊人成绩,而此前最强模型的得分仅为30%左右,这被视为AI具备了处理未见过复杂逻辑问题的能力 30。3.1.2 DeepSeek R1的技术解密DeepSeek R1的发布(7)不仅是工程上的胜利,更是学术上的里程碑。其核心贡献在于验证了**纯强化学习(Pure RL)**的可行性。• DeepSeek-R1-Zero:研究团队发现,仅通过提供最终答案的奖励信号,不依赖任何人工编写的推理步骤数据(SFT),模型在数千步RL训练后,自然涌现出了自我验证(Self-verification)、反思(Reflection)和长思维链的能力。这种“顿悟”(Aha Moment)现象证明了逻辑推理是模型优化目标的副产品。• 多阶段训练管线:为了解决Zero版本语言混乱、可读性差的问题,R1引入了少量高质量的“冷启动”数据(Cold-start data),并采用了多阶段训练(SFT -> RL -> SFT -> RL),最终在保持推理能力的同时提升了用户体验。• GRPO算法:为了降低训练成本,DeepSeek采用了组相对策略优化(Group Relative Policy Optimization, GRPO),摒弃了传统的Critic模型,极大地减少了显存占用和计算资源消耗,这是其能够低成本复现顶级推理能力的关键 7。3.2 世界模型与物理模拟学术界在2025年终于开始攻克Yann LeCun提出的难题:如何让AI理解物理世界。• Genie 2 & 3:Google DeepMind发布的Genie系列模型,不仅是视频生成模型,更是交互式环境模拟器。Genie 3能够生成可控的、符合物理规律的3D环境,并允许Agent在其中进行长达数分钟的连续操作,具备了物体恒常性(Object Permanence)和因果推理能力 19。• Sora 2:OpenAI的Sora 2在2025年底发布,进一步强化了物理模拟能力,能够精确模拟流体、碰撞等复杂物理现象,被认为是构建通用机器人大脑的重要前置技术 33。3.3 AI for Science:从预测到设计• AlphaFold 3:DeepMind的AlphaFold 3将预测范围从蛋白质扩展到了蛋白质与DNA、RNA、配体等几乎所有生物分子的相互作用,精度大幅提升。这使得药物发现从“大海捞针”变成了“按图索骥” 22。• 材料科学:AI在材料科学领域的应用实现了闭环。通过结合GNoME等模型与自动化实验室,科学家在2025年成功合成了新型超材料(Metamaterials),用于改善5G/6G通信和MRI成像,这一过程中的材料筛选效率提升了数百倍 35。3.4 自我修正(Self-Correction)的局限与突破2025年的多篇学术论文(如37)深入探讨了LLM的自我修正能力。研究发现,在没有外部反馈的情况下,模型很难通过简单的“再想一下”来纠正错误(即内在自我修正的局限性)。但通过**苏格拉底式自我修正(Socratic Self-Refine)**框架,即让模型将复杂问题拆解为可验证的子问题对(Sub-question/Sub-answer),并利用多选题的约束空间,可以显著提升修正的成功率。这一发现为Agent的可靠性设计提供了理论依据。第四章 工程突破:效率革命与经济学重构2023-2025年,AI工程界的主旋律是“降本增效”。摩尔定律在AI领域似乎失效了,取而代之的是更陡峭的“黄氏定律”(Huang's Law)与算法效率带来的超指数级成本下降。4.1 推理成本的“大崩塌”:280倍的跌幅根据斯坦福HAI的报告,从2022年11月到2024年10月,达到GPT-3.5水平的推理成本从每百万Token 20美元暴跌至0.07美元,跌幅超过280倍 39。进入2025年,这一趋势仍在加速,主要驱动力包括:• 架构红利:MoE架构的普及(如DeepSeek-V3、Llama 4)使得模型在推理时仅激活总参数量的5%-10%,大幅降低了计算量 5。• 上下文缓存(Context Caching):Google Gemini和Anthropic Claude引入的上下文缓存技术,让长文档、代码库的重复查询成本降低了90%以上。对于Agent应用而言,这意味着可以将整个企业知识库作为“短期记忆”挂载,而无需每次支付全额费用 41。• 投机采样(Speculative Decoding):以EAGLE-3为代表的投机采样技术在2025年进入生产环境,通过小模型“草拟”Token、大模型“审核”的方式,在不损失精度的前提下将推理延迟降低了2-4倍,极大提升了用户体验 43。4.2 1-bit LLM:计算范式的颠覆微软研究院提出的BitNet b1.58在2024-2025年引发了工程界的震动。该研究证明,将模型权重及激活值量化到极致的1.58比特(即三进制:-1, 0, 1),不仅没有显著损失模型性能,反而因为去除了昂贵的浮点乘法(FP16/BF16),转而使用高效的整数加法,使得能耗降低了70%以上 45。这一突破为在手机、PC等边缘设备上运行高性能大模型打开了大门,威胁到了GPU在推理市场的垄断地位。4.3 互操作协议:Agent互联网的基石随着AI应用从单一对话转向多Agent协作,互操作性成为了工程难题。2025年见证了标准的诞生:• Agent2Agent (A2A) 协议:Google Cloud推出的A2A协议,基于JSON-RPC和HTTP,定义了Agent之间“发现能力”、“协商任务”、“移交工作”的标准流程。它允许不同厂商的Agent(如一个百度的订票Agent和一个Google的日历Agent)进行去中心化的协作 47。• Model Context Protocol (MCP):Anthropic牵头推出的MCP协议,解决了Agent连接数据的“最后一公里”问题。通过标准化的接口,Agent可以即插即用地连接到Google Drive、Slack、GitHub等数据源,无需为每个模型单独开发连接器。这被视为AI时代的USB标准 48。4.4 价格战:API定价的贴身肉搏2025年的API市场呈现出残酷的价格战。DeepSeek率先将高性能推理价格拉低至“白菜价”,迫使巨头跟进。• DeepSeek定价:输入端甚至低至$0.028/百万Token(缓存命中时),这几乎击穿了所有美国竞争对手的成本线 50。• xAI Grok:作为搅局者,Grok 4.1以$0.20/百万Token的激进定价,试图通过价格优势抢占开发者市场 41。• Google与OpenAI的应对:巨头们通过这就Batch API(批处理)提供50%的折扣,并利用Context Caching来留住企业客户,但标准定价仍远高于中国厂商 42。第五章 领袖观点与未来推演:2025及以后5.1 全球模型格局:2025年终盘点到2025年底,全球模型格局已从混乱走向清晰的“阶层化”。5.1.1 美国“三巨头”与开源“马群”• OpenAI GPT-5.2 & o3:依然代表着地表最强战力,特别是在深度推理和泛化能力上,是所有模型的“对齐目标” 51。• Anthropic Claude 4.5:凭借Opus 4.5模型,牢牢占据了“最强写代码”和“最强Agent”的生态位,特别是其Computer Use能力,使其成为企业自动化流程的首选 49。• Google Gemini 3:通过原生的多模态能力和超长上下文(2M+),在处理视频理解和海量文档分析上具有不可替代的优势 22。• Meta Llama 4:Zuckerberg发布的Llama 4系列(包括Scout, Maverick, Behemoth三个版本),彻底确立了MoE架构在开源界的统治地位,不仅性能逼近闭源模型,更通过多模态原生融合,成为了“AI界的Android” 53。5.1.2 中国“破局者”• DeepSeek:以非对称的极低成本和极高推理能力,成为了全球开发者的“平替”首选,甚至在部分数学和代码榜单上超越了GPT-4o,是2025年最大的黑马 6。• Qwen (通义千问):Qwen 2.5/3系列在开源社区的影响力仅次于Llama,特别是在多语言支持和代码能力上,被广泛应用于各类垂直行业模型 12。5.1.3 欧洲“第三极”• Mistral AI:在Mistral 3发布后,这家法国公司继续在“边缘侧”和“隐私合规”上发力。配合欧盟AI法案(EU AI Act)的正式实施,Mistral成为了欧洲政府和金融机构的首选,主打数据不离境和主 权可控 54。5.2 趋势推演:从Chat到Work5.2.1 智能体的寒武纪爆发2025年是Agent的元年。随着o3、R1等推理模型的成熟,以及MCP、A2A协议的普及,AI将不再仅仅是一个对话框。我们可以预见:• 软件形态重构:SaaS软件将逐渐退化为Agent调用的后端API,用户界面将由自然语言交互的Agent接管。• 组织架构变革:企业将开始雇佣“数字员工”。Kai-Fu Lee预言,未来的公司构建将像“搭积木”一样,CEO管理的是一堆拥有不同技能的AI Agent,而非庞大的人类团队 29。5.2.2 科学发现的加速随着DeepMind和OpenAI在科学领域的深入布局,2026年以后,我们可能会看到首个完全由AI设计并验证的药物进入临床试验,或者由AI发现的室温超导材料线索。Demis Hassabis的愿景——AI将科学发现的速度提升10倍甚至100倍——正在变为现实 22。5.2.3 地缘政治的“双循环”中美AI产业将继续在“双循环”中演进:• 美国循环:依赖全球最顶尖的硬件、最庞大的资本投入,追求AGI的理论上限。• 中国循环:依赖极致的算法优化、丰富的应用场景和数据闭环,追求AI在实体经济中的规模化落地。 两者虽然在技术栈上逐渐解耦,但在科学原理上依然紧密纠缠。DeepSeek的论文被美国研究员逐字研读,Llama的代码被中国开发者广泛引用。这种竞争与共生的关系,将是未来十年的主旋律。结语站在2025年的终点回望,我们正处于人类技术史上最激动人心的时刻。AI不再是科幻小说中的概念,而是变成了每秒0.07美元的电力与算力,变成了DeepSeek R1那一行行自我反思的思维链,变成了工厂中不知疲倦优化产线的智能体。在这场伟大的博弈中,无论是美国的“大力出奇迹”,还是中国的“精益求精”,都在共同推动人类文明向着更高维度的智能迈进。基建即命运,但应用才是未来。来源:工业软件产业发展探索

未登录
还没有评论
课程
培训
服务
行家
VIP会员 学习计划 福利任务
下载APP
联系我们
帮助与反馈