一句话,做个花岗岩模型——PFC 6.0 GBM 晶粒模型的全流程自动化
先说结论:我给 AI 写了一个技能,输入只有一句话——"做一个花岗岩颗粒模型,做单轴压缩"。它自己生成了 5 个阶段的 PFC 脚本、跑完全程,最后交给我 6447 个球、32 个 Voronoi 晶粒、5 种矿物的花岗岩试样和一套图:E = 11.8 GPa、峰值强度 38.4 MPa、峰值应变 0.350%,并且晶界入裂率是晶界接触占比的 2.82 倍——晶界确实被优先破坏了。
这篇文章不讲概念,讲一件事:把"花岗岩颗粒模型"这种以前要写一整天脚本的活儿,做成一句话能跑的东西,中间踩了哪几个坑。
1. 一、为什么花岗岩不能当成一块均质材料
用 PFC 做岩石,最省事的做法是整块试样用一种材料、一套胶结参数。做砂岩、做煤,很多时候够用。
做花岗岩就不行了。花岗岩是晶粒集 合体:石英、长石、云母各自成晶,晶粒内部坚硬完整,晶粒之间的晶界是先天弱面。它的很多宏观行为——强度离散、裂纹绕行、晶界优先破坏——都来自"晶粒 + 晶界"这个结构,而不是来自某一条微观参数。
所以要做花岗岩,至少得把三件事表达出来:
晶粒的分区:哪一块是哪个晶粒; 矿物的差异:不同晶粒属于不同矿物,强度刚度不一样; 晶界的弱化:晶粒之间的接触要比晶粒内部弱。
这就是 GBM(grain-based model)要干的事。听起来不复杂,真写起来,光"给每个球分配晶粒号"这一件事就能写崩——直到你发现 Voronoi 分区的定义恰好就是"离哪个种子最近就归谁",而 PFC 的 FISH 里这个循环十行就能写完。
2. 二、这一个技能做了三件事
核心思路:把整条链拆成 5 个可单独检查的阶段脚本,每个阶段跑完存一个 .sav;每个阶段的结尾都挂一道"验证门",把这一步该成立的事打印出来。门不过,就不往下走。
图 1 是这条链的全貌。
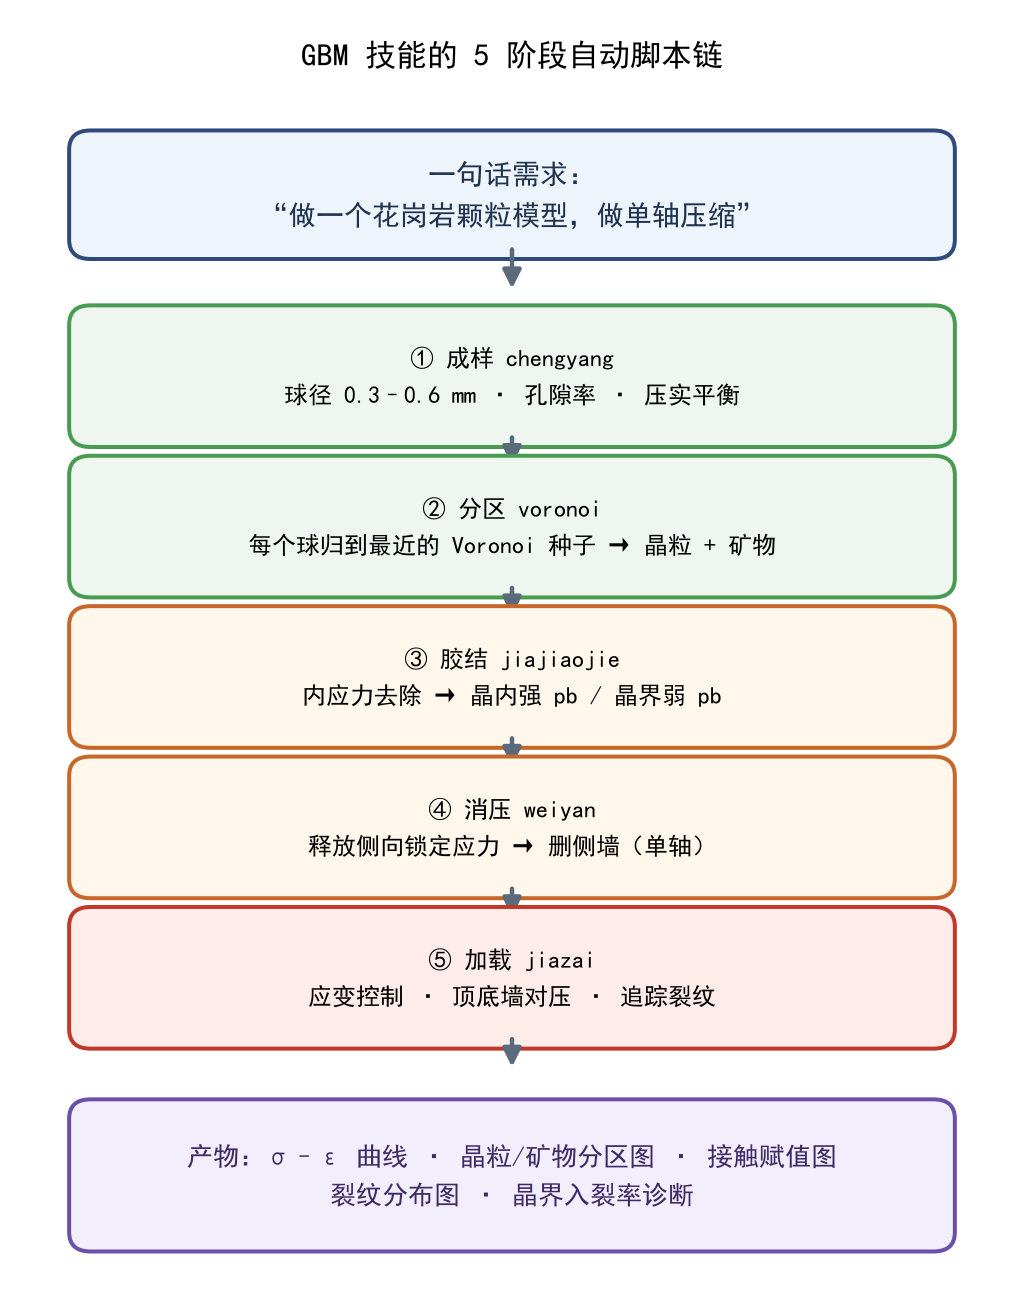
图 1 GBM 技能的 5 阶段脚本链。每一阶段独立存盘、独立验证,前一阶段的门不过就不进下一阶段。
三件事分别落在第 ② ③ 阶段。
2.1 (1)晶粒分区:把 Voronoi 的定义直接抄成循环
Voronoi 分区说白了就一句:球离哪个种子点最近,就归哪个晶粒。种子按六方点阵撒(保证晶粒接近等轴,不是细长的),每个种子再随机抽一个矿物号,晶粒就同时拿到了"身份"和"材料"。
图 2 是分区结果,32 个晶粒、5 种矿物。
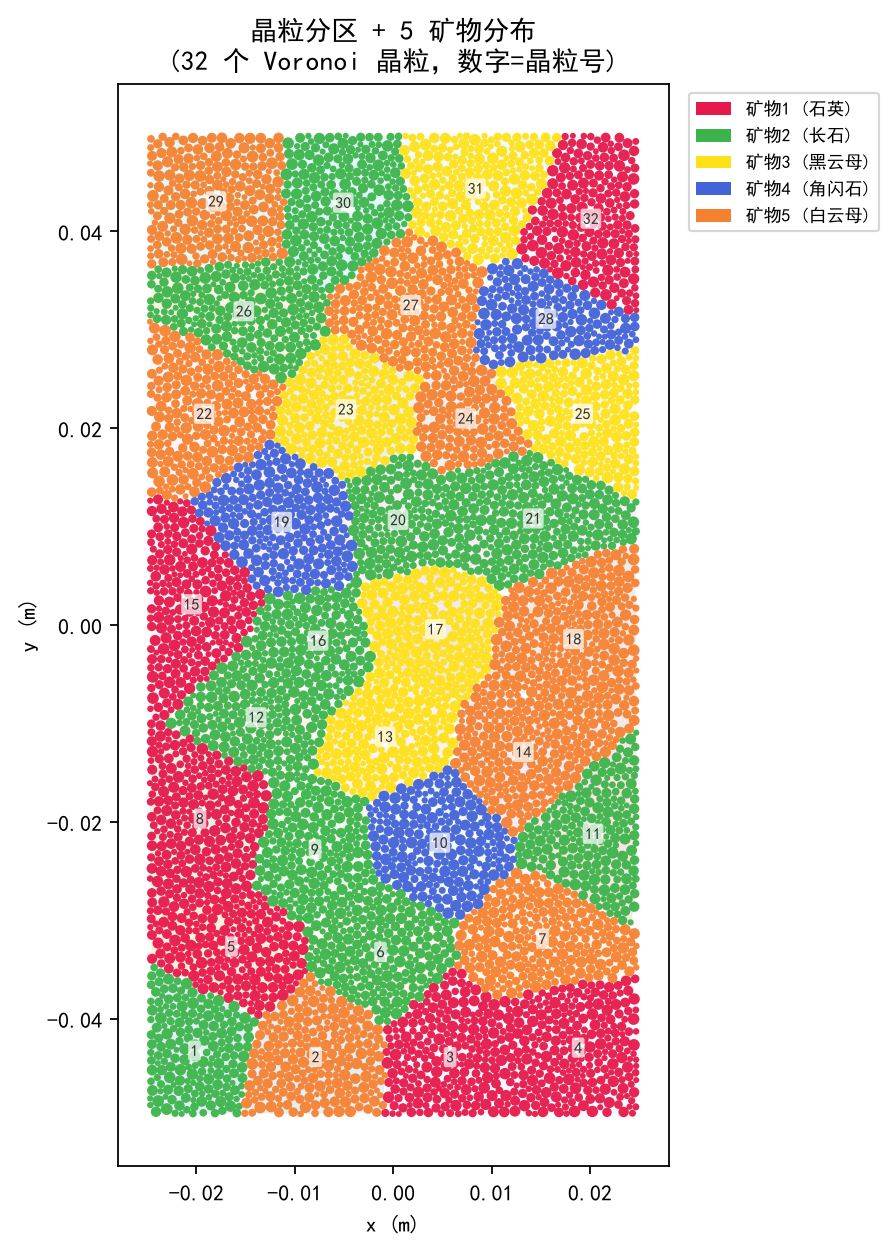
图 2 晶粒分区与矿物分布。32 个 Voronoi 晶粒(数字为晶粒号),颜色为所属矿物:红=石英、绿=长石、黄=黑云母、蓝=角闪石、橙=白云母。共 6447 个球,平均每个晶粒 201 个球。
关键的一步是把晶粒号和矿物号写进球的 group 槽,而不是塞进 ball.extra 或者导出到外部文件再读回来。写进 group 之后,后面所有"选哪些接触"的操作都变成一句声明式的 range group ... matches 2——不需要写 FISH 判断、不需要维护索引表。
2.2 (2)差异化胶结:晶内强、晶界弱
胶结阶段要做的是让晶粒内部用强平行键、晶粒之间用弱平行键,而且晶内还要按矿物再分五档。这样一共是 6 类接触:晶内 5 种矿物 + 晶界 1 类。
这一段的写法全在 range 上:
图 3 是赋值结果的检查图:如果分区或者赋值错了,这张图一眼就能看出来。
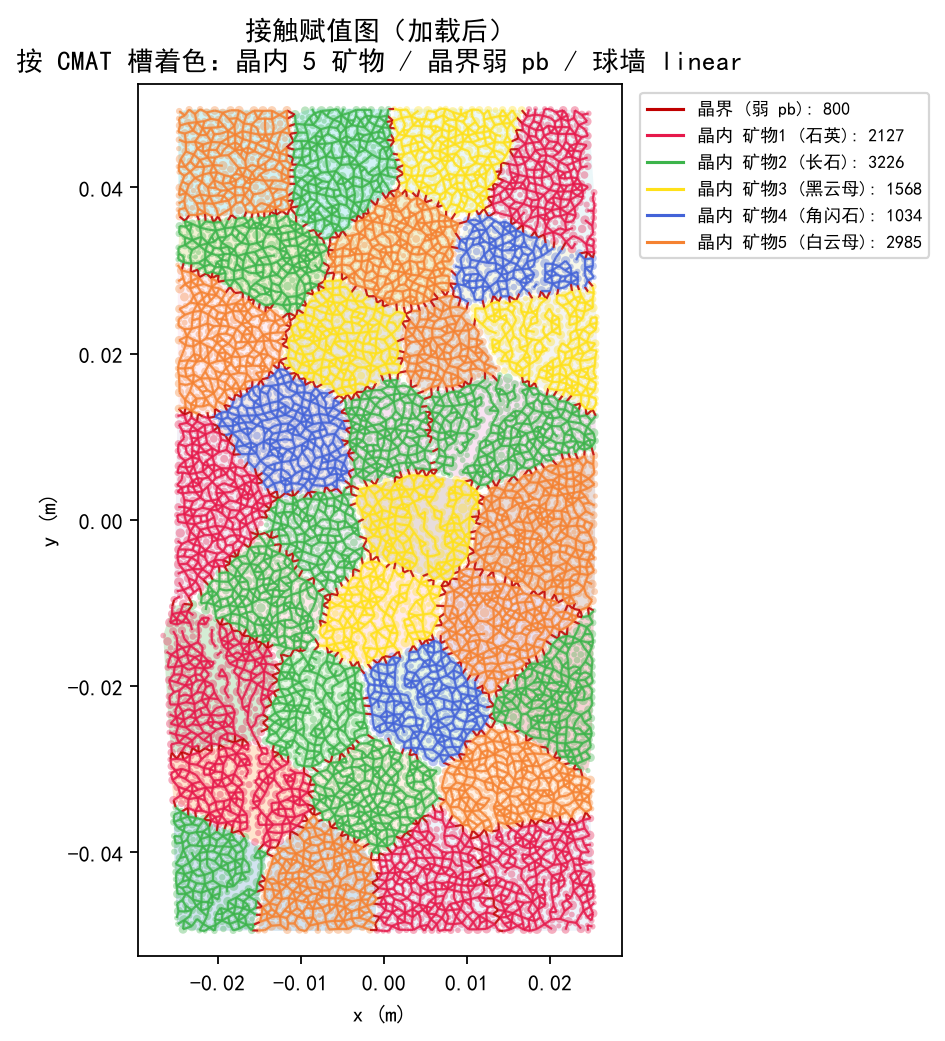
图 3 接触赋值图(加载后)。每个接触按它命中的 CMAT 槽着色:晶粒内部 5 种矿物各一色,晶粒之间是深红色的弱键,球-墙是灰色线性接触。图例里带各类接触的条数。
这一步最有用的一句话是:别只看脚本跑没跑通,要看接触分没分对。脚本能跑通、模型能平衡,但赋值全落在 default 上——这种错到加载阶段才会暴露,而且是"结果不对但看不出哪不对"。
3. 三、跑出来是什么样
图 4 是单轴压缩的 σ-ε 曲线。
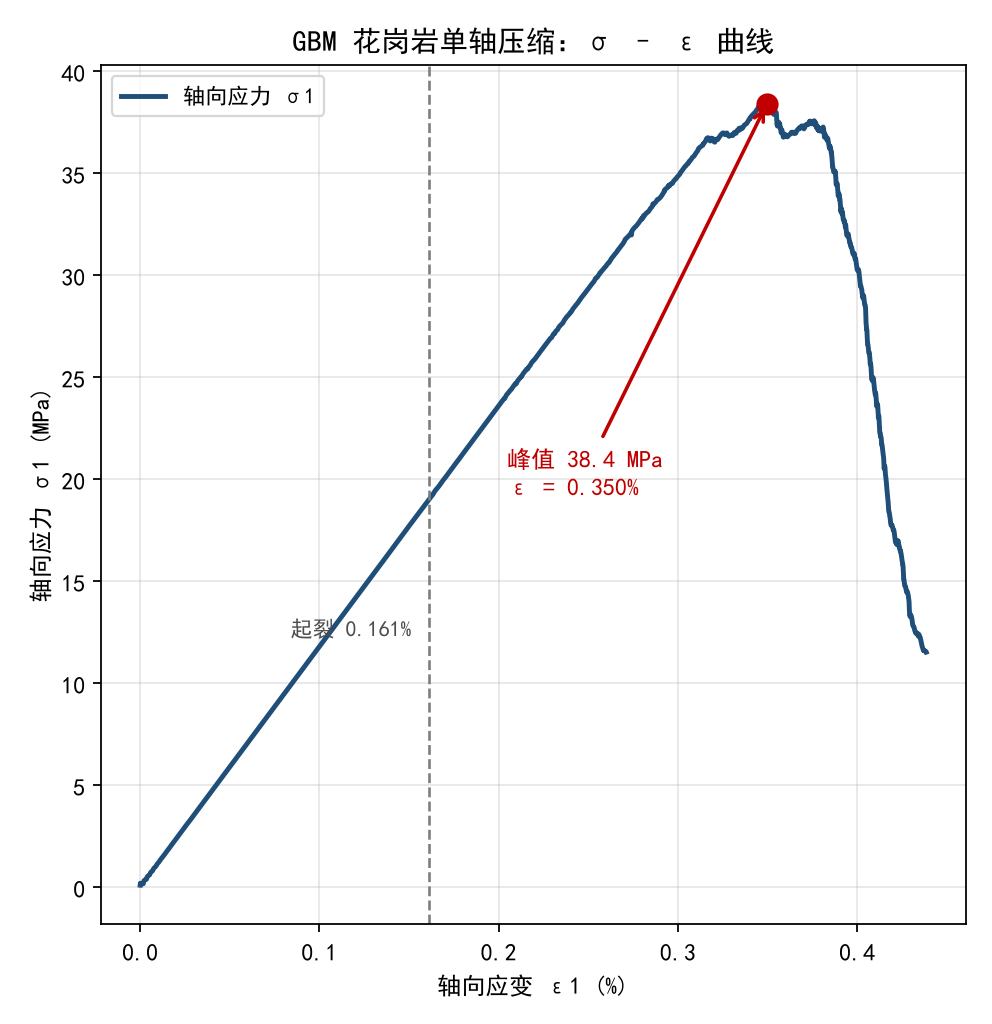
图 4 单轴压缩 σ-ε 曲线。E = 11.8 GPa,峰值 38.4 MPa(ε = 0.350%),起裂点在 ε = 0.161%——起裂远早于峰值,峰值前已经裂了 40% 的应变量。
图 5 是同一组数据里裂纹数随加载的演化。
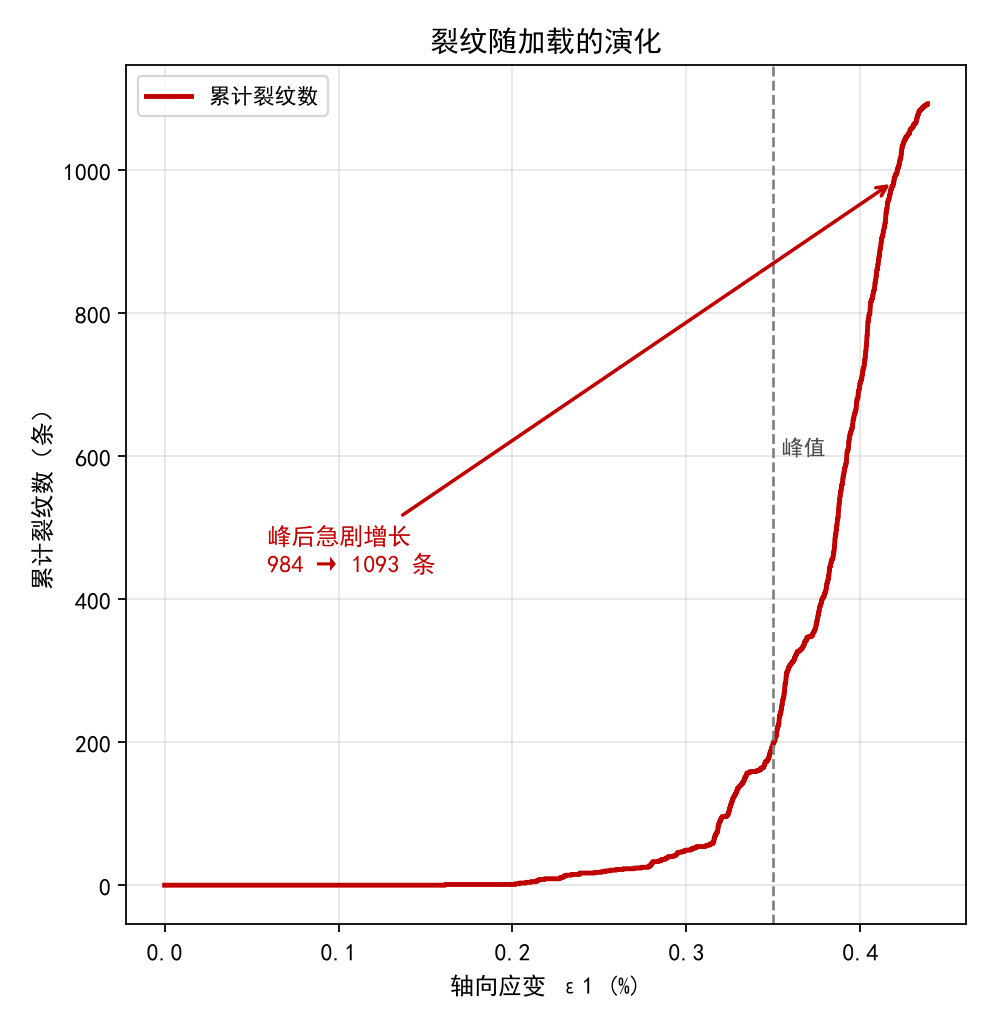
图 5 累计裂纹数演化。起裂后缓慢增长,过了峰值陡然抬升:峰值时约 980 条,加载结束时 1093 条——峰的下降段贡献了绝大部分裂纹。
把裂纹画回试样上(图 6)能看到它们长在哪。
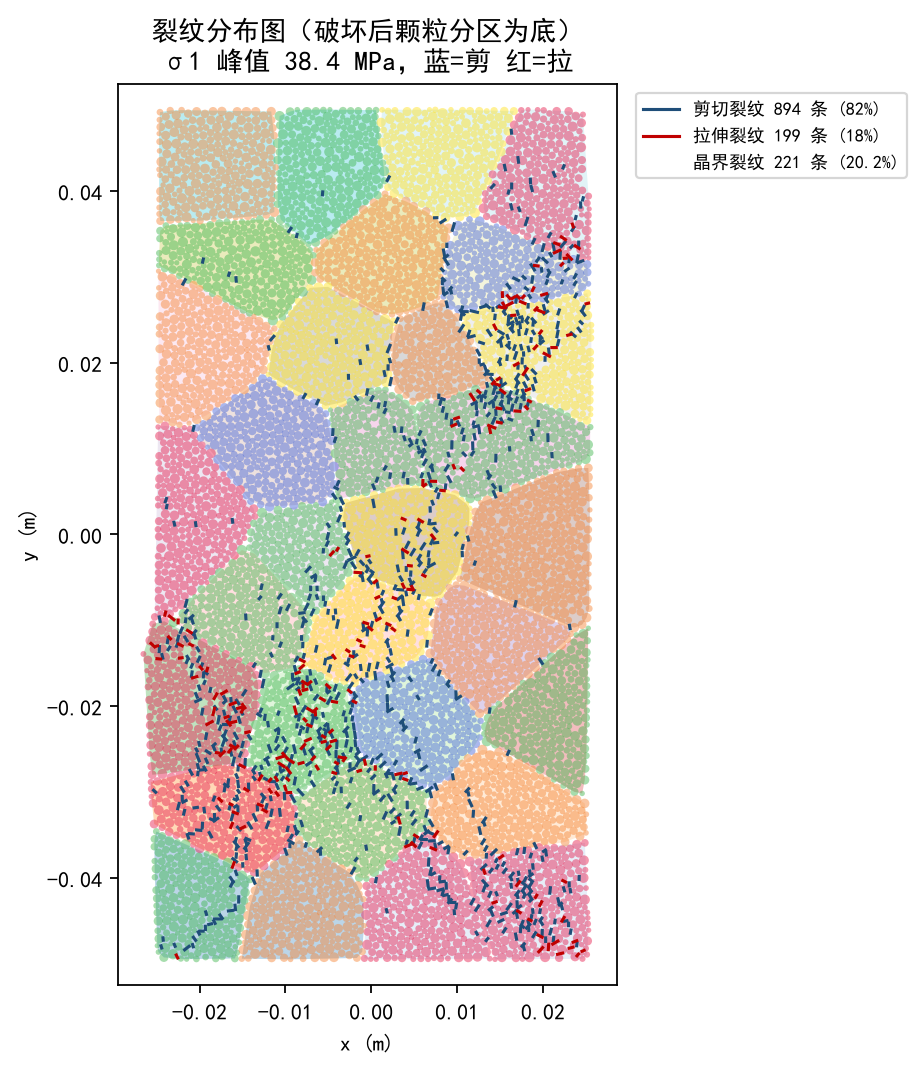
图 6 裂纹分布图,以破坏后的颗粒分区为底。全试样 1093 条裂纹:剪切 894 条(82%)、拉伸 199 条(18%),其中晶界裂纹 221 条。
三点值得注意:剪切裂纹是主控(82%);拉伸裂纹虽然少,但集中在右上和左下两个角落,那里正好是最终贯通的路径;裂纹在几个晶粒里明显扎堆,另一些晶粒几乎没裂。
4. 四、两个诊断指标,比曲线更能说明问题
曲线谁都会看,但"模型到底有没有做出花岗岩的机理"要另外用指标回答。这个技能自带两个。
第一个是晶界弱化诊断(图 7)。
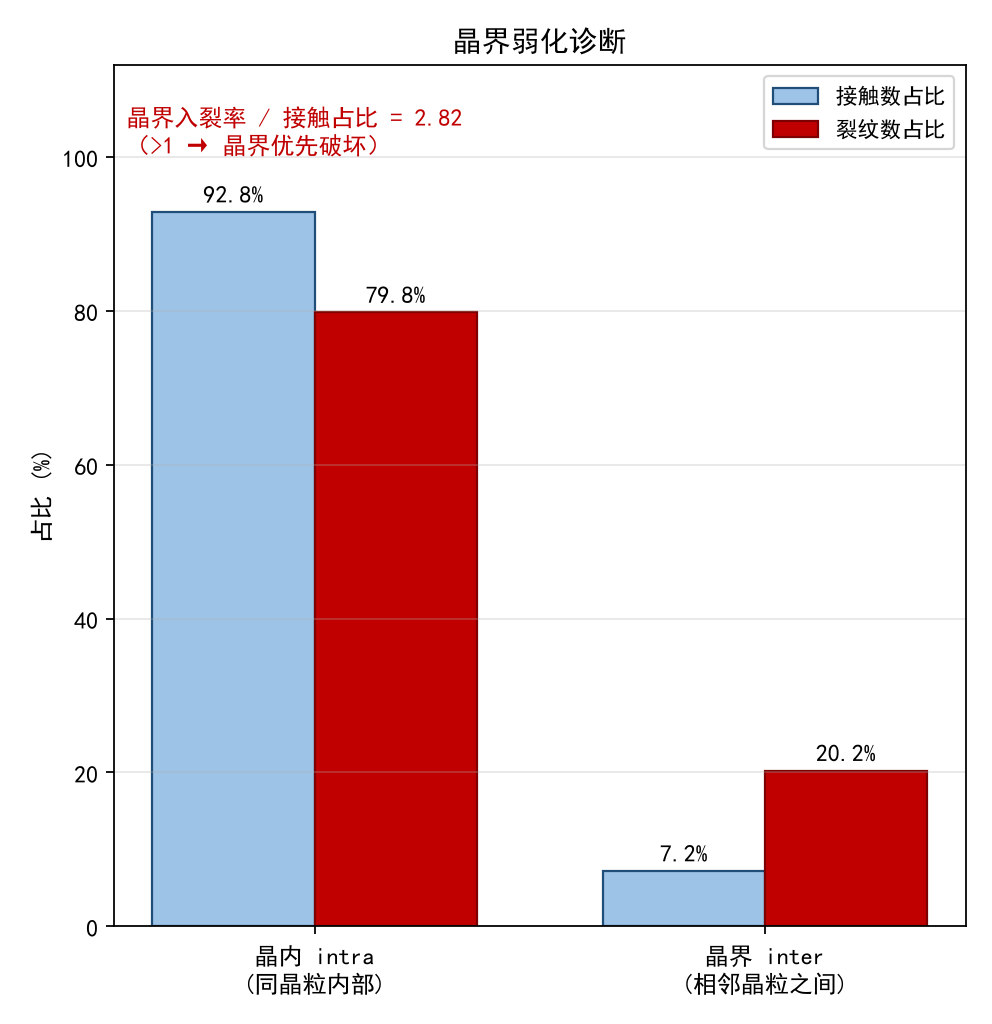
图 7 晶界弱化诊断。晶界只占接触总数的 7.2%,却贡献了 20.2% 的裂纹——比值 2.82,大于 1 就说明晶界被优先破坏。
这个指标的好处是它自带基准。裂纹在哪儿多,可能是因为那儿本来就接触多;所以要拿"裂纹占比"除以"接触占比"再看。比值接近 1 = 裂纹均匀分布(没做出晶界弱化);明显大于 1 = 晶界优先破坏。如果哪天改参数把晶界弱化写丢了,这条曲线会立刻掉到 1 附近。
第二个是拉剪裂纹在晶内外的分布(图 8)。
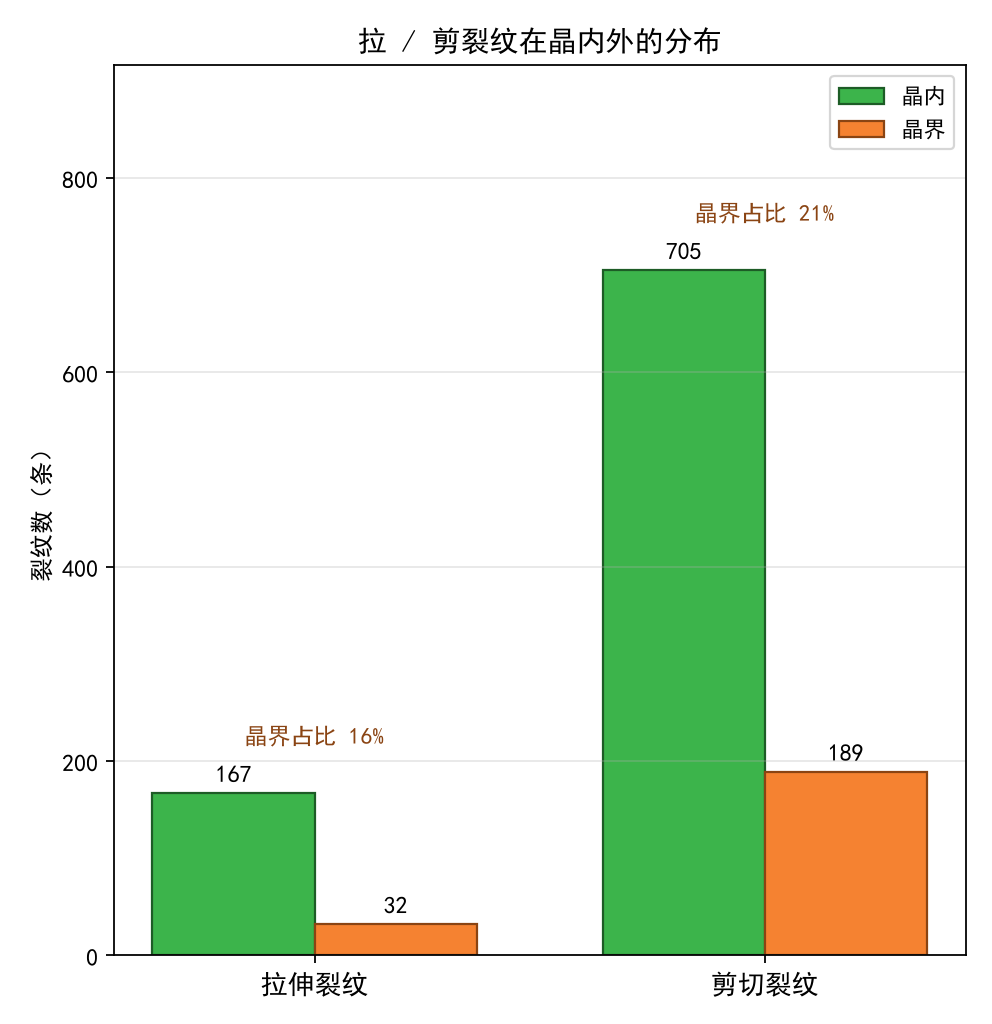
图 8 拉/剪裂纹在晶内外的分布。剪切裂纹里 21% 落在晶界,拉伸裂纹里 16% 落在晶界——两者都高于晶界 7.2% 的接触占比。
这两张图放在一起,才算把"晶界弱化生效了"说清楚。
5. 五、五个坑(这部分比结论值钱)
下面五条都是实机踩过、且不报错的。PFC 在这几种情况下会安静地给你一个能跑但不对的模型。
坑 1:cmat add 会覆盖,而且不继承。
contact cmat default 设好一套参数后,用 contact cmat add ... range ... 给局部换模型时,新条目不会继承 default 的 method 和 property——它是一张全新的空表,你得逐条重新写全。少写一条,那类接触就掉回默认,而日志里一个警告都没有。图 3 那张"接触赋值图"就是为这个坑设的门。
坑 2:ball distribute 的 box 必须内缩约 1 mm。
满幅的 box 会把球顶到试样名义边框的角上,实测二维孔隙率直接掉三分之一(同样 porosity=0.093,满幅 0.099、内缩 0.147)。内缩一圈,球才有地方落。
坑 3:wall servo 目标力为 0 时完全失效。
想做单轴(σ₃ = 0),直觉是用伺服把侧墙力伺服到 0。实测不行:伺服内部按目标力向量归一化,目标是 0 就是 0/0,方向未定义,墙直接钉死——试样实际上变成了侧向不可变形的双轴,σ₃/σ₁ 能到 31%。正确的单轴做法是平衡之后把侧墙删掉,让侧面自由。
坑 4:读间隙要用 contact.gap(c)。
contact.prop(c,'gap')、contact.prop(c,'linear.gap') 这些写法都不存在。FISH 里读接触间隙只有 contact.gap(c) 一个入口。
坑 5:Voronoi 的种子坐标系必须和球的坐标系一致。
球的生成区域中心在原点([-W/2, W/2]),种子如果按角点坐标系([0, W])撒,每个晶粒的最近邻关系都会平移,结果是远端的晶粒一个球都分不到。实测 32 个晶粒里只有 13 个拿到球。这种错表现为"分区图看起来还行,就是稀稀拉拉"——所以第 ② 阶段的门要打印"每晶粒球数的最小值",最小值是 0 就说明踩了。
6. 六、AI 在这件事里干了什么
说清楚一点:上面这些坑是踩出来的,不是 AI 一写就对。区别在于定位成本。
坑 1、坑 5 这类问题——脚本跑完、模型平衡、日志干净,但结果不对——人工排查的常规做法是加探针、二分、一个个 range 试。这次的流程是:AI 先生成一个最小探针脚本(常常只有十几行),跑一次(几秒钟),把判据打印出来对,不对就改探针再跑。它不嫌重复。
技能最后固化的东西也很实在:5 个阶段脚本的生成器、CMAT 赋值的配方、以及那五条坑的规避写法。下次再要花岗岩,这些都不用重来一遍。
诚实声明:本文的算例是方法演示,不是某种真实花岗岩的标定。微观参数(刚度、强度、晶界折减系数)取自本课题组的通用取值,E = 11.8 GPa 与峰值 38.4 MPa 是这套参数下的结果,对着具体工程岩体使用前必须重新标定。晶粒数、矿物比例、球径区间也都是可调输入。
VibePFC 社区 · 一起把 AI 玩进 PFC
我成立了一个 VibePFC 社群,专门聊 AI 怎么落地到 PFC / 数值模拟——让大模型读懂模型、自己改脚本、自动排查"看不懂"的问题。收一个 50 元的门槛费。
想进群的同学,加 QQ 763388012,备注"vibePFC"即可。
参考资料
Itasca Consulting Group. PFC 6.0 Documentation — Contact Model: Linear Parallel Bond; contact cmat、range group命令参考。本文算例(Voronoi 晶粒 + 5 矿物差异化 pb 胶结的单轴压缩)的全部脚本、数据与出图代码由 Claude Code 在 PFC 6.0 环境生成并验证。 晶界弱化诊断方法:以"裂纹占比 / 接触占比"的比值判断晶界是否优先破坏,比值 > 1 表示弱化生效。