
2-50 怎样让模糊 C 均值从随机中心走向更好的聚类中心?
MATLAB 遗传搜索 + 模拟退火框架 + 模糊 C 均值聚类可视化程序
一句话介绍: 这套 MATLAB 程序读取 400×2 的二维样本,用二进制染色体编码 4 个初始聚类中心,通过遗传算法搜索候选中心,再让每个候选中心进入模糊 C 均值迭代,以 FCM 目标函数评价搜索结果,最终输出聚类中心、隶属度矩阵和二维聚类可视化结果。
先看它解决什么问题
模糊 C 均值聚类能够根据样本与各聚类中心之间的距离,反复更新隶属度和中心位置。
问题在于:FCM 的最终结果会受到初始聚类中心影响。
如果一开始的中心位置不理想,局部迭代可能停在不同结果附近。当前程序因此没有只执行一次普通 FCM,而是把“初始聚类中心”本身作为优化变量。
整个主流程可以概括为:
二维样本 → 编码多个候选聚类中心 → 遗传选择/交叉/变异 → FCM 局部迭代 → 目标函数评价 → 温度循环 → 最终中心与隶属度 → 聚类结果可视化
因此,这套程序真正研究的是:
怎样利用群体搜索帮助 FCM 寻找更合适的初始聚类中心。
需要特别说明的是,当前源码虽然加入了模拟退火形式的温度和概率接受代码,但其中存在一个会改变退火行为的符号问题,后文会结合源码具体说明。
1. 当前工程真正由哪些文件组成?
主线并不复杂,真正参与当前聚类流程的文件主要如下。
文件 | 作用 |
|---|---|
SAGAFcmMain.m | 主入口,加载数据并组织遗传搜索、温度循环、FCM 评价和最终绘图 |
ObjFun.m | 把每个候选染色体转换成聚类中心,并调用 FCM 计算目标函数 |
FCMfun.m | 自定义 FCM 主循环 |
initFCM.m / iterateFCM.m | 初始化隶属度、更新中心、更新隶属度和计算目标函数 |
FCMpure.m | 直接调用 MATLAB fcm 的普通 FCM 对照脚本 |
X.mat | SAGAFcmMain.m 实际加载的数据 |
gatbx | 工程自带的遗传算法函数,包括编码、解码、选择、交叉、变异和重插入等 |
2. 当前程序聚类的是什么数据?
主脚本开头执行:load X
因此真正使用的是 X.mat 中的变量 X。
对数据文件直接读取后可以确认:
样本数量:400、特征维数:2
数据矩阵尺寸:400×2
两维数据范围分别约为:
特征 | 最小值 | 最大值 | 平均值 |
|---|---|---|---|
第 1 维 | 0.00118 | 0.99241 | 0.50215 |
第 2 维 | 0.00025 | 0.99995 | 0.50381 |
工程中的 data.mat 也保存了一个名为 X 的 400×2 数组,经过核对,其数值内容与 X.mat 中的 X 相同,但当前主脚本只加载 X.mat。
数据中没有提供真实类别标签,所以这是一个:无监督二维聚类实验。
因此程序可以计算聚类目标函数并画出聚类划分,但不能仅凭当前资料计算“分类准确率”“识别率”之类的有监督指标。
3. 当前默认到底分成几类?
SAGAFcmMain.m 中直接写有:cn=4;
所以当前默认聚类类别数为:4 类
从现有源码看,它并没有 GUI 输入框或命令行交互输入类别数。
如果希望改成其他类别数量,需要直接修改 cn。程序随后会自动按照:
NVAR = m × cn
重新计算待优化变量数量。
当前数据是二维数据,m=2,默认 cn=4,所以:
NVAR = 2×4 = 8
也就是一次候选解需要描述:4 个二维聚类中心,共 8 个连续变量。
4. 为什么不直接使用普通 FCM?
工程实际上已经提供了普通 FCM 脚本 FCMpure.m。
它直接调用:fcm(X,cn,options)
默认仍然是 4 类,并设置:
模糊指数:3、最大迭代次数:20、终止容限:1×10⁻⁶
这条路线可以概括为:
样本 X → FCM 初始化 → 隶属度与中心迭代 → 得到最终聚类结果
而 SAGAFcmMain.m 多做了一层搜索:
样本 X → 搜索初始中心 → 每个候选中心执行 FCM → 根据 FCM 目标值决定候选解好坏
也就是说,遗传搜索并没有取代 FCM。
它优化的是:FCM 从哪里开始迭代。
这也是整个项目最关键的算法关系。
5. 一个遗传算法个体代表什么?
当前程序采用二进制染色体。
主要参数为:
种群规模 sizepop=10、变量数 NVAR=8、每个变量二进制精度 PRECI=10
因此一条染色体长度为:8×10 = 80 bit
程序先使用 crtbp 生成随机二进制种群,再通过 bs2rv 把染色体解码成连续实数。
每个变量的取值边界来源于数据本身:
第 j 维聚类中心坐标范围 = 当前样本第 j 维最小值~最大值
随后 ObjFun.m 把解码后的变量重新整理成:
4×2 聚类中心矩阵
并把这组中心交给 FCM。
因此遗传算法中所谓的“一个个体”,在这个项目里并不是一个类别编号,也不是一条样本,而是:
一整套候选初始聚类中心。
6. 遗传算法怎样更新这些聚类中心?
当前主程序调用的是工程自带 gatbx 中的遗传算法函数。
每一代主要执行:
目标值评价 → 排序适应度 → SUS 选择 → 单点交叉 → 变异 → 重插入 → 新旧个体处理
其中默认参数为:
代沟 GGAP=0.9、交叉概率 pc=0.7、变异概率 pm=0.01
每个温度阶段遗传代数 MAXGEN=10
ranking 根据 FCM 目标值形成适应度;
select('sus',...) 使用随机遍历抽样选择;
recombin('xovsp',...) 执行单点交叉;
mut 执行二进制变异;
reins 再把新个体放回种群。
所以遗传部分的作用主要是:
同时维护多套中心候选,并通过选择、重组和随机变异不断改变搜索位置。
7. 每套候选中心怎样用 FCM 判断好坏?
候选中心进入 ObjFun.m 后,会调用自定义 FCMfun.m。
假设:
xⱼ 表示第 j 个样本;vᵢ 表示第 i 个聚类中心;
dᵢⱼ 表示样本 xⱼ 到中心 vᵢ 的距离;uᵢⱼ 表示样本对第 i 类的隶属度;b 表示模糊指数。
当前:b = 3
程序先根据距离初始化隶属度。可以把关系概括成:
wᵢⱼ = dᵢⱼ^(−2/(b−1))
uᵢⱼ = wᵢⱼ / Σₖwₖⱼ
距离越小,对应类别的隶属度通常越大。
随后根据模糊隶属度重新计算中心:
vᵢ = (Σⱼuᵢⱼᵇxⱼ) / (Σⱼuᵢⱼᵇ)
再计算当前聚类目标值:
J = ΣᵢΣⱼuᵢⱼᵇdᵢⱼ²
这个 J 就是整个搜索过程中真正被最小化的量。
直观上:
样本越靠近它高隶属度对应的中心,J 通常越小。
因此遗传算法并不直接评价中心“看起来好不好”,而是:
候选初始中心 → 完整跑一次 FCM → 用最终 FCM 目标值 J 评价。
8. FCM 自己会迭代多少次?
当前 FCM 参数为:
options=[3,20,1e-6]
分别表示:
模糊指数:3、最大迭代次数:20
相邻两次目标值变化终止阈值:1×10⁻⁶
每一次 FCM 内部迭代执行:
当前 U → 更新中心 → 计算距离 → 计算 J → 更新 U
如果相邻两次目标函数满足:
|Jₖ − Jₖ₋₁| < 1×10⁻⁶
就提前结束。否则最多运行 20 次。
这意味着外层搜索中的一次“个体评价”本身并不便宜,因为每套初始中心都可能触发多次 FCM 更新。
9. 模拟退火原本应该怎样参与搜索?
主脚本定义了:
初始温度 T0=100、冷却系数 q=0.8、终止温度 Tend=1
温度变化关系为:T_new = 0.8T_old
从 100 开始一直迭代到温度不再大于 1,按当前参数一共经历:21 个温度阶段
而每个温度阶段又执行 10 代遗传搜索,因此外层一共组织了:
21×10 = 210 轮遗传迭代
标准的最小化模拟退火中,如果新方案更差,定义:
ΔJ = J_new − J_old > 0
通常应以类似:P = exp(−ΔJ/T)的概率接受。
温度高时更容易接受差解,有利于跳出局部区域;
温度降低后,搜索逐渐趋于保守。
这才是“退火”的核心作用。
10. 当前源码里的模拟退火接受条件有什么需要注意?
这里是当前工程最需要说明的一处源码事实。
对于较差的新个体,SAGAFcmMain.m 实际判断的是:
p <= exp((J_new − J_old)/T)
而进入这个分支时已经满足:
J_new ≥ J_old
所以:
J_new − J_old ≥ 0
进一步得到:
exp((J_new − J_old)/T) ≥ 1
而随机数 p 的范围是 0~1。
因此按照当前源码:
较差的新个体实际上也会被接受。
更准确地说,当前条件下:
新个体更好:直接接受;
新个体相同或更差:退火判断仍然基本必然接受。
所以当前温度并没有真正形成标准模拟退火中的“随温度降低而减少差解接受概率”的机制。
温度在当前代码中的实际作用更多变成了:
控制外层一共重复多少组遗传迭代。
如果要按照标准最小化模拟退火机制进行算法比较,这里的符号应优先核对,较差解接受概率应表现为随 ΔJ 增大而降低,而不是增大。
这会直接影响对“模拟退火改进效果”的解释,因此不能忽略。
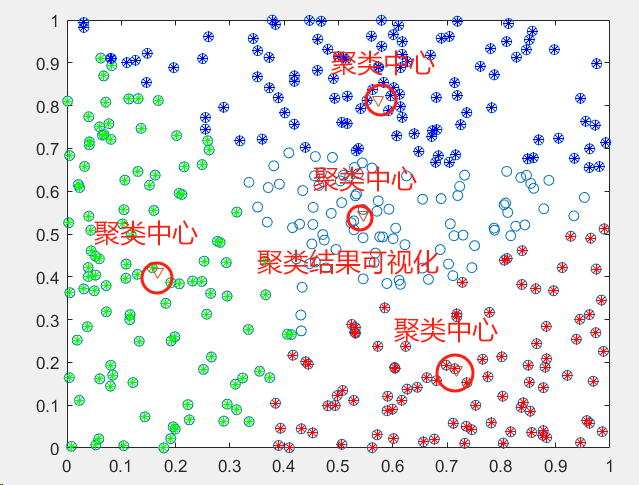
11. 最终程序怎样确定每个样本属于哪一类?
全部搜索结束后,主脚本再次使用最终候选中心运行 ObjFun,得到:
Jb:最终 FCM 目标值;
center:4 个聚类中心;
U:4×400 的隶属度矩阵。
FCM 本身给出的仍然是模糊隶属度。
例如某个样本可能同时拥有:
对第 1 类的隶属度;对第 2 类的隶属度;对第 3 类的隶属度;对第 4 类的隶属度。
绘图时程序再取每个样本最大的隶属度:
类别 = arg max(U)
把模糊结果转换成一个用于显示的硬分类结果。
因此完整关系是:
FCM 模糊隶属度 → 取最大隶属度 → 二维分类可视化
前三类分别额外叠加绿色、红色和蓝色星号;
没有额外星号覆盖的样本就是第四类;
聚类中心则使用 v 型标记显示。
12. 当前程序能不能给出一个固定的“最佳聚类结果”?
不能把某一组中心坐标或目标函数值写成固定答案。
原因有三个。
第一,程序没有固定随机种子。
初始染色体、遗传选择、变异以及退火判断都使用随机数,因此不同运行之间可能出现不同结果。
第二,当前压缩包没有附带一组固定的运行日志或保存后的最终 center、Jb。
所以不能凭空给出一个所谓“最终最优值”。
第三,当前 trace 只有 10 列,而 gen 会在每个温度阶段重新从 0 开始,因此前面温度阶段的跟踪结果会被后面的阶段覆盖。
最终再次执行 FCM 使用的是:
最后一个温度阶段第 10 代所记录的最好候选。
它并没有单独保存整个 210 轮搜索过程中出现过的全局历史最佳解。
所以当前程序更适合观察:
搜索过程如何产生一组聚类中心,并得到对应的 FCM 划分
而不应该把一次随机运行结果包装成绝对固定的全局最优结果。
13.FCMpure.m 在这里有什么价值?
FCMpure.m 提供了一条很有用的普通 FCM 对照路线。
它和主程序使用:
同一份 X;同样的 4 类;同样的模糊指数 3;相近的 FCM 迭代条件。
因此可以分别运行:普通 FCM和遗传搜索框架下的 FCM
观察不同初始化和搜索方式得到的中心及划分。
但当前工程并没有自动计算:
两种方法多次运行的平均 J;标准差;收敛速度;
Silhouette;ARI;NMI;聚类准确率。
因此现有源码只能支持:算法过程与结果可视化比较。
不能在没有补充重复实验和评价指标的情况下直接宣称混合算法“精度更高”或“一定优于普通 FCM”。
14. 这套程序适合用在哪里?
模糊聚类与智能优化教学
程序把:
染色体编码、遗传选择、交叉、变异、FCM 隶属度、中心更新和目标函数
都拆成了可以直接查看的 MATLAB 文件,很适合观察“全局搜索 + 局部聚类”是怎样连接起来的。
二维无监督聚类实验
当前自带数据就是 400×2 的二维矩阵,结果又直接采用二维散点图显示,因此特别适合做小规模聚类可视化实验。
聚类参数敏感性验证
可以修改类别数、模糊指数、种群规模、交叉/变异概率以及温度参数,观察搜索结果和运行量如何变化。
FCM 初始中心优化思路验证
如果研究重点是“FCM 为什么对初始化敏感,以及能否用群体搜索给它提供更好的起点”,这套工程提供了比较完整的实验框架。
它目前不适合直接包装成生产级在线聚类系统,因为:
输入仍然是离线 MAT 数据;
没有数据接口;没有标签评价体系;没有固定随机种子;
当前模拟退火接受式还需要修正后再做正式算法性能比较。
另外,当前 FieldD 的边界排列方式与后面的 reshape(V,cn,ch) 采用了不同的变量排列思路。由于当前两维数据范围都接近 0~1,这个问题不明显;如果以后换成各维量纲差别很大的高维数据,建议同步核对每个染色体变量与各特征上下界的对应关系。
15. 哪些参数最值得修改?
当前程序里真正影响聚类和搜索行为的主要是下面这些参数。
参数 | 当前值 | 为什么值得改 | 调整后的主要影响 |
|---|---|---|---|
cn | 4 | 直接决定聚类类别数量 | 改变中心数量、变量维数和最终样本划分 |
FCM 模糊指数 b | 3 | 决定隶属度的模糊程度 | 越大通常越模糊,越接近 1 则越接近硬聚类 |
sizepop / MAXGEN | 10 / 10 | 决定每个温度阶段的搜索规模 | 增大通常增加搜索量,同时明显增加 FCM 调用次数 |
pc / pm | 0.7 / 0.01 | 控制交叉和随机变异强度 | 影响种群搜索范围与多样性 |
T0 / q / Tend | 100 / 0.8 / 1 | 决定温度阶段数量 | 当前会改变外层搜索轮数;修正退火接受式后还会直接影响差解接受概率 |
PRECI | 10 bit | 决定中心变量的二进制离散精度 | 增大可提高编码分辨率,但染色体也会变长 |
如果只是希望尝试不同聚类任务,最先修改的通常是 cn。
如果研究的是优化算法,则更值得联合观察:
种群规模 + 遗传代数 + 交叉/变异概率 + 温度调度
而不是只改一个参数就判断算法优劣。
16. 怎么运行?
把工程解压后,将 MATLAB 当前目录切换到包含 SAGAFcmMain.m 和 X.mat 的目录。
主程序需要调用 gatbx 子目录中的:
bs2rv、ranking、select、recombin、mut、reins等函数。
因此为了避免 MATLAB 找不到子目录函数,建议先执行:
addpath(genpath('gatbx'))
然后确认 MATLAB 环境中能够调用 FCM 相关的 distfcm。
当前压缩包没有包含distfcm.m,而 FCMpure.m 还直接使用了 fcm,所以运行环境需要提供兼容的 FCM/Fuzzy Logic 相关函数;如果执行到 distfcm 时提示函数不存在,就需要先解决这一依赖。
完成路径和依赖设置后,主入口为:SAGAFcmMain
程序默认加载 X.mat 中的 400×2 数据,并按照 4 类执行聚类。
如果只想运行普通 FCM 对照,则执行:FCMpure
如果更换自己的数据,最直接的方法是保证工作区得到一个:样本数×特征数形式的数值矩阵 X。
对于二维以外的数据,FCM 本身可以按照维数计算,但当前最终绘图只使用 X(:,1) 和 X(:,2),所以仍然只会展示前两个特征;如果不同特征的数值范围差异很大,还应同时重新核对遗传变量上下界的排列方式。
17. 一句话看懂这个项目
这是一个 模糊 C 均值聚类与智能优化实验程序:它读取X.mat中 400×2 的无标签样本,默认划分为 4 类,把 4 个二维初始聚类中心编码成 8 个优化变量和 80 bit 染色体,由 10 个个体通过选择、单点交叉、变异和重插入不断产生候选中心,再让每套候选中心执行模糊指数为 3、最多 20 次迭代的 FCM,以 J = ΣᵢΣⱼuᵢⱼᵇdᵢⱼ² 评价聚类效果,最终输出Jb、4 个中心、4×400 隶属度矩阵并绘制二维聚类结果;工程适合用于 FCM 初始化、遗传优化和无监督聚类教学实验,但当前模拟退火较差解接受式的符号会使差解基本全部被接受,正式做退火算法性能比较前应先修正这一实现并补充可复现实验。


