世界模型真能替代3DGS做智驾闭环吗?

作者:张俊川
编辑:李慢慢
出品:车路漫漫
2026 年年中,NVIDIA 发布了动作条件世界模型 OmniDreams,同时抛出一个很诱人的命题:能不能把 AlpaSim 里那套依赖 3DGS 资产的显式渲染引擎 NuRec 整个换掉,直接让生成式世界模型充当"神经传感器",驱动 Alpamayo 跑端到端闭环?
命题很性感,工程很骨感。
我们在双 A100-80GB 的环境里把这套系统搭了出来:跑了 30 个真实场景的批量闭环,又注入了 10 组反事实长尾样本(暴雪、浓雾、横穿婴儿车、脱缰奶牛……),也顺手摸到了这套架构真实的能力边界。
以下是完整实测记录,所有补丁、调度脚本与评测工具已开源,文末附仓库地址。
先把结论放在前面:
① 雨、雪、雾、眩光这类环境与氛围生成,世界模型已经做到了传统渲染管线难以企及的自然质感;
② 长尾实体交互是阿喀琉斯之踵:冻结权重下,靠贴图和几何约束塞进去的物体,撑不过自回归循环的"脑补";
③ 当前蒸馏版闭环的可信时域只有约 5~8 秒,对鬼探头、Cut-in 这类秒级安全关键瞬态已经够用,长距离巡航仿真还差得远。
01 从"重构回放"到"神经世界模拟"
▍此前的探索:Cosmos 只能做"开环后处理"
2025 年初,NVIDIA 推出面向物理 AI 的世界基础模型平台 Cosmos,当时的定位主要是物理世界视频生成的基座,在自动驾驶仿真里多用于特定场景的受控视频生成与后处理风格迁移。
笔者此前尝试过把 Cosmos 和开源仿真软件 CARLA 结合,做了一套仿真画面的受控图像风格迁移(见 《NVIDIA Cosmos 与 CARLA 仿真画面的风格迁移实践》)。核心思路是利用 Cosmos 的生成先验,弥补游戏引擎渲染管线在光影真实感与传感器噪声分布上的不足。
但这条路线有个绕不开的天花板:它本质上仍是开环后处理。下游生成画面没有接入车辆动力学与控制算法,生成模型本身也感知不到自车轨迹的变化,更谈不上实时响应。
▍AlpaSim + NuRec:基于3DGS 的显示重构仿真基座
2025 年底,NVIDIA 发布了端到端视觉-语言-动作(VLA)框架 Alpamayo R1,创新点在于引入基于思维链(Chain-of-Causation, CoC)的因果推理:模型在输出未来轨迹路点的同时,能给出文本级的驾驶意图解释。
为了评估和训练这套模型,NVIDIA 随之公开了自动驾驶闭环仿真平台 AlpaSim(笔者之前在网络上发布过解析 AlpaSim 底层代码与微服务架构的技术视频)。它采用解耦的 gRPC 微服务拓扑,把自车策略(Driver)、车辆动力学控制(Controller)、地面物理相交(Physics)、交通流仿真(Trafficsim)与传感器仿真(Renderer)分立运行。
AlpaSim 原生推荐的图形引擎是 NVIDIA 神经重构渲染引擎 NuRec(NRE),底层是三维高斯泼溅(3DGS):
1. 采集真实路测车队的激光雷达与多视角相机数据(如 NuRec 数据集中的 .usdz 场景包);
2. 离线重建环境背景的几何体与高斯点云资产;
3. 闭环仿真时,根据自车与动态障碍物的空间位姿,调用 GPU 渲染传感器视角画面。
NuRec 的时空几何一致性和照片级质感都没得说,但它本质上是一种基于显式资产重构的回放式渲染管线。一旦仿真要超出采集工况——突发恶劣天气、极端光照变化,或者引入采集数据里根本不存在的罕见障碍物——静态 3DGS 资产就很难低成本地泛化和扩展了。
▍OmniDreams:把世界模型变成传感器
2026 年中,NVIDIA 发布了面向自动驾驶仿真评估的动作条件世界模型 OmniDreams(论文:arXiv:2606.03159)。它基于 Cosmos 架构做了深度的闭环适配,有三个关键特性:
强动作条件化|支持以高精地图拓扑、自车未来轨迹及其他交通参与者的 3D Bounding Box 为精确条件,逐块(Chunk-by-chunk)自回归合成传感器画面;
低延迟前向推理|轻量级 VAE + 蒸馏扩散调度器,能以较高帧率连续流式输出多视角高分辨率图像;
反事实场景编辑|理论上支持通过文本提示与首帧条件引导,在维持道路几何拓扑的前提下,直接生成雨、雪、雾、眩光等极端天气变体和各类长尾交通参与者。
于是有了这个核心命题:能否彻底替换掉 AlpaSim 中依赖 3DGS 资产的 NuRec,直接由 OmniDreams 充当虚拟世界传感器,驱动 Alpamayo(R1 及 1.5)完成端到端闭环仿真?
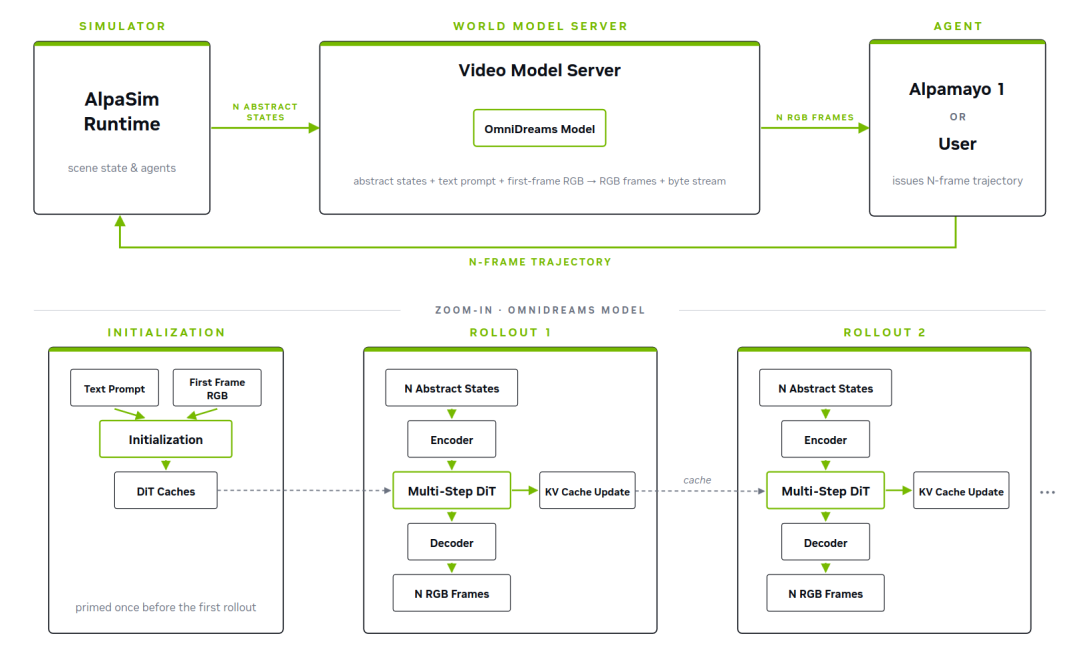
OmniDreams + AlpaSim 闭环 Pipeline(图源:OmniDreams 论文 Figure 6,展示世界模型作为神经渲染服务与仿真状态机的交互闭环)
如上图所示,当策略模型的输出轨迹实时输入给世界模型,世界模型即时扩散渲染出下一帧视觉观测并反馈给策略模型——自动驾驶测试就此从"重构回放"跨进了"神经世界模拟"。
▍本文 做了什么
基于上述设想,笔者在双 NVIDIA A100-80GB 环境下搭建并验证了 OmniDreams × AlpaSim × Alpamayo 端到端闭环仿真系统,分两个阶段推进:
Stage 1 基础闭环与批量验证:打通双卡微服务拓扑(GPU 0 跑 Driver 策略、GPU 1 跑 OmniDreams 渲染),从 VaVAM-B 策略的分层打通,到 Alpamayo-R1,再到最新的 Alpamayo 1.5(8B VLM + 动作扩散头),完成单场景与 30 场景批量闭环测试,并系统记录运行时性能与延迟。
Stage 2 反事实长尾场景探索:基于同一基础场景,设计 10 组涵盖极端天气/光照(暴雪、暴雨、浓雾、眩光)与长尾障碍物(横穿婴儿车、路肩轮椅、道路动物、施工路障等)的反事实变体矩阵,探索首帧编辑、多帧重贴与局部 Latent Patch 的注入路径,并复盘生成模型在长时域闭环下的能力边界。
接下来先拆解闭环系统的底层架构与数据流。
02 闭环系统的架构与数据流
把生成式世界模型接进闭环仿真,不是调一个视频生成接口那么简单:仿真引擎、策略模型、车辆动力学与神经渲染器必须在严格的时间基准与坐标系契约下协同推进。整套系统由 AlpaSim 编排核心、OmniDreams 神经渲染服务、Alpamayo 1.5 驾驶策略三部分构成。
▍双卡微服务解耦拓扑
受限于显存容量与依赖隔离,系统采用 gRPC 微服务架构,计算负载被物理隔离在两张卡上:
GPU 0(策略与仿真域):Docker 编排的 AlpaSim 核心容器组——自车策略(driver-0)、动力学控制(controller-0)、地面贴合(physics-0)与集中调度引擎(runtime-0);
GPU 1(世界模型生成域):独立 OmniDreams 宿主机进程,承载约 2B 参数的 Cosmos DiT 扩散模型与轻量编解码管线,监听独立 gRPC 端口。
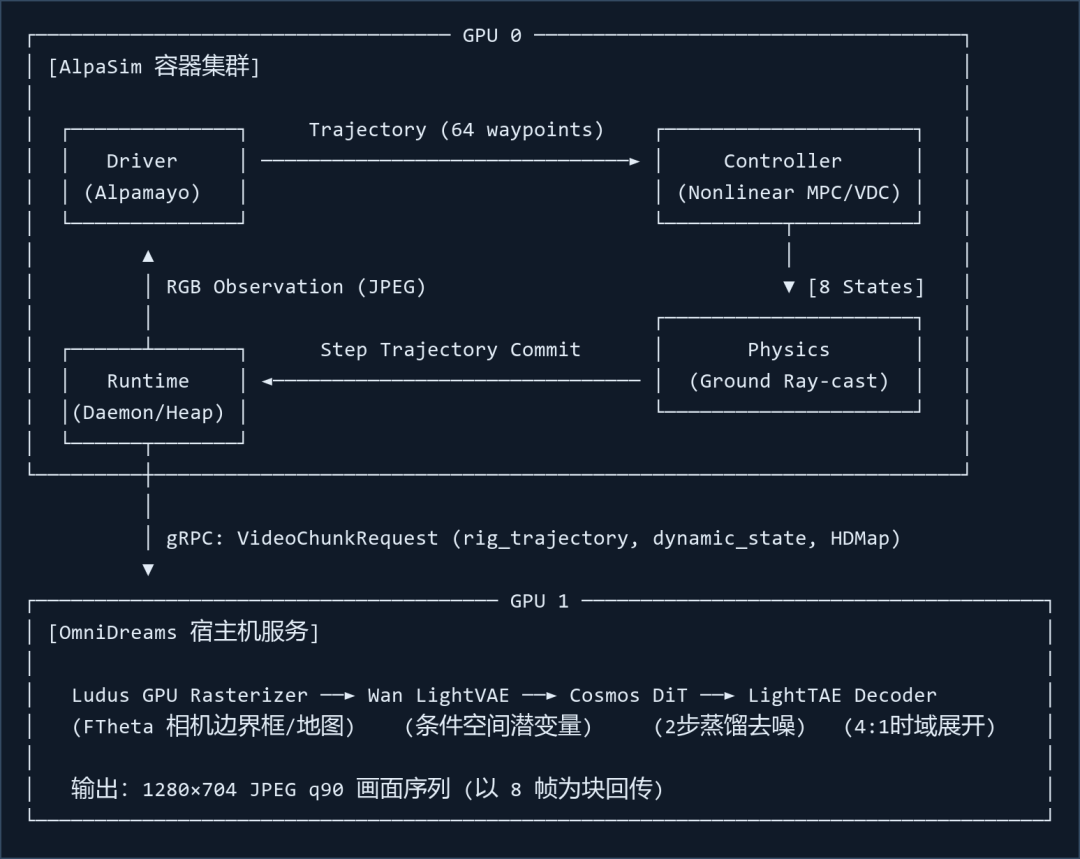
双卡微服务拓扑:GPU 0 运行 AlpaSim 容器集群,GPU 1 运行 OmniDreams 神经渲染服务
微服务间通信全部基于 proto3 协议、一问一答(Unary RPC),没有显式内存共享:video_model.proto 负责 Runtime 与 OmniDreams 的渲染接口,egodriver.proto 负责向 Alpamayo 提交观测并触发决策,controller.proto 负责把轨迹转换为线控指令。
▍调度核心:事件堆与 266.664 ms 控制步
AlpaSim 里没有传统仿真那种硬编码的"每帧全局循环"。整个闭环由一个按(仿真时间戳、优先级)严格排序的异步事件堆(Event Heap)驱动:
# alpasim_runtime/event_loop.py while event_queue: event = event_queue.pop() await event.handle(state, event_queue)
系统定义了多级固定事件优先级(10~90)。在以 8 帧为一个渲染块(8-frame chunking)的闭环配置下,仿真时间以 266.664 ms(8 × 33.333 ms)为一个标准控制步展开。一个典型控制步内,事件按如下顺序级联执行:
Priority 10VideoModelFrameEvent ×8
OmniDreams 前序渲染完成的 8 帧图像拆为逐帧事件,经 submit_image_observation 异步推入 Driver 端的图像缓存队列。
Priority 20PolicyEvent
批量提交自车最新位姿与动力学状态、提交导航路线参考点;然后执行观测屏障——await drain_outstanding_tasks() 强制等待本步 8 张图像传输确认完毕;最后调用 driver.drive(),拿到 Alpamayo 输出的局部规划轨迹。
Priority 40ControllerEvent
把参考轨迹变换至控制刚体坐标系,用非线性 MPC(CasADi / do_mpc)解算前轮转向角与加速度,经 8 状态非线性自行车动力学模型积分出未来 8 个微步的物理位姿。
Priority 50PhysicsEvent (EGO)
自车位姿输入 Physics 容器,Warp 内核对高精网格发射双向垂直射线拟合地表平面——只修正 z 轴高度与俯仰/横滚姿态,绝对保留 x、y 平移坐标,防止车辆悬空或陷入地面。
Priority 60-70TrafficEvent / Physics
推进背景交通流(本项目用 skip 回放模式,直接插值真实采集的参与者位姿)并完成地表贴合。
Priority 80StepEvent
状态提交点:把动力学演化与贴地修正后的最终真值轨迹写入状态机全局历史,广播 ActorPoses(落盘至 .asl 审计流),重置本步临时上下文。
Priority 90VideoModelPrefetchEvent
取出刚提交的自车未来位姿与背景障碍物位姿,组装成 VideoChunkRequest,异步向 OmniDreams 请求下一块 8 帧画面,进入下一轮流水线。
Force-GT 强制接管预热|每个场景的前 2.033 s(约 7.6 个控制步)为强制真值回放阶段(force_gt):期间完全不调用驾驶模型推理,直接用数据集录制的真值轨迹驱动车辆与渲染器,让世界模型的 KV-cache、动力学状态积分器和画面自回归流平滑进入稳态,避开启动瞬态抖动。
▍OmniDreams:结构化条件驱动的神经渲染
作为渲染端,OmniDreams 本质上是一个以高度结构化世界状态为输入、以自回归扩散为核心的图像序列生成器。它不做游戏引擎式的三维光照计算,而是学习了"物理空间几何投影 → 高保真传感器画面"的映射。每块渲染请求接收四类条件:
· 高精地图(HDMap):会话初始化时注入的矢量地图,含车道中心线、虚实线边界、停止线与人行横道;
· 自车运动轨迹(rig_trajectory):未来 8 个离散时间戳下的自车相机坐标系三维外参位姿矩阵;
· 动态障碍物三维状态(DynamicWorldState):各参与者的 3D 边界框尺寸、类别标签(小汽车、卡车、行人、骑行者等)及位姿轨迹;
· 前置图像种子(Seed RGB):前一块生成的最后一帧 RGB 像素,作为时域自回归的生成基准。
生成管线(基于 flashdreams 框架)的内部算子链如下:
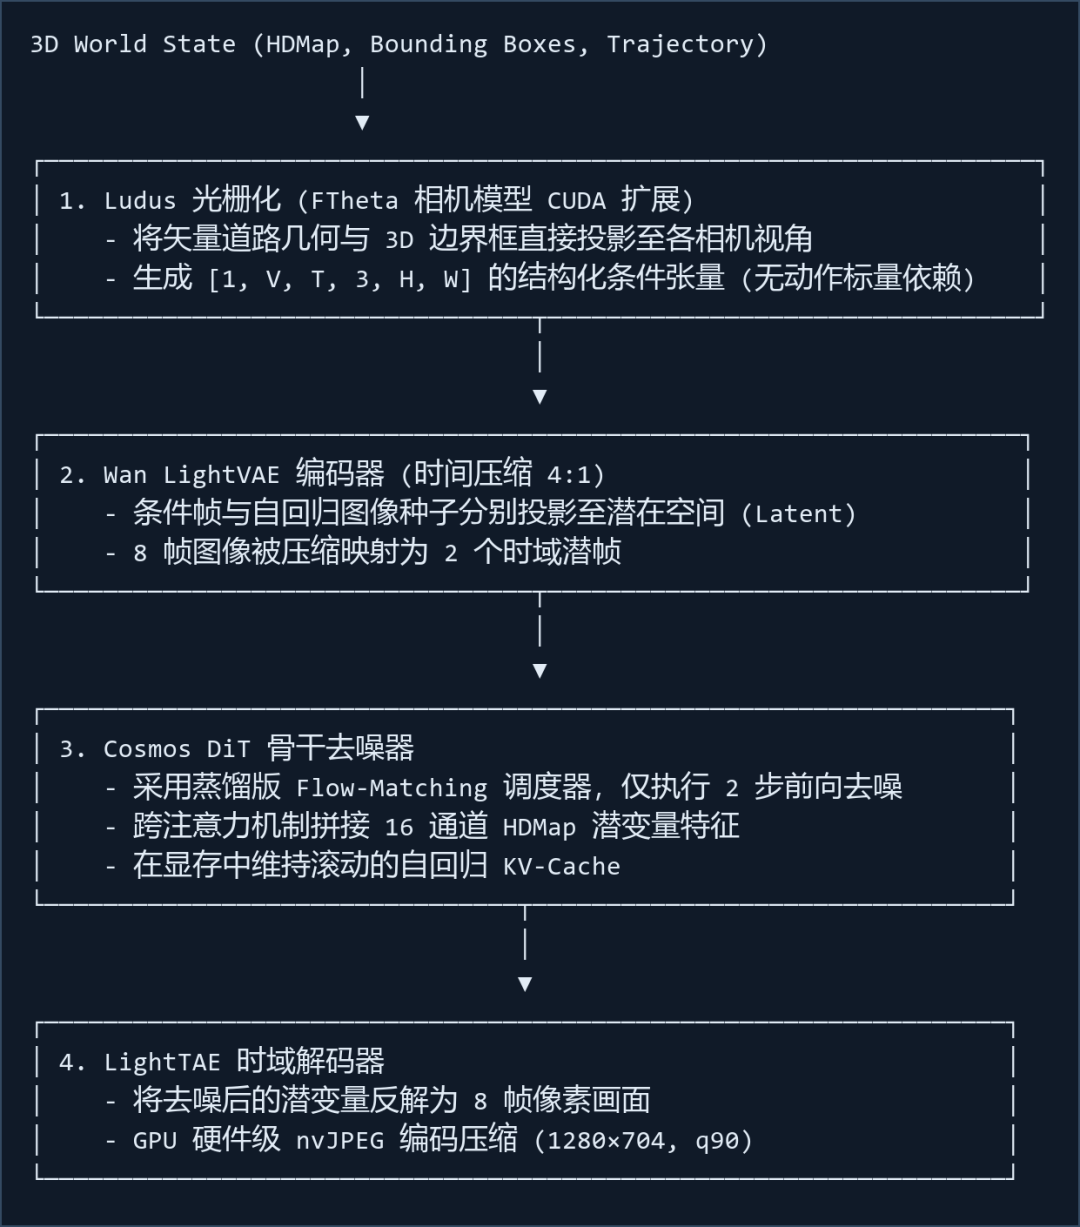
OmniDreams 前向生成管线:光栅化条件 → LightVAE 编码 → DiT 两步去噪 → LightTAE 时域解码
值得注意的是,OmniDreams 生成的图像严格保持为标准单目前视 RGB,输出端不含隐式深度图、语义分割或点云等副产物。
▍Alpamayo 1.5:会"先想后做"的决策大脑
闭环另一侧,Alpamayo 1.5 是自车的决策大脑:一个典型的推理型 VLA,由负责高层语义推理的多模态大模型(VLM)与负责连续轨迹生成的专家扩散头组成。每个控制步被 Runtime 唤醒时,它收到打包为 PredictionInput 的观测集 合:
· 前视图像历史:最近 4 帧历史图像,时域按因子 3 降采样(覆盖约 0.4 s),输入保持原生 uint8 张量,不做 ImageNet 归一化;
· 自车历史运动状态:过去 16 个离散步(覆盖 1.6 s,间隔 0.1 s)的三维位置、偏航角、线速度模长与纵向加速度;
· 导航先验指令:由全局路径点解析的文本级导航指令(如"直行""在路口左转");
· 时序连续性先验:上一决策轮选定的轨迹,用于维系跨步动作平滑。
推理分两个阶段:
阶段一|因果推理链生成(VLM 认知层)
以 Cosmos-Reason2-8B 为多模态语言基座,把视觉特征与系统 Prompt 拼接,自回归解码出可解释的因果链(CoC)文本,例如:
"Nudge left due to a stopped vehicle blocking the right side of our lane"(右侧车道有占道停放车辆,向左轻微借道绕行)
阶段二|专家扩散头动作采样(执行层)
模型不直接输出标量方向盘转角,而是在基于单车模型的动作空间内对加速度 a 与道路曲率 κ 建模:专家模型以 VLM 的多模态表征为条件,运行 Flow-Matching 扩散采样对未来动作分布去噪,再经运动学递推展开为未来 6.4 s 内 64 个高精局部航点(10 Hz)。
这 64 个航点打包为 DriveResponse 回传 Runtime,完成闭环映射:坐标系对齐 → 非线性 MPC 解算转向角与油门/制动 → 物理模型积分新位姿 → 新位姿随 VideoModelPrefetchEvent 输入 OmniDreams,生成下一段画面。
至此,从感知画面输入、因果思维链推理、动作扩散生成、动力学积分,到新视点画面渲染,一个完整的自主闭环轮回成型。下一节进入实测。
03 闭环复现与工程实测
▍基础设施:一条铁律
硬件为 2× NVIDIA A100-SXM4-80GB、32 逻辑核 CPU、94 GB 内存,Ubuntu 22.04,宿主机驱动 580.178.04(原生支持 CUDA 13.0)。
自动驾驶仿真涉及数十 GB 的大模型权重、场景 USDZ 资产和 Docker 镜像,直接塞根分区(通常只有 100~200 GB)很快就会爆盘。所以我们立了一条铁律:根分区只留 Git 代码,所有重数据一律转移到独立的 500 GB 数据盘(挂载于 /mnt),工作区用软链接保持路径解耦:
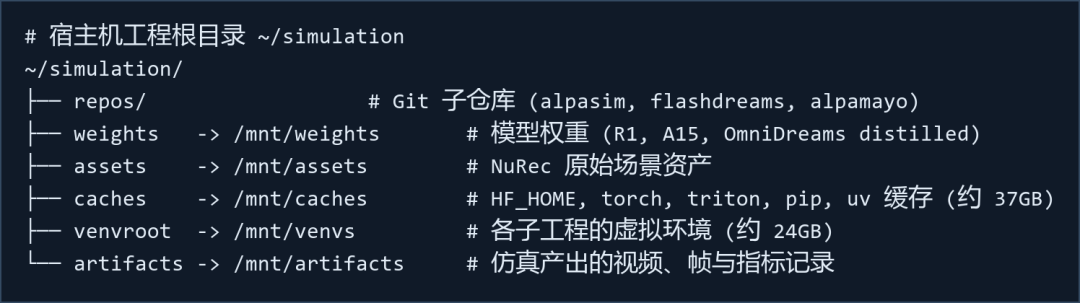
宿主机工作区布局:代码在根分区,权重/资产/缓存/产物全部软链到数据盘
另外,Docker 的存储根目录必须显式迁移到数据盘:修改 /etc/docker/daemon.json 中的 "data-root": "/mnt/docker-data",否则构建 12 GB 的 alpasim-base 镜像时系统盘就会被挤爆。
▍批量调度:为什么必须强制串行
单场景打通后,我们设计了自动化批处理管线,从 NuRec 官方数据集选取了 30 个从未参与测试的独立街景场景(Revision 26.01,地理位置彼此分散)。
这里有个底层约束:OmniDreams 服务全局只维护一个活动视频生成会话(Active Session)。一旦收到新的 start_session,服务端会先执行 Cleaning up N existing session(s) 销毁旧会话——多场景并发时,后续任务会直接抹掉前置任务的会话,导致其在调用 render_video_chunk 时触发 Session not found 崩溃。
因此批量脚本必须显式覆盖 AlpaSim 的默认并发分配,实现单次启动 Wizard、模型单次常驻载入、30 场景严格顺序推进的纯串行架构:
# scripts/run_batch_a15.sh 核心覆盖逻辑 uv run --project src/wizard alpasim_wizard \ deploy=external_video_model topology=1gpu \ driver=alpamayo15_1cam_local \ runtime.nr_workers=1 \ runtime.endpoints.renderer.n_concurrent_rollouts=1 \ runtime.endpoints.driver.n_concurrent_rollouts=1 \ runtime.endpoints.physics.n_concurrent_rollouts=1 \ runtime.endpoints.controller.n_concurrent_rollouts=1 \ runtime.endpoints.trafficsim.n_concurrent_rollouts=1 ...
整套 30 场景批量闭环耗时约 1 小时 44 分钟(全程无需重启 Driver 容器与 OmniDreams 渲染进程),平均每个 20 秒场景的闭环测试约 3.45 分钟。
▍闭环效果:眼见为实
以下是 Alpamayo 1.5 在 OmniDreams 驱动下的典型闭环记录:画面底部是世界模型实时渲染的前视相机视图,上部是 AlpaSim 状态机解算的高精鸟瞰轨迹与遥测指标。
▍30 场景评测:一半场景"开出路面"
对 30 个场景的原始运行记录(metrics.parquet)做全量逐帧解析,Alpamayo 1.5 的总体表现如下:
· 整体行驶进度(Progress)中位数 0.92,平均行驶距离 158.83 米;
· 碰撞检测累计激活 11 个场景(163 帧),出路面检测激活 21 个场景(342 帧);安全监控模块(Safety Monitor)全程未触发干预。
53% 的场景"开出路面"这个数字值得展开。复盘逐帧记录时,我们还观察到一个非常有趣的现象——思维链与动作执行的脱节:
Alpamayo-R1:嘴上让行,脚下撞人
在人行横道前,R1 连续 5 个推理步输出 "Yield to the pedestrian in the crosswalk…"(前方横道有行人,停车让行)。但底层 Flow-Matching 动作头给出的纵向速度全程钉死在 8.5 m/s,毫无制动响应,径直撞向行人。这说明早期 R1 架构的语言思维链与低层控制轨迹之间存在明显的语义-动作脱节(CoT-Action Disconnect)。
相比之下,Alpamayo 1.5 的言行一致性明显更好:当文本输出"向左借道绕行"时,控制器能精准检测到底层微小、平滑的左向横向偏移。它发生碰擦的本质原因是环境感知裕度不足与空间几何推理缺陷,而不是意图脱节。
▍性能剖析:瓶颈在哪,一目了然
仿真时间轴设定为标准 30 fps(单帧理论间隔 33.333 ms),8 帧为一个控制步长(单步仿真时域 266.664 ms)。稳态运行期间高频采样与时序反解的结果如下:
把一个标准步拆开看,时序依赖非常清晰:
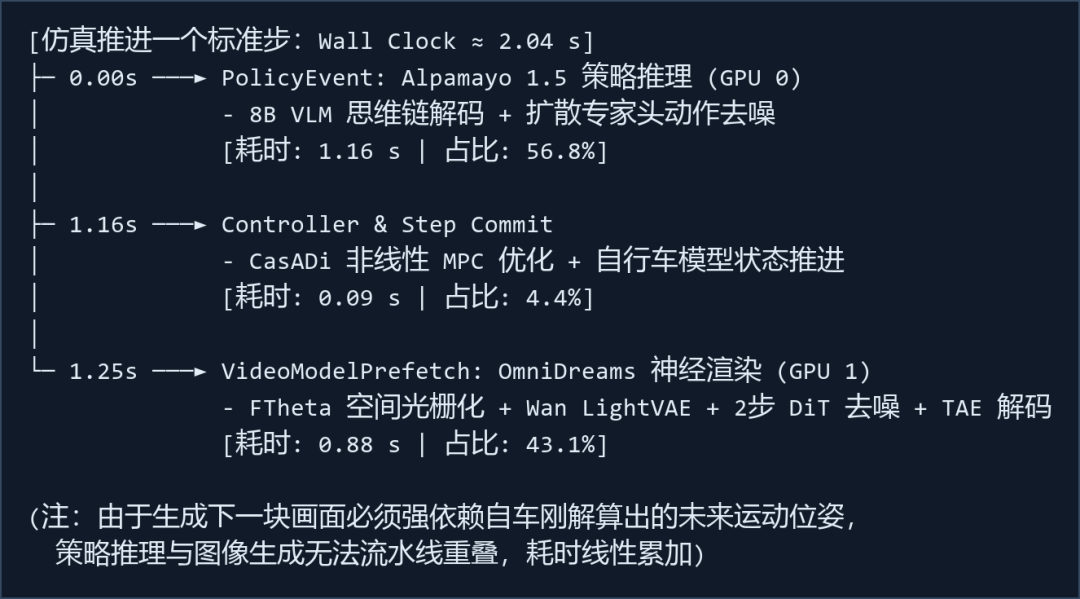
单步执行时序分解(Wall Clock ≈ 2.04 s):策略推理占 56.8%,神经渲染占 43.1%
由于生成下一块画面必须强依赖自车刚解算出的未来运动位姿,策略推理与图像生成无法流水线重叠,只能串行累加。渲染器自身明明有 9.1 fps 的并发能力,但在强闭环数据流里被迫"等人",有效闭环帧率因此跌到约 3.9 fps。
硬件资源方面,稳态峰值的占用如下:
· GPU 0:显存 22.9 GiB / 80 GiB(Cosmos-Reason2-8B 权重与 KV 缓存);算力瞬时 100%、均值约 8.7%,脉冲式计算;
· GPU 1:显存 37.2 GiB / 80 GiB(模型常驻 22.9 GiB,前向峰值 37.2 GiB);算力瞬时 100%、均值约 17.4%;
· 系统内存:宿主机实测约 14.6 GB / 94 GiB,非常宽裕;容器 Cgroup 加总约 26.8 GiB(各容器独立映射公共 CUDA 库页,存在重复计量);
· 并发线程:全机活动线程 2851(基线 2266),净增约 585 个,主要来自 PyTorch 内部算子线程池;
· 磁盘:单场景 .asl 日志约 230 MB / 20s,评测产物约 5 MB,30 场景批量总落盘 5.4 GB,完全可控。
也就是说,在两张 A100-80GB 的支持下,瓶颈不是显存或内存容量,而是两个大模型串行推理带来的时延累加。
基本闭环跑通、性能基线摸底之后,更有挑战性的问题自然浮出水面:既然世界模型能生成逼真的常规街景,它能否按人类意图,生成现实采集车极难捕捉的极端反事实长尾场景(暴雪、浓雾、横穿婴儿车……)?这就进入了 Stage 2。
04 反事实与长尾:能力、妥协与边界
常规路况跑通闭环,只验证了世界模型作为"神经传感器"的基础可行性。它对比传统显式 3D 重建引擎(NuRec)最大的理论优势,在于反事实生成与长尾数据合成——不需要真实外场重新采集,就能人为合成现实中极难捕捉、高危险性的 "What-if" 场景。
Stage 2 基于同一条真实城市道路(clipgt-02eadd92),构建了 1 个零干预基线 + 10 个反事实变体的测试矩阵:
· 环境与光照(v01–v04):暴雪(Blizzard)、深夜暴雨(Night Rain)、黎明浓雾(Dense Fog)、日落强眩光(Sunset Glare);
· 长尾参与者与障碍物(v05–v10):突发横穿的婴儿车(Stroller)、路肩行驶的轮椅(Wheelchair)、占道静止挖掘机(Excavator)、脱缰奶牛(Cow)、路面施工障碍物群(Debris)、台风复合灾害(Typhoon + Fallen Branch)。
▍天气变体:首帧编辑 + 文本自回归,一次成功
按照 OmniDreams 论文 §9.3.1,可控环境编辑的核心机制是:由修改后的首帧 RGB 种子锚定静态结构与环境基调,再由文本提示词引导时域自回归传播。我们据此搭建了"首帧 + 文本"的联合编辑链路:
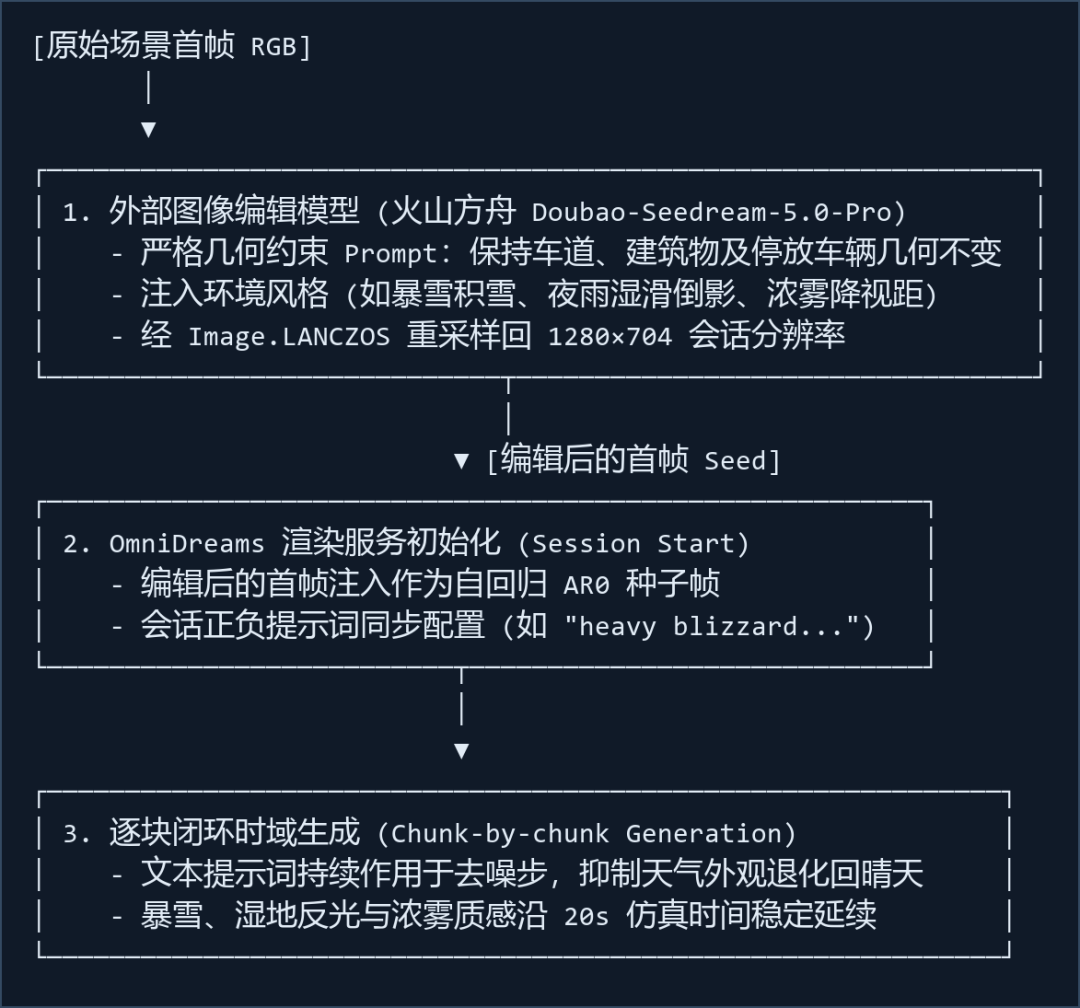
天气变体注入链路:外部编辑模型改首帧 → 作为 AR0 种子初始化会话 → 逐块生成时用提示词抑制"褪色"
这套机制彻底解决了模型对天气提示词钝化的问题:在 20 秒全流程仿真里,暴雪变体(v01)的路面积雪、浓雾变体(v03)的低对比度近景、深夜暴雨(v02)的路灯湿地倒影都保持了很高的时间一致性,没有向原片晴天退化。
工程严谨性声明|上述天气与光照变体属于纯视觉表现层扰动(Visual-only)。AlpaSim 底层物理引擎与车辆模型中,并未建立轮胎-路面附着系数降低、积水滑水(Hydroplaning)或传感器硬件光度衰减的动力学方程。这类评测只能检验策略模型在恶劣视觉退化条件下的感知与决策反应,不能据此声称车辆经历了低附着路面的动力学失稳。
▍插入 Actor:四个阶段,四堵墙
天气变换主要考验生成模型的全局纹理迁移,而往场景里凭空插入一个原本不存在的动态或静态物体(推婴儿车的行人、路中奶牛、路障),直接挑战的是世界模型对三维空间几何、掩码遮挡与时序因果性的建模底线。
整个插入 Actor 的过程是一条环环相扣的问题链——每突破一个瓶颈,下一个底层缺陷就浮现出来:
↑ ↓
阶段四 · 历史污染 ← 阶段三 · 动态淡出
(激活时刻位姿对齐) (首帧 RGBA 投影锚定) (多帧生成逐帧重贴) (局部 Latent Patch)
▍为什么做到极致还是崩:回到论文找答案
工程上把信号一致性做到极致之后,全量 20 秒闭环的逐帧审看暴露了更深刻的硬伤:没有任何一个插入 Actor 的变体,能完整维持 20 秒符合物理常识的高保真视觉流。这必须回到 OmniDreams 论文 §9.3 的理论原点去找答案。
论文把长尾合成能力严谨地分成两套范式:
§9.3.1 受控场景编辑(环境与布局)|光照、天气与分布内物体的空间重排,明确标注无需重训(without retraining),靠"首帧编辑 + 提示词引导 + 几何条件图"即可平滑实现。
§9.3.2 分布外物体建模|罕见动物、超大异形障碍物等。论文明确批驳了朴素注入:"直接在首帧 RGB 图像中编辑插入分布外物体然后生成整段视频,往往会导致视觉伪影与不一致的动力学,因为这些物体并未在世界地图中被表征,且与空间中的动态立体框条件存在冲突……"论文给出的解法是执行轻量级定向后训练,在训练集中设计随机动态立体框丢弃策略(Randomized dynamic-cuboid dropout),强迫模型学会在缺乏 3D 框指导时,仅凭视觉历史推断并维持物体的物理持续性。
而本项目的根本妥协在于:受限于开源社区仅发布了蒸馏版 2B 推理权重,加上算力有限,修改模型结构与重训练被明确列为排除项。于是我们试图用极致的"四维条件信号一致性"(像素贴图 + 3D 立方体 + 轨迹时间窗 + 提示词)去模拟论文里靠权重微调才能获得的物体认知先验。这带来了两类不可调和的模型级失效:
失效模式 A|模型自造续演体,然后失控巨型化
世界模型不是贴图容器。在去噪步中,冻结的模型会把贴入的异形物体边缘解释成一个三维生长的表面,并在自回归循环中自主"脑补"它认为合理的延伸结构:在静止挖掘机场景(v07),模型在第 2~3 秒从挖机后方延伸出一条巨大的暗色机械吊臂——这部分结构既没有红色种子、也不在预设边界框足迹内,背景消除无法触及,于是在后续潜空间迭代中指数级膨胀,第 5 秒演化为横跨整条街道的悬空巨型拱门。奶牛场景(v08)里,牛身向后被拉成一堵蠕动的毛皮巨墙;路面杂物场景(v09)里,木箱与塑料桶几秒后增殖为占据半幅路面的大型抽象木质框架。
我们针对 v07 做了三轮几何包络种子抑制实验,结果是一个双侧夹逼的死结:背景消除模板保守,脑补的异形结构必然逃逸放大;模板激进放大,平整的背景填充潜变量自身又会长出新的巨型立柱。缺乏定向微调的世界模型,在长时序下无法理解未见物体的正确拓扑边界。
失效模式 B|连基线也在漂移:内在的长时域几何软化
更意外的发现来自零干预基线(v00)的复盘:即使完全不做任何 Stage 2 干预,OmniDreams 在该场景推进到第 6.6 秒(约 199 帧)左右,画面就会自发出现不可逆的几何软化——路边停放的汽车轮廓开始粘连溶解,清晰的树干逐渐肿胀为巨型立柱,第 8 秒后前景路面鼓起大片抽象的防水布状褶皱。也就是说,受制于 2 步极速蒸馏与缺乏 CFG 强约束,模型自回归潜变量循环在该场景下的稳定有效时域上限本身就只有 6~8 秒左右。
05 写在最后:现实与未来
Stage 1 与 Stage 2 完整跑下来,可以给生成式世界模型在自动驾驶仿真测试中的现状下一个客观、清醒的定性:
1. 环境与氛围生成:范式突破。雨、雪、雾、眩光这类全局光影与视距干扰,世界模型表现出传统三维渲染难以比拟的自然质感;"首帧联合编辑 + 自回归文本引导"让批量衍生高保真恶劣天候仿真集的成本变得极低。
2. 长尾实体交互:阿喀琉斯之踵。冻结权重下,仅凭外部几何与图像拼贴,无法赋予模型对未见物体的长时序动力学常识;未经定向微调的模型在自回归迭代中极易几何形变逃逸。
3. 真实可用时域:约 5~8 秒。当前蒸馏版闭环的高置信度窗口大致维持在这个区间——对突发鬼探头、紧急切入(Cut-in)等秒级安全关键瞬态评测,已经具备很高的实战价值;数十秒乃至数分钟的长距离巡航仿真,还需要底层生成网络在时域漂移抑制机制上继续演进。
生成式世界模型为自动驾驶测试推开了一扇通往无限反事实世界的大门,而如何跨越从"画面逼真"到"物理与时空几何自洽"的深水区,是这个领域下一阶段最核心的命题。
本文为「车路漫漫」原创内容,转载请保留出处。