
2-46 一段 5 秒声音里,怎样用短时能量和过零率找到语音端点?
MATLAB 短时幅度 + 短时能量 + 短时过零率 + 双门限端点检测程序
一句话介绍: 这套 MATLAB 程序读取 sound2.wav,先把声音分成重叠短帧,计算短时幅度、短时能量和短时过零计数,再利用高低能量门限、过零门限以及静音持续长度组成状态机,自动寻找第一段有效语音的起止位置,并把检测结果直接标记在波形、能量和过零特征上。
先看它解决什么问题
一段声音直接画成完整波形后,可以看到哪里“有变化”,但如果希望程序自动判断:
哪一段只是背景静音;哪一段可能开始说话;
哪一段已经确认进入语音;中间很短的停顿是不是语音结束;
很短的突发噪声要不要当成有效语音;仅靠肉眼观察就不够了。
当前程序采用的是一条很典型的语音端点检测路线:
声音读取 → 幅值归一化 → 分帧 → 短时幅度/短时能量 → 短时过零计数 → 自适应调整能量门限 → 状态机判断 → 输出语音起止位置
它没有训练模型,也没有随机过程,整个结果都由当前音频、分帧参数和检测门限确定。
1. 当前工程里真正有什么?
项目编号为 46,当前压缩包中的核心工程非常精简:
文件 | 作用 |
|---|---|
main.m | 主入口,依次完成短时幅度/能量分析、短时过零分析和语音端点检测 |
enframe.m | 分帧函数,把一维声音切成若干重叠帧,每帧占矩阵一行 |
sound2.wav | 当前程序默认分析的声音数据 |
其中 main.m 是直接运行入口,enframe.m 已随工程提供,因此不需要再单独寻找分帧函数。
当前算法本质上是确定性的:
同一份sound2.wav+ 同一组参数 → 得到同一组检测结果。
2. 当前分析的声音数据是什么?
工程自带的 sound2.wav 实际属性为:
项目 | 当前数据 |
|---|---|
时长 | 5 s |
采样率 | 44100 Hz |
声道 | 单声道 |
位深 | 16 bit |
总采样点 | 220500 |
也就是说,程序面对的不是一个已经切好的语音片段,而是完整的 5 秒声音序列。
在短时能量和端点检测阶段,源码还会执行:
x = x / max(abs(x));
把最大绝对幅值归一化到 1 附近。
这样做的意义很直接:后面的能量门限不再强烈依赖原始录音的整数幅值范围。
3. 为什么不直接分析整段声音,而要先分帧?
声音是随时间变化的。
如果直接对 5 秒信号计算一个总能量,只能得到整段声音有多强,却不知道:
哪一个时间位置开始变强,哪一个位置又重新变弱。
因此程序使用 enframe.m 把长信号切成许多短帧。
前两部分分析采用:
帧长 FrameLen = 240、帧移 FrameInc = 80
在 44100 Hz 采样率下,相当于:
每帧约 5.44 ms、相邻帧前进约 1.81 ms、重叠 160 点,重叠比例约 66.67%
对当前 220500 点音频,最终得到 2754 个完整帧。
端点检测部分又换成:
帧长 FrameLen = 256、帧移 inc = 90
对应约:
每帧 5.80 ms、每次前进 2.04 ms、重叠比例约 64.84%
因此后面的判断不是逐个采样点进行,而是在一系列短时间窗口上进行。
4. 程序怎样计算短时幅度和短时能量?
第一部分先对归一化声音分帧。
对于第 m 帧,源码实际计算了两个量。
短时幅度:
Aₘ = Σₖ |xₘ(k)|
短时能量:
Eₘ = Σₖ xₘ(k)²
两者看起来相似,但关注点不同。
短时幅度是这一帧内所有采样绝对值的累加,可以反映这一小段声音总体有多“强”。
短时能量使用平方后累加,大幅值采样会获得更大的权重,因此语音活跃区域与静音区域通常会拉开得更明显。
按当前 sound2.wav 和源码等价复算,在 240 点帧长、80 点帧移下:
特征 | 当前最大值 |
|---|---|
短时幅度 amp1 | 约 104.0585 |
短时能量 amp2 | 约 61.7975 |
这些数值的价值不在于单独判断“好或坏”,而在于观察它们随帧序号的变化。
声音开始活跃 → 短时幅度和短时能量通常上升。
5. 短时过零计数在这里看什么?
仅看能量还不够。
有些低能量语音,尤其是清音部分,幅度并不一定很大,但波形正负变化可能仍然比较频繁。
当前程序因此继续比较相邻采样:x(k) 与 x(k+1)
只有同时满足:
x(k) × x(k+1) < 0
以及:
x(k) - x(k+1) > 0.02
才把这一次变化计入当前帧的 zcr。所以当前源码中的 zcr 更准确地说是:
经过 0.02 幅值差条件筛选后的逐帧过零计数。
它没有再除以帧长,也没有换算成“每秒多少次”,因此程序后面直接使用的是每帧计数值。
按当前数据等价复算,240 点帧长、80 点帧移时,zcr 的最大计数为 27。
6. 为什么计算特征前还用了 0.9375 的预加重?
程序在部分幅度和能量计算前使用:
y[n] = x[n] - 0.9375x[n-1]
源码对应:filter([1 -0.9375], 1, x)
这是一种简单的一阶预加重处理。
它会削弱变化较慢的成分,同时相对突出相邻采样之间变化较快的部分。
在当前端点检测中,预加重后的信号再进行平方和计算,有利于增强某些语音变化区域与平稳背景之间的差异。
需要注意,程序前面用于演示短时能量的 240 点分帧,与最终端点检测使用的 256 点帧长、90 点帧移并不是完全同一组参数。
最终端点判断应以第三部分的参数为准。
7. 能量门限为什么还要根据当前录音重新调整?
端点检测一开始给出了:
高能量门限 amp1 = 10
低能量门限 amp2 = 2
但程序没有机械使用这两个数,而是继续执行:
amp1 = min(10, max(amp)/4)
amp2 = min(2, max(amp)/8)
也就是说:
如果当前录音整体能量比较小,程序会自动把初始门限往下调。
按当前 sound2.wav 等价复算,端点检测阶段的最大短时能量约为:
max(amp) ≈ 7.7934
因此真正进入状态机的能量门限变为:
门限 | 源码初值 | 当前音频实际使用值 |
|---|---|---|
高能量门限 amp1 | 10 | 约 1.9484 |
低能量门限 amp2 | 2 | 约 0.9742 |
过零门限 zcr2 | 5 | 5 |
这一步很重要。
如果仍然坚持使用 amp1 = 10,而当前音频所有帧的最大能量只有约 7.79,那么程序就不可能通过高能量门限确认语音开始。
8. 端点检测状态机究竟怎样工作?
当前程序使用四种状态:
0:静音;1:可能开始;2:已经进入语音段;3:语音结束。
判断路线可以概括成:
静音 → 低门限或过零数升高 → 可能开始 → 超过高能量门限 → 确认语音 → 连续低于低门限 → 判断是否真正结束
其中几个关键条件是:
从静音进入“可能开始”
只要:amp > amp2
或者:zcr > zcr2
程序就开始累计可能的语音长度。
确认真正进入语音
当:amp > amp1
程序把状态切换为 2,并回溯前面已经累计的若干帧,确定起始帧 x1。
怎样避免一个很短的停顿就立即结束?
进入语音后,如果能量和过零计数同时降低,程序不会马上宣布结束,而是累计 silence。
当前:minsilence = 6
即要连续积累一定数量的低活动帧,才认为语音可能真正结束。
怎样排除特别短的噪声?
当前:minlen = 15
如果累计出来的候选语音太短,就重新回到静音状态,不把它当成有效语音。
所以这套程序真正依赖的是:
高能量确认 + 低能量扩展 + 过零辅助 + 最短语音长度 + 最短静音长度
而不是某一个单独阈值。
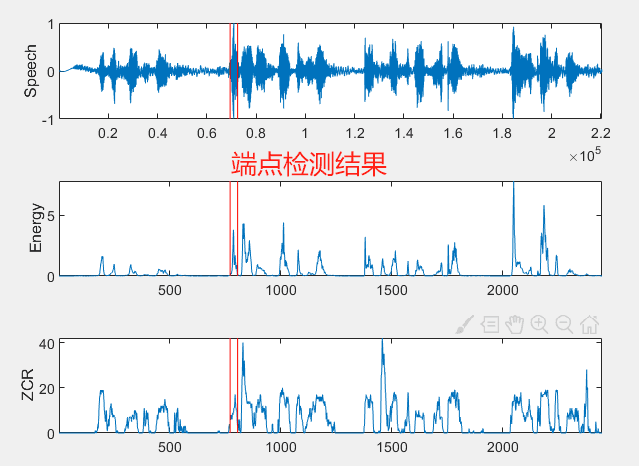
9. 当前 sound2.wav 实际检测到了哪里?
按当前 main.m、enframe.m 和 sound2.wav 对检测过程进行等价复算,状态机得到:
起始帧 x1 = 772
结束帧 x2 = 806
源码在原始波形上画红线时使用的是:采样位置 = 帧编号 × 90
因此两条检测标记对应:
结果 | 当前值 |
|---|---|
起始标记 | 69480 点 |
结束标记 | 72540 点 |
起始时间 | 约 1.5755 s |
结束时间 | 约 1.6449 s |
两条标记间隔 | 3060 点,约 69.39 ms |
这里要特别注意:
这两个时间是按照当前源码绘图时的“帧编号 × 帧移”关系换算出来的红线位置,不应进一步包装成高精度人工标注真值。
最终可视化会把同一组起止位置同时映射到:
原始声音波形 + 短时能量 + 短时过零计数
这样可以直接观察检测边界为什么会落在当前位置。
10. 为什么不直接只用一个能量阈值?
只用一个能量阈值虽然更简单,但容易遇到两个问题。
低能量语音可能被截掉
某些语音片段幅度较弱,只看高能量门限可能会把真实语音的前沿或尾部切掉。
当前程序因此采用:
高门限负责“确认” → 低门限负责“扩展和保持”
清音不一定具有很高能量
清音等部分可能能量不突出,却存在比较明显的快速正负变化。
所以程序又加入:zcr > 5作为辅助条件。
这就是当前程序组合短时能量与过零信息的真正意义:
能量负责判断声音是否足够强,过零信息负责补充部分低能量但变化活跃的区域。
11. 当前源码有哪些特别值得注意的实现边界?
这套代码能够直接完成实验,但从源码本身看,有几个边界需要明确。
只寻找第一段满足条件的语音
一旦状态进入:status = 3后续循环会 break。
因此当前实现的目标是:
找到第一段有效语音的起点和终点
而不是把整段 5 秒录音中的所有语音片段全部分段输出。
当前过零条件不是常见的绝对幅值差判断
源码写的是:
(tmp1 - tmp2) > 0.02
而不是:
abs(tmp1 - tmp2) > 0.02
这意味着当前 0.02 条件带有方向性。
因此文章中的结果应按当前源码实际实现理解,不能直接把它当成所有教材中完全相同的标准过零率公式。
第二部分的 Energy 标签与实际计算式并不完全一致
第二部分有:
amp = sum(abs(enframe(...)), 2);
这实际上是预加重后各帧绝对值之和,并没有平方。
虽然纵轴写成了 Energy,但从数学运算看,它更接近短时幅度类指标。
真正用于最终端点检测的 amp 才使用平方和:
sum(abs(frame).^2, 2)
当前分帧没有乘窗
enframe 支持传入窗函数,但当前代码给它的是一个标量帧长,因此实际上只是直接截取重叠矩形帧,没有使用 Hamming、Hann 等加权窗。
对于当前短时统计和教学演示可以正常运行,但不要把它描述成已经实现了复杂的窗函数预处理。
极端输入没有额外保护
如果换成一段始终无法超过高门限的声音,x1 可能始终没有被赋值,而后面的 x2 = x1 + count - 1 就会出现问题。
因此当前代码更适合:
已有明显有效声音片段的端点检测实验
而不是已经完成所有异常保护的通用语音处理产品。
12. 哪些参数最值得修改?
当前代码里真正值得实验的参数主要集中在分帧尺度和端点判断门限。
参数 | 当前值 | 为什么值得改 | 调整后的主要影响 |
|---|---|---|---|
FrameLen / inc | 256 / 90 | 决定端点判断的时间尺度 | 帧更短、帧移更小可提高时间分辨率,但特征波动也会更明显 |
amp1 / amp2 | 10 / 2,再自适应下调 | 决定强语音确认与弱语音保持边界 | 降低会提高灵敏度,但也更容易把背景波动纳入语音 |
zcr2 | 5 | 直接决定过零信息介入检测的灵敏度 | 降低后更容易保留低能量高频变化,同时误检风险增加 |
minsilence | 6 帧 | 决定多长的短暂停顿才算语音结束 | 增大可避免短停顿把一句话截断,但终点可能向后移动 |
minlen | 15 帧 | 用于排除过短候选段 | 增大能抑制短脉冲噪声,也可能过滤很短的真实语音 |
这些参数不能脱离采样率、录音环境和噪声水平直接照搬。
尤其是换成新的音频后,能量门限和静音长度通常最值得重新检查。
13. 怎么运行?
直接运行:main
程序默认读取当前目录中的 sound2.wav,依次完成:
声音读取 → 分帧 → 短时幅度/能量计算 → 过零计数 → 端点检测 → 可视化
运行后可以直接观察原始波形及其短时特征,并在端点检测结果中看到红色起止标记。
如果要分析自己的音频,最直接的方法是把 main.m 中三处:sound2.wav统一换成新的文件名。
当前自带数据为单声道,程序内部也按一维声音向量进行分帧,因此新数据最好先准备成单声道音频,避免多声道输入带来与当前实现不一致的行为。
14. 一句话看懂这个项目
这是一个基于 MATLAB 的声音短时特征与语音端点检测程序:它读取 5 秒、44.1 kHz、单声道的sound2.wav,通过enframe.m将连续声音切成重叠短帧,先计算短时幅度、短时能量和带 0.02 幅值差条件的过零计数,再对归一化声音进行 0.9375 系数预加重,并利用高低能量门限、过零门限、最短静音长度和最短语音长度组成四状态检测流程;按当前源码和数据等价复算,高低能量门限实际调整为约 1.9484 和 0.9742,第一段有效语音得到 x1=772、x2=806,源码绘制的端点标记约位于 1.5755 s 和 1.6449 s。需要注意当前程序只检测第一段语音,zcr1没有参与判断,且部分过零与标签写法具有源码自身的实现特点,因此它更适合 MATLAB 语音短时特征、双门限端点检测和参数影响的实验学习与算法验证。


