首页/文章/ 详情

TITS论文推荐 | 车载信号如何定量检测地铁钢轨波磨粗糙度?
1天前浏览2
钢轨波磨是轨头纵向表面的周期性不均匀磨耗。波磨会加剧轮轨动力作用,引起车辆与轨道部件疲劳、噪声和地面振动。当前运营线路通常采用钢轨打磨控制波磨,打磨区段和时机需要依据线路波磨状态确定。  

钢轨波磨分析小车(Corrugation Analysis Trolley,CAT)只能在列车停运期间测量,检测窗口有限。车载轴箱加速度(Axle Box Acceleration,ABA)可随运营列车采集全线响应。论文在RCNet基础上构建RCNetV2.0,通过清洗与恢复改善实测数据质量,并将波磨主导特征及ISO 3095限值融入训练和评价,提高关键波段粗糙度的预测精度。

论文信息

题目 Accurate and Fast Quantitative Detection of Rail Corrugation Driven by Deep Learning Algorithms Using Adaptive Targeted Loss and Directed Metric Functions

作者 Qinglin Xie、Jing Wang、Fangbo Liu、Jizhong Yang、Gongquan Tao、Zefeng Wen

机构 西南交通大学轨道交通运载系统全国重点实验室;中铁二院工程集团有限责任公司

期刊 IEEE Transactions on Intelligent Transportation Systems,26(11),2025,19779–19790

DOI 10.1109/TITS.2025.3616106

论文速览

  • 问题 异常与缺失信号损害输入和标签质量;各波段等权训练难以突出波磨主导特征,整体拟合指标也难以准确评价这些特征。
  • 方法 清洗与恢复联合改善数据准确性和完整性;目标损失按样本的真实粗糙度与限值关系分配权重;定向指标集中评价超限波段,使训练重点与评价依据一致。
  • 证明 商业地铁线路共生成10661个样本,其中2161个用于训练并进行五折交叉验证,8500个用于测试。10次试验的平均拟合度为96.6%,平均推理时间为0.71 ms/样本。

目录

  1. 检测任务与主要工作
  2. 数据质量:清洗与恢复衔接
  3. 目标损失:突出波磨主导特征
  4. 定向指标:评价关键波段精度
  5. 现场试验、结果与消融

1. 检测任务与主要工作

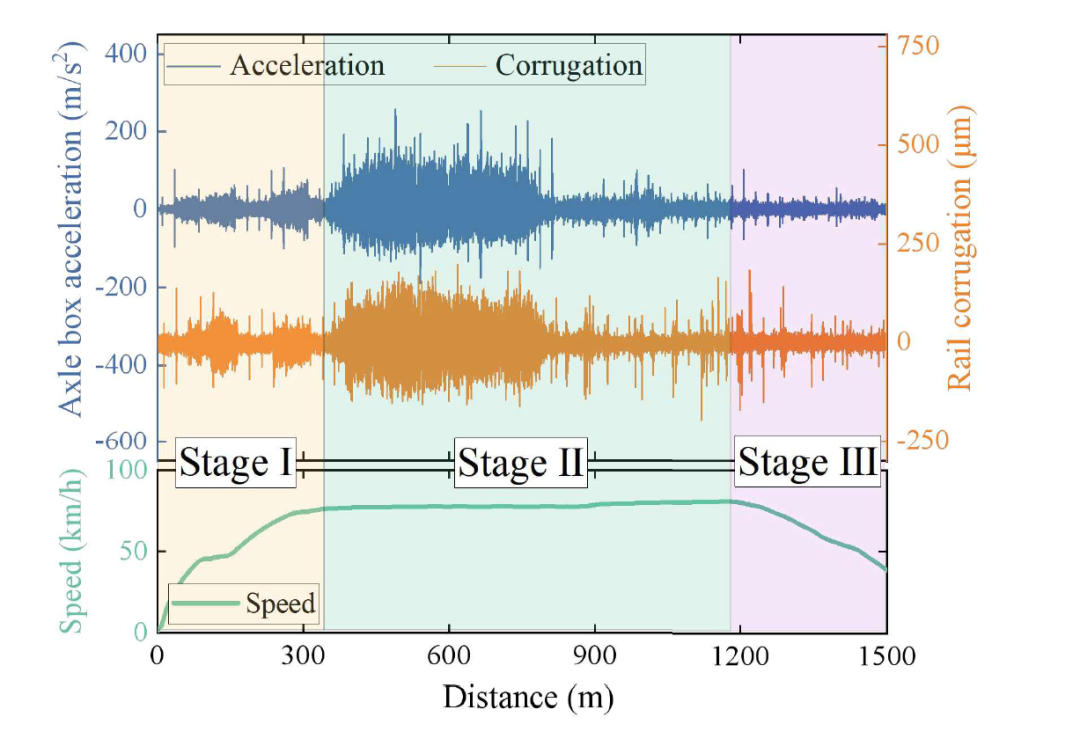
论文利用车载轴箱加速度(Axle Box Acceleration,ABA)频谱和速度,输出10~400 mm波长范围内17个1/3倍频程的粗糙度值。列车在站间经历加速、匀速和减速,模型需要学习速度、振动响应与粗糙度之间的对应关系,并保留检测结果的线路位置。

论文的主要工作在于数据、训练和评价三个环节。数据质量框架联合处理异常项和缺失段,为监督学习提供准确、完整的信号。自适应目标损失利用较大粗糙度及其对应波长主导波磨特征的领域知识,按每个样本的超限情况调整训练权重。定向指标以相同的关键波段作为评价对象,衡量模型对波磨主导特征的预测能力。

RCNetV2.0的卷积回归结构基于作者前作*。本文的主要方法改进集中在目标损失与定向指标,将工程上对波磨特征的判断依据转化为网络优化目标和评价规则。

*Qinglin Xie, Gongquan Tao, Siu Ming Lo, Xiaoxuan Yang, Zefeng Wen. A data-driven convolutional regression scheme for on-board and quantitative detection of rail corrugation roughness. Wear, 2023, 524-525: 204770.

Qinglin Xie, Gongquan Tao, Chenxi Xie, Zefeng Wen. Abnormal data detection based on adaptive sliding window and weighted multiscale local outlier factor for machinery health monitoring. IEEE Transactions on Industrial Electronics, 2023, 70(11): 11725-11734.

Qinglin Xie, Jing Wang, Guan Sen Dong, Gongquan Tao*, Chenxi Xie, Zefeng Wen. Research on one-dimensional data quality assurance for machinery health monitoring using compressive sensing and enhanced context encoder. Expert Systems With Applications, 2025, 297(Part B): 129407.

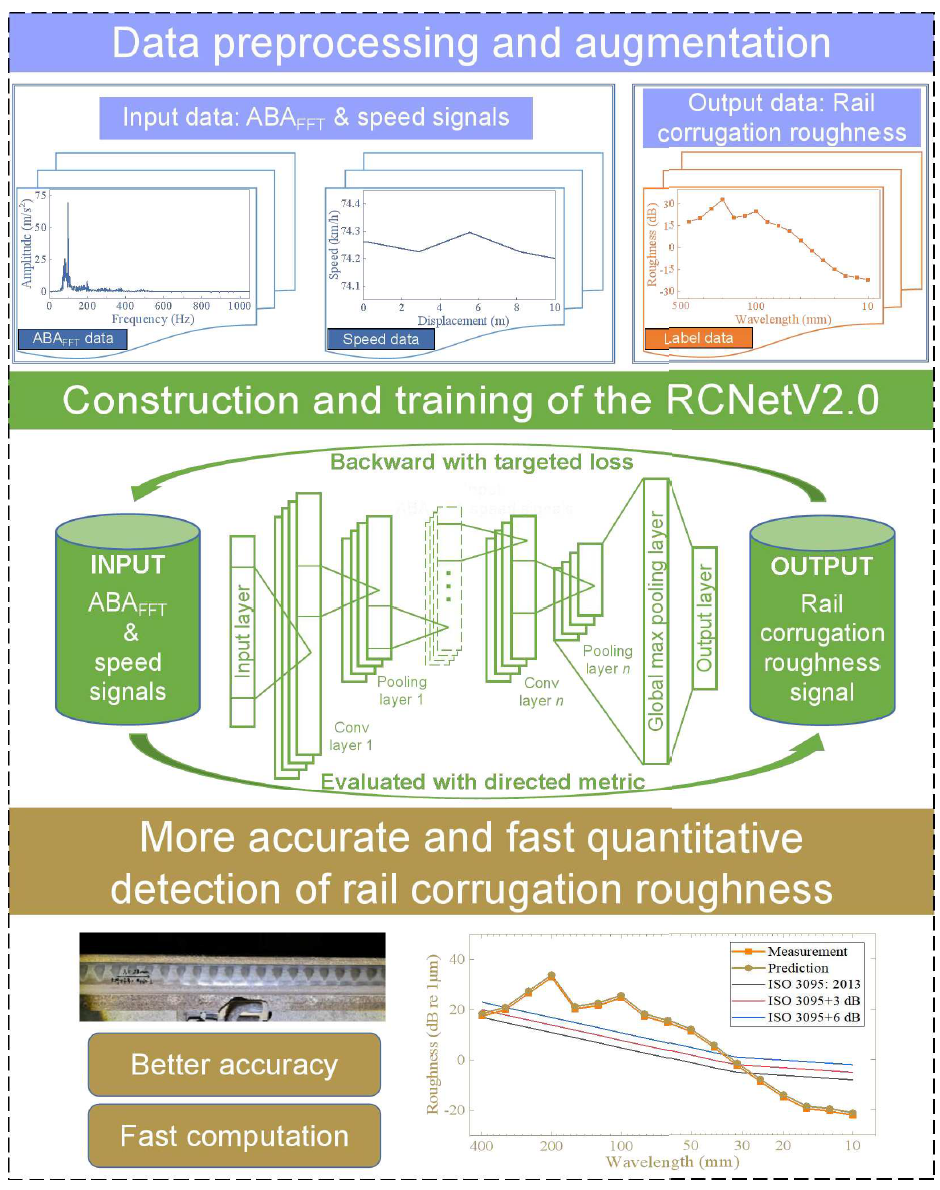
总体流程包括数据预处理与增强、RCNetV2.0训练以及粗糙度定量输出。车载轴箱加速度(Axle Box Acceleration,ABA)频谱和速度进入网络,钢轨波磨分析小车(Corrugation Analysis Trolley,CAT)粗糙度谱提供标签,目标损失用于反向传播,定向指标用于模型评价。


2. 数据质量:清洗与恢复衔接

量程设置不当和测试过程不规范会使车载轴箱加速度(Axle Box Acceleration,ABA)输入与波磨标签产生漂移或突变,干扰模型学习两者的映射。论文先进行带通滤波,再用自适应滑动窗口分段,通过加权多尺度局部离群因子识别异常项并置零。

异常清洗会破坏信号的连续结构,传输中断也会产生缺失段。恢复模块结合压缩感知与增强上下文编码器,用正常数据训练编码器学习局部与全局特征,再重构清洗后含缺失项的信号。清洗负责去除错误数据,恢复负责补全信号结构,两者共同改善后续频谱分析与回归学习的数据基础。
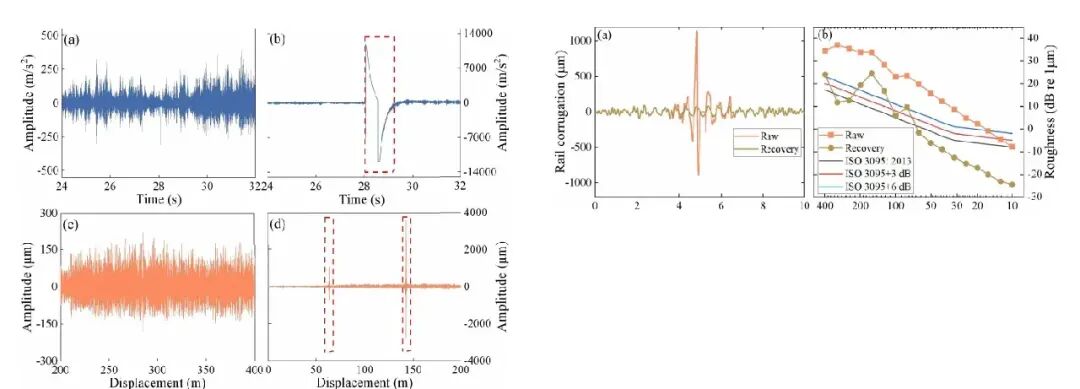
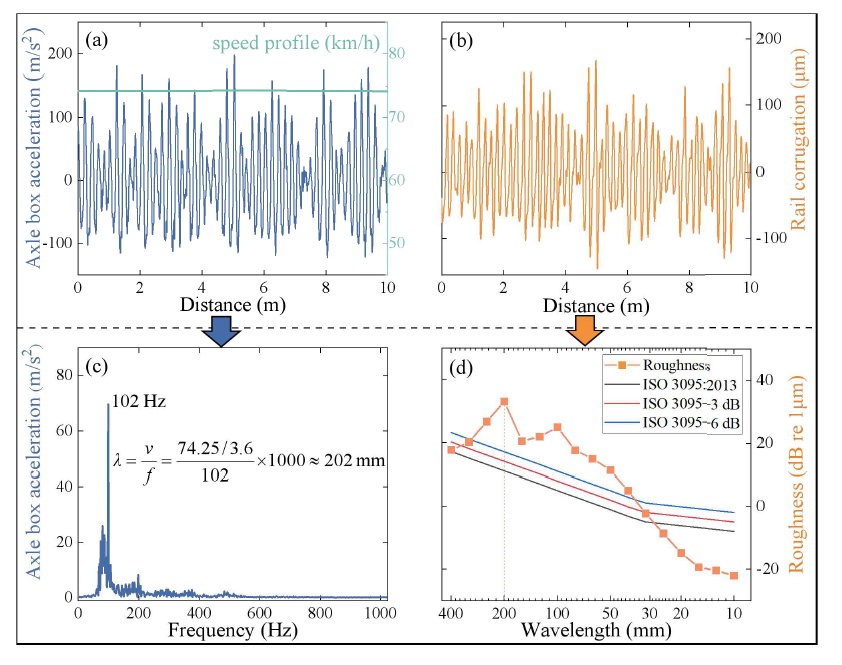
现场ABA与波磨信号的异常形态,以及波磨信号重构前后的对比  

ABA 经快速傅里叶变换(Fast Fourier Transform,FFT)得到频谱序列     ,列车速度构成第二个输入通道。波磨波长     、速度      与 ABA 主频      满足     。两通道数据经过 Z-score 标准化,再按空间位置切分;现场试验采用窗口长度10、步长2。

CAT 信号按照 ISO 3095 转换为粗糙度级:


其中,     为原始波磨信号的均方根值,    。     构成网络的监督标签。


3. 目标损失:突出波磨主导特征

RCNetV2.0沿用RCNet的卷积神经网络结构。双通道输入依次通过卷积层、激活函数、池化层、全局最大池化层和丢弃层,线性层输出17维粗糙度谱。
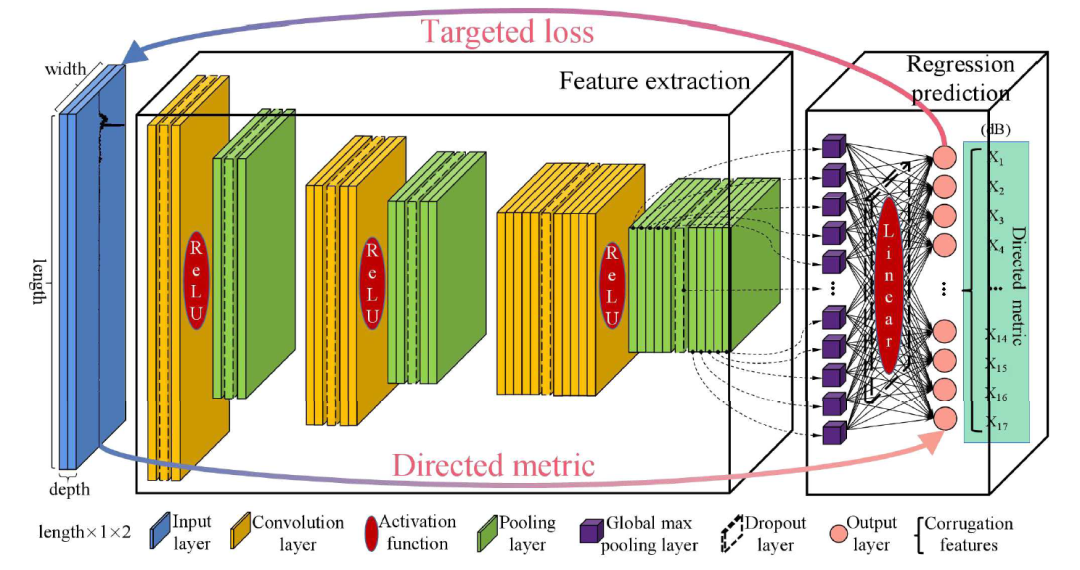


常规均方误差(Mean Squared Error,MSE)对17个回归项等权计算,反映整条粗糙度谱的平均偏差。波磨状态主要由较大的粗糙度值及其对应波长决定,超限波段需要在训练中获得更高权重。ISO 3095允许单个频带最多高于限值6 dB,或最多三个相邻频带高于限值3 dB。论文据此设计目标损失,将标准限值纳入逐项误差计算。
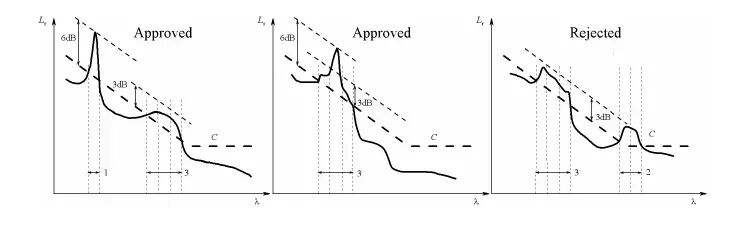
ISO 3095粗糙度谱的通过与拒绝示例  


其中,Prediction与True分别为预测谱和真实谱,ISO_3095_Limit为对应波段限值,    为权重向量。真实值不超过限值时权重为1;超限项按真实值与限值的关系赋权。权重随样本和波段变化,使网络在学习整条谱的同时加强主导特征的误差修正。对数形式控制损失数量级,常数3对应标准中的临界阈值。
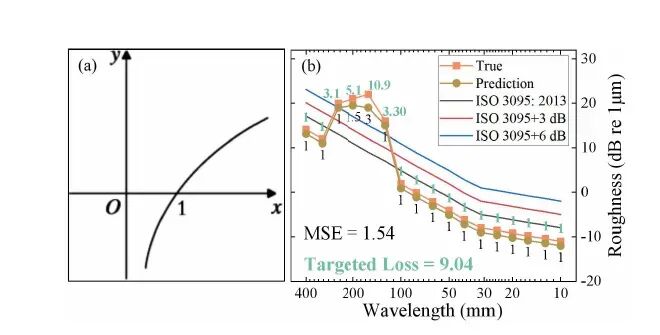
目标损失采用的对数权重及超限回归项加权示例  

4. 定向指标:评价关键波段精度

训练重点改变后,评价也需要反映关键波段的预测质量。普通决定系数      汇总全部回归项,关键波段的偏差会与其他波段共同影响评分。定向指标提取真实谱中的超限项及对应预测值,再计算     ;全部真实值均未超限时,采用普通     。

论文用两个案例说明评价差异。Case A准确预测全部非超限项,四个超限项存在偏差,普通      为99.46%,定向指标为36.14%。Case B准确预测四个超限项,其余预测值均低3 dB,普通      为95.23%,定向指标为100%。定向指标据此将主导特征预测准确的Case B评为更优,解决整体拟合排名与关键波段预测质量不一致的问题。
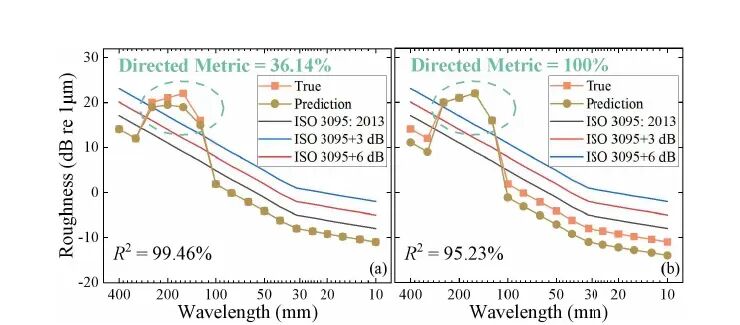
Case A与Case B在普通R方和定向指标下的评价差异  

训练完成后,     与速度输入RCNetV2.0,网络输出10~400 mm范围内各1/3倍频程波长对应的粗糙度级。

5. 现场试验、结果与消融

现场试验在中国西南一条商业地铁线路开展。CAT以2 mm默认空间分辨率测量钢轨波磨;B&K 3560D以16384 Hz采集ABA,转速计记录速度。试验前对车轮进行重新镟修,以减小车轮多边形和擦伤对ABA的干扰。线路区段采用不同的打磨周期,数据覆盖不同发展阶段的波磨。
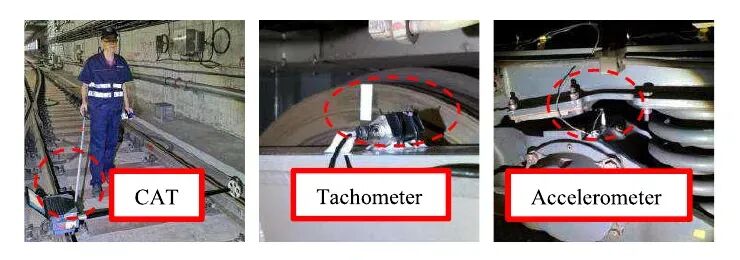
CAT、转速计和轴箱加速度计的现场布置  

空间窗口共生成10661个样本,2161个样本用于训练并进行五折交叉验证,8500个样本用于测试。图10所示样本的ABA主频为102 Hz,速度为74.25 km/h,由    计算得到的波长约为202 mm,与粗糙度谱中的主波长一致。

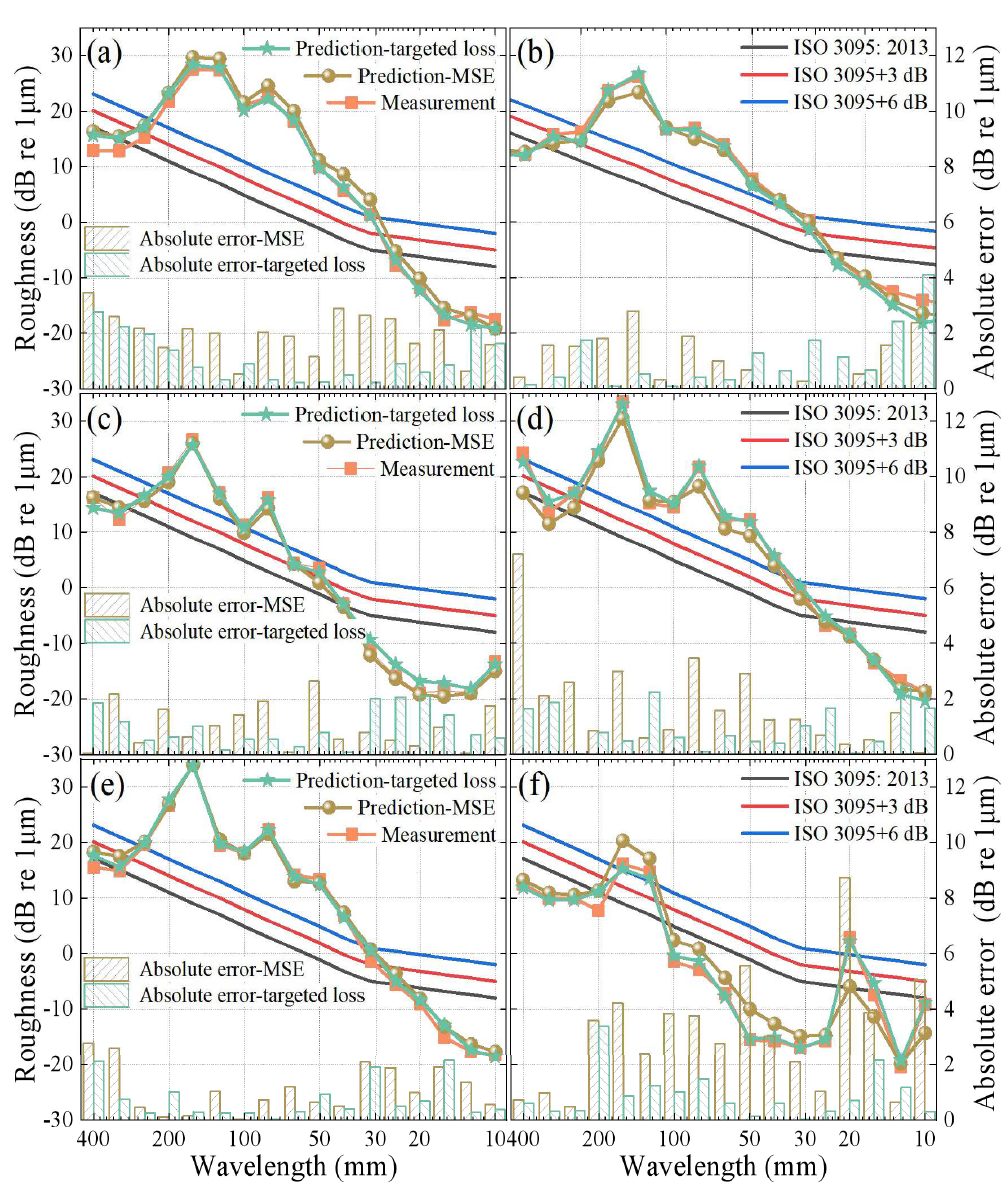
表I列出六个代表样本的均方误差、    和定向指标。样本b中,RCNet/RCNetV2.0的MSE分别为2.031/2.379,    分别为0.988/0.986,定向指标分别为0.965/0.985。样本f中,MSE从13.984降至1.475,    从0.903升至0.990,定向指标从0.0562升至0.973。

样本b体现了两类评价的区别:RCNetV2.0的整体拟合评分略低,超限波段预测更准,定向指标反映了这一改善。样本f同时表现出整体误差与关键波段误差的降低。
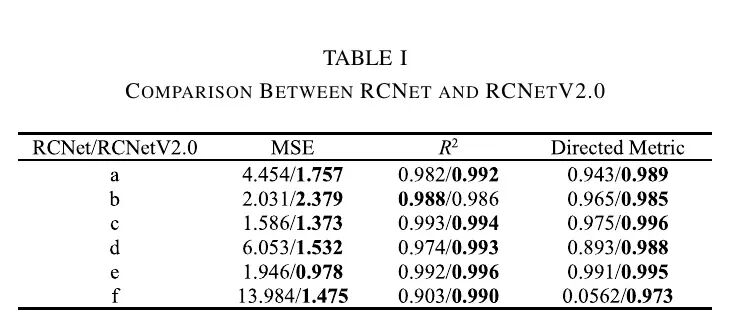
RCNet与RCNetV2.0在六个代表样本上的定量结果  


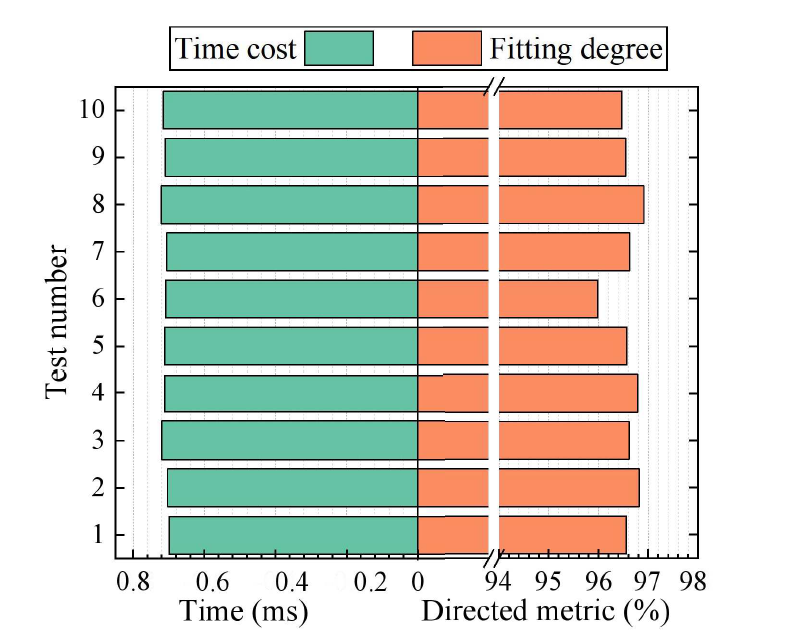
10次试验的拟合度均达到96%以上,平均值为96.6%,标准差为0.25。在Intel Xeon W-2265、64 GB内存和NVIDIA RTX A5000平台上,RCNetV2.0的平均计算时间为0.71 ms/样本。

数据质量消融使用RCNet作为检测模型。经过数据清洗与恢复后,10次试验的拟合度提高,MSE降低。目标损失与定向指标消融中,RCNet和RCNetV2.0分别重新训练100次。RCNetV2.0在MSE和目标损失上的多数点位于对角线下方,定向指标的全部点位于对角线上方。图11(c)显示,限值以下回归项因权重较低,RCNetV2.0在这一区域的检测精度低于RCNet;作者指出,这一差异不影响模型识别波磨的主要特征。
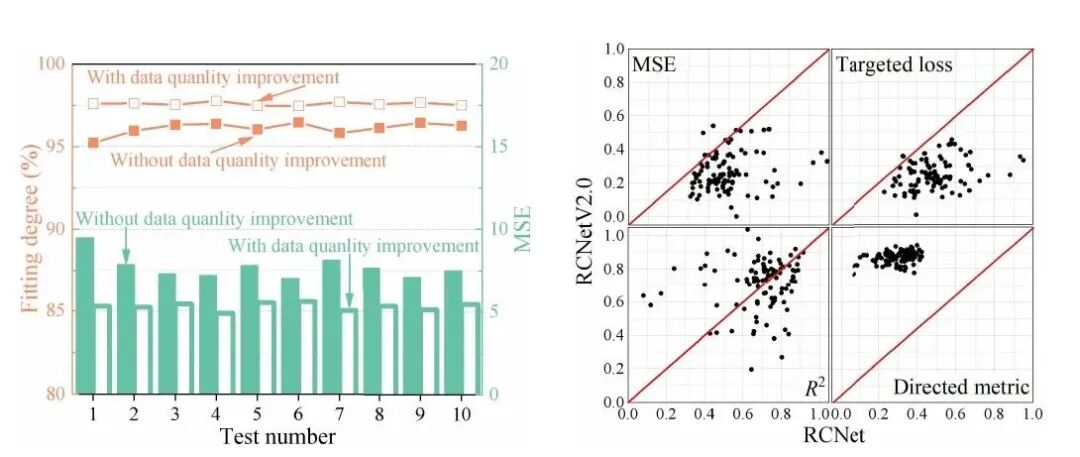
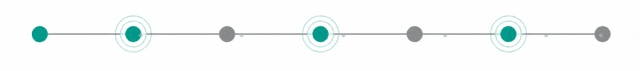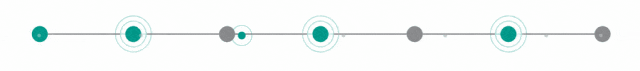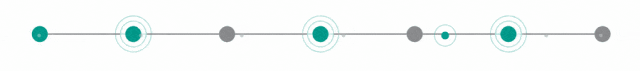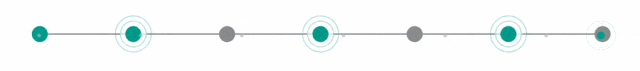
数据质量处理、目标损失和定向指标的消融结果  
数据节点动态分隔线
第一作者:谢清林,本、硕、博,博士后均就读/工作于西南交通大学,长期从事轨道交通轮轨系统智能运维关键理论与技术研究,着重解决轮轨表面不平顺在途检测与定量识别、机械与结构健康监测信号大数据分析与处理等问题。提出了车轮多边形和钢轨波磨波长、波深与粗糙度等特征的离散分类预测与连续回归拟合模型,发展了异常数据清洗、缺失数据重构、含噪数据分离等振动噪声信号的数据质量提升方法。主持国自然青年科学基金项目、四川省科技计划项目、中国博士后科学基金项目、中央高校基本科研业务费项目各1项,主研国自然重点支持项目与面上项目、四川省国际科技创新合作项目等纵向课题和企业合作横向课题20余项。第一作者在IEEE TIE、IEEE TITS、ESWA、IAVSD等顶刊顶会发表学术论文13篇,授权发明专利10项(含美国发明专利1项),公布发明专利5项。多次参与领域内重要国际学术会议,曾在第六届中国铁路发展论坛做特邀报告,任第13届接触力学与轮轨系统磨耗国际大会最年轻分会场主席并作主题报告。 现为IEEE、中国铁道学会、中国振动工程学会会员,担任SHM、EAAI、IEEE TII、Measurement、ISA Transactions等权威期刊审稿人。曾获西南交通大学学生最高个人荣誉“竢实扬华”奖章、2025届四川省优秀毕业生、中国铁道学会科学技术奖、河南省科学技术进步奖 、EITRT 2023国际学术会议最佳论文奖、多次国家奖学金等荣誉奖励,入选首届《中国科协青年人才托举工程博士生专项计划》。

个人主页:

https://faculty.swjtu.edu.cn/xieqinglin/zh_CN/index.htm,

个人邮箱:qlxie@swjtu.edu.cn

西南交通大学轨道交通运载系统全国重点实验室轮轨关系与振动噪声研究团队,团队轮轨关系研究方向负责人温泽峰研究员,长期从事轨道交通机车车辆和轨道工程等领域的科研和教学工作,着重解决轮轨滚动接触基本理论、轮轨滚动接触疲劳和磨损、轮轨黏着、轮轨型面和材料优化匹配以及轮轨振动噪声等轮轨关系问题。先后主持国家自然科学基金区域创新发展联合基金重点支持项目1项、国家自然科学基金委员会—铁道部高速铁路基础研究联合基金重点支持项目1项、面上项目2项、青年基金项目1项,国家科技支撑计划课题子任务2项,教育部博士点基金项目1项,教育部新世纪优秀人才支持计划项目1项,霍英东青年教师基金项目(优选资助)1项,四川省科技计划项目1项,四川省青年科技基金项目1项;主研国家自然科学基金项目6项,973计划课题2项(其中1项学术骨干),863计划课题4项,国家科技支撑计划课题子任务3项,教育部博士点基金3项,中国铁路总公司(含原铁道部)重大、重点课题10余项;主持企业合作项目40余项,参与企业合作项目100余项。

个人主页:

https://faculty.swjtu.edu.cn/wenzefeng/zh_CN/index/93401/list/index.htm


编辑:曹希铭
校核:李正平、陈凯歌、Leo、赵学功、白亮、任超、海洋、陈宇航、Kira、Tina、王金、赵诚、肖鑫鑫、张优
来源:故障诊断与python学习
ACTSystem振动疲劳轨道交通ANSAUG海洋理论材料Fourier Transform多尺度控制试验
著作权归作者所有,欢迎分享,未经许可,不得转载
首次发布时间:2026-09-24
最近编辑:1天前
故障诊断与python学习
硕士 签名征集中
获赞 87粉丝 153文章 333课程 0
点赞
收藏
作者推荐

新锐期刊一区TOP论文推荐|结合可解释性与不确定性的刀具剩余使用寿命自适应预测方法

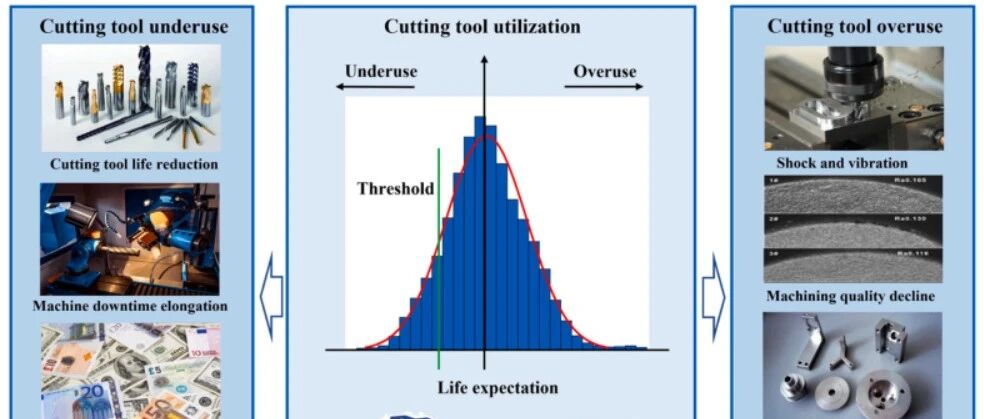
本期给大家推荐结合可解释性与不确定性的刀具剩余使用寿命自适应预测方法。在高端制造领域,刀具剩余使用寿命(Remaining Useful Life, RUL)的精准预测直接关乎加工质量与生产能效,是实现智能化切削工艺的核心环节。然而,实际工况中有限的无标签样本、退化过程固有的强不确定性,以及传统模型对大量历史标注数据的依赖,长期制约着RUL预测方法的工程适用性。针对这一瓶颈,本文提出一种融合多源传感信息与贝叶斯自适应推理的全新预测框架:该模型无需离线训练,仅依托在线观测即可动态更新退化参数,并内嵌延迟拒绝与自适应Metropolis-Hastings策略以显式量化不确定性。经刀具磨损实验验证,新方法在无需大规模标注数据的前提下,显著提升预测鲁棒性与可解释性,为工业场景下的小样本RUL预测提供了兼具实用价值与理论深度的技术路径。论文基本信息论文题目:An adaptive RUL prediction approach for cutting tools incorporated with interpretability and uncertainty 论文期刊:Reliability Engineering and System SafetyDoi:10.1016/j.ress.2024.110705作者:Zenghui Wang (a), Guanghui Zhou (a,b,*), Chao Zhang (a,b), Jiancong Liu (a), Fengtian Chang (c), Yaguang Zhou (a), Chong Han (a), Dan Zhao (a,b) 论文时间:2025年 机构:(a) School of Mechanical Engineering, Xi’an Jiaotong University, Xi’an 710049, PR China (b) State Key Laboratory for Manufacturing Systems Engineering, Xi’an Jiaotong University, Xi’an 710049, PR China (c) School of Construction Machinery, Chang’an University, Xi’an 710064, PR China作者简介:周光辉,工学博士,教授,博士生导师。1996年、1999年与2003年分别获西安交通大学工学学士、硕士与博士学位。2000年、2004年分别在香港大学作Research Assistant和访问学者,2004年9月到西安交通大学任教,2010年-2011年在美国佛罗里达州立大学作访问学者,入选教育部新世纪优秀人才支持计划,获陕西省“三秦人才”津贴。近年来围绕智能制造与产品服务系统技术、复杂机电产品协同优化设计与低碳设计、离散车间制造执行系统高效低碳运行理论与方法三个研究方向,先后承担包括国家973、863、国家自然科学基金、科技部创新方法专项、科技部科技支撑计划、工信部智能制造专项、工信部数控重大专项、广东省教育部产学研项目等国家省部及企业级纵横向项目40余项,发表学术论文200余篇,出版学术专著2本,主编/参编教材及教学参考书12部;申报国家发明专利58项,授权43项;登记计算机著作版权28项;获教育部自然科学一等奖1项,陕西省科学技术二等、三等奖各1项,陕西省高等学校自然科学一等奖2项,二等奖1项,行业协会奖2项,陕西省学位与研究生教育学会研究生教学成果一等奖、二等奖各1项,西安交通大学教学成果(研究生)一等奖1项、二等奖2项;获陕西省优秀博士学位论文。(摘自西安交通大学教师主页) 通讯作者邮箱:ghzhou@mail.xjtu.edu.cn 摘要刀具剩余使用寿命(Remaining Useful Life, RUL)的可靠预测对于保障加工质量、推动可持续发展至关重要,是高性能加工的核心组成部分。传统方法在加工过程中应对不确定性、保证可解释性方面面临重大挑战。为在小样本、无标签数据集场景下预测刀具RUL,并量化退化模型中的不确定性,本文提出一种基于多源数据融合与贝叶斯推理的自适应RUL预测方法。具体而言,本文提出一种基于刀具退化过程的自适应贝叶斯迭代更新模型。该模型无需大量有标签样本或离线训练,同时兼顾可解释性与不确定性。此外,将贝叶斯推理结合延迟拒绝与自适应Metropolis-Hastings策略,用于更新退化模型中的不确定性参数。这使得退化模型能够通过持续观测,实时自适应逼近实际磨损趋势。所提方法通过刀具磨损实验数据验证,与其他方法相比,平均均方根误差(Root Mean Square Error, RMSE)分别降低27.00%和11.60%。值得注意的是,该方法不依赖大规模有标签历史数据集,能有效缓解不确定性的影响,为实际工业应用中的RUL预测提供了一种新思路。关键词:刀具;剩余寿命预测;贝叶斯理论;DRAM算法;可解释性;不确定性 目录1 引言1.1 研究背景1.2 相关研究1.3 研究不足与动机2 方法2.1 所提自适应RUL预测框架2.2 所提RUL预测方案细节3 关键支撑技术3.1 特征提取与观测量概述3.2 基于贝叶斯的不确定性量化4 实验案例4.1 实验装置与数据描述4.2 评估指标4.3 实验案例4.4 讨论5 结论5.1 贡献5.2 未来研究方向1 引言1.1 研究背景随着现代信息技术的发展,其与传统制造业的深度融合给全球制造业格局带来重大变革,开启了智能制造新浪潮[1-3]。为应对新一轮工业革命带来的机遇与挑战,美国、德国、日本等发达国家相继推出“工业 4.0”“先进制造伙伴计划”等战略举措,以保持国际市场竞争优势。中国同样启动“中国制造2025”战略与“新质生产力”倡议,加速高端装备制造业的智能化转型升级[4, 5]。面对制造业日益激烈的竞争与产品多样化需求,金属切削加工承担了90%以上关键零部件生产任务。刀具作为加工过程中最活跃的元件,极易发生磨损,直接影响切削效率与加工质量。刀具磨损是刀具与工件间的摩擦、剪切力、冲击共同引发机械摩擦、切削热与化学交互作用导致的退化现象。刀具磨损是金属切削的关键影响因素,决定零件质量、切屑形成与整体加工经济性[4, 6, 7]。若未及时更换严重磨损的刀具,会破坏工件表面完整性、降低机床系统刚度,甚至引发严重生产事故[8, 9]。反之,过早更换刀具会中断生产连续性,增加加工现场停机时间。刀具使用不当的负面影响如图1所示。统计数据显示,超过30%的刀具寿命因过于保守的更换策略被浪费;40%的加工质量问题源于刀具失效;50%的刀具碰撞事故由机床无法监测刀具崩损导致;超过70% 的金属切削过程缺乏刀具状态预测性维护[10]。因此,精准可靠的刀具RUL预测对提升刀具可持续性、改善加工性能至关重要[6-8]。 图1 不合理使用刀具的危害当前,新兴智能技术与工业大数据的快速发展引发了刀具RUL预测技术革命。各类预测方法不断涌现,借助先进传感设备[11,12]、信号处理算法[13,14] 与深度学习模型[15-17]实现 RUL 预测,推动RUL预测向智能化方向发展。但实际加工长期处于断续切削、高速、重载等恶劣环境,获取全生命周期数据并不现实。同时,切削过程必然存在噪声、测试误差、退化非线性等不确定性,未考虑不确定性的RUL预测结果不可靠[18,19]。此外,许多传统数据驱动方法往往忽略刀具磨损背后与摩擦、磨粒、热等因素相关的物理机制 —— 具体包括黏着磨损、磨粒磨损、热疲劳磨损及切削力引发的磨损。这导致此类方法物理可解释性低,在变工况下泛化性能差。1.2 相关研究本节综述刀具 RUL 预测相关研究,分析现有不足与研究动机。近年来,学者围绕刀具RUL预测开展大量研究,取得诸多代表性成果,可归纳为两类:数据驱动方法与物理驱动方法。数据驱动方法又可细分为基于数据统计与随机模型的方法、基于深度学习的方法[7]。Aramesh 等[20]构建基于威布尔分布基线的比例风险模型,预测变工况下刀具磨损演化。Yu[21]采用逻辑回归模型,利用以逻辑概率表示的健康指标在线预测刀具RUL。此外,Zhang等[22]采用马尔可夫链蒙特卡洛(Markov Chain Monte Carlo, MCMC)方法更新威布尔比例风险模型参数,提出刀具可靠性与平均寿命概率估计方法。这类基于统计模型的方法结构与参数相对简单,易于部署实现,能考虑退化过程中的不确定性,提供刀具磨损状态概率估计、置信区间与不确定性量化结果。但此类模型往往依赖特定分布假设,难以基于连续观测实时动态估计RUL。而基于深度学习的方法借助先进人工智能技术捕捉刀具退化趋势,通过误差反馈更新模型参数或权重[23,24]。Lei 等(201 [25]、2020 [26]、2021 [27])提出多种改进卷积神经网络(Convolutional Neural Network, CNN)与循环神经网络(Recurrent Neural Network, RNN)模型,在旋转机械 RUL 预测中表现优异。Guo等[28]与Liu等[29]将注意力机制融入深度学习,在复杂RUL预测任务中表现出色。Chen等[30]提出基于多模态融合与集成迁移学习的航空发动机 RUL 预测方法,实现变工况下有效预测。此外,Yang等[31]提出基于深度流核网络的元学习模型,解决无标签小样本数据问题。Javed等[32]建立融合增量学习与小波-极限学习机的预测框架,可在线更新退化模型。基于上述研究,Xu等[33]采用卷积自编码器网络提取特征,结合状态退化模型实现滚动轴承 RUL 在线预测。Mao等[17]融合历史全寿命数据先验信息,构建递归时间序列预测模型,通过深度对抗回归网络实现滚动轴承RUL在线预测。这些代表性方法借助统计模型与机器学习技术,凭借强大的特征提取与回归能力受到关注。诸多方法已通过实时监测数据成功实现 RUL 在线预测。但它们往往需要大量高质量数据[1,18],且通常依赖数据分布相似的假设。此外,这些方法因“黑箱”特性饱受诟病[34,35],无法严谨、物理地解释数据与 RUL 间的内在关联。同时,离线训练的预测模型能否适配新预测任务,仍需进一步探索。相比之下,物理驱动方法以系统内在物理原理与机制为基础,建立参数具备明确物理意义的物理方程或数学模型,模型可解释性强。这类模型结构通常简洁,可通过监测数据在线更新,逐步收敛至实际退化趋势[36–38]。此外,它们可通过严谨物理推导实现各时刻 RUL 迭代估计。Jaydeep等[39]提出基于贝叶斯理论与泰勒退化方程的刀具 RUL 预测框架。在此基础上,Jaydeep等[40]进一步拓展泰勒刀具寿命方程,通过模型参数量化刀具寿命与切削速度、进给量的关系,并采用Metropolis-Hastings算法更新不确定性参数。Yang等[41]将健康指标作为观测量引入交互式多模型(Interactive Multi-Model, IMM)估计框架,通过扩展卡尔曼滤波(Extended Kalman Filter, EKF)估计刀具磨损与RUL。Downey等[42]提出基于多并行退化机制的锂离子电池物理预测方法,成功将机理退化分析结果融入非线性模型实现RUL预测。此外,Wang等[36]对比分析粒子滤波(Particle Filter, PF)、卡尔曼滤波(Kalman Filter, KF)与贝叶斯推理更新退化模型的性能,结果表明多数情况下贝叶斯推理性能优于其他方法。这类方法通过严谨数学推导描述磨损过程,不严重依赖大量历史数据,在长期退化预测中具备不可替代的优势。但需注意,切削速度、切削深度、刀具材料等因素间的交互作用往往高度复杂,简单物理模型难以完整刻画。这一局限可能导致预测不准确甚至失效。基于上述代表性研究,数据驱动与物理驱动模型的核心区别在于底层思路不同。数据驱动模型采用统计方法或机器学习技术构建,物理驱动模型以系统内在机制与成熟理论为基础。两类模型均能实现精准预测与在线更新。物理驱动模型的优势在于可解释性——能基于系统物理原理解释退化过程,结构相对简洁,可通过参数校准实时更新以适配新监测工况。而数据驱动方法虽同样能实现精准预测,但在揭示系统退化关键诱因、适配陌生工况方面存在局限。此外,数据驱动模型结构通常更复杂,实现实时更新往往需要更高算力。综上,方法选择取决于监测数据特性与系统物理特性的认知程度。1.3 研究不足与动机多数数据驱动预测方法依赖大量带RUL标签的监测数据进行离线模型训练,且预测精度往往依赖在线数据分布与离线训练数据分布的相似性。但实际加工过程中,获取大量退化数据仍面临巨大挑战。受相关研究启发,研究不足可总结如下:● 依赖高质量标签数据:传统数据驱动方法往往依赖高质量有标签样本,且通常假设数据分布相似。在此背景下,无标签小样本场景下的RUL预测成为重大挑战[7,19]。● 忽略不确定性:多数传统方法忽略加工过程中噪声、切削液、电磁干扰、测试误差等不确定性,这必然降低预测结果的可信度。● 物理可解释性有限:现有数据驱动方法无需理解刀具磨损机制,但物理可解释性有限。结合刀具磨损机制开展自适应RUL预测值得深入探索。这些挑战推动本文设计一种兼具可解释性与不确定性的新型刀具RUL自适应预测方法。本研究核心贡献可归纳为三方面:● 小样本场景性能:所提方法在无标签小样本场景下表现优异,无需高成本离线训练。与传统数据驱动方法相比,平均RMSE分别降低27.00%与11.60%。● 自适应不确定性量化:采用延迟拒绝自适应Metropolis算法(Delayed Rejection Adaptive Metropolis, DRAM)实现贝叶斯推理,自适应量化退化模型未知参数的不确定性,自适应迭代提供可靠RUL预测。● 可解释性提升:将贝叶斯理论与更新后退化模型结合,为方法提供坚实理论基础与更强可解释性,优于传统数据驱动方法。本文后续结构如下:第2节介绍所提方法框架,详述预测方案;第3节阐述相关理论与技术;第4节给出案例研究;第5节总结全文。2 方法2.1 所提自适应RUL预测框架本节聚焦所提自适应刀具RUL预测方法,概述框架与具体流程。该方法包含以下关键步骤:首先,从多通道信号中提取多域特征,对筛选后的特征降维以提升预测效率;其次,构建健康指标作为观测量,指导迭代推理过程;随后,采用DRAM算法量化指数退化模型(Exponential Degradation Model, EDM)中未知参数的不确定性,使模型通过迭代自适应收敛至实际退化趋势;最后,通过铣削实验验证所提方法的可靠性。图2展示所提方法的整体架构。本研究核心贡献在于将退化模型、主成分分析(Principal Component Analysis, PCA)、贝叶斯推理等多种理论与技术融入统一框架,应用于刀具 RUL 预测。在高质量有标签监测数据不足的场景下,该方法充分考虑磨损不确定性与物理可解释性,实现自适应、无监督RUL预测。 图2 所提出的RUL预测方案框架2.2 所提 RUL 预测方案细节本节详细阐述结合可解释性与不确定性的自适应刀具RUL预测方法,所提方法具体流程如图3所示。具体步骤可总结如下:步骤1:采集加工过程中海量多通道监测数据s;步骤2:通过信息处理技术提取监测数据多域特征,采用斯皮尔曼相关系数初步筛选特征;步骤3:利用PCA技术对筛选后的多域特征降维融合,构建健康指标作为观测量x;步骤4:确定不确定性参数θ的先验分布 π(θ),设置采样次数T与非自适应阶段T₀,通过2.2节DRAM算法自适应更新指数退化模型(Exponential Degradation Model, EDM)不确定性参数,逼近实际退化趋势;步骤5:通过更新后退化模型M(θ)得到当前时刻刀具RUL的后验概率分布p(θ|x)。需注意,先验分布通常基于专家知识与历史经验。若无此类信息,可依据贝叶斯原理采用均匀先验,以降低主观不确定性的影响。此外,多数数据驱动方法直接将原始传感器数据映射至目标RUL标签,获取精准标签的成本往往较高。相比之下,所提方法通过从原始传感器信号提取多域特征、构建健康指标,解决标签依赖问题。随后将该指标与更新后退化模型结合,预测刀具健康状态。当预测值超过预设阈值时,可递归推断刀具RUL。 图3 所提预测方法的整体结构3 关键支撑技术本节主要讨论相关研究理论与技术,详细介绍特征提取与不确定性量化的理论及方法。3.1 特征提取与观测量概述3.1.1 多域特征提取信号特征提取是从监测数据中获取能反映系统状态信息的过程,以应对监测数据的高维度特性,是故障诊断、军事目标识别等多个领域的基础与关键。刀具磨损监测中,原始信号通常包含异常值、噪声等,且数据量庞大,往往无法直接捕捉磨损退化趋势。通过特征提取对信号预处理,可揭示磨损相关关键信息、降低噪声、减少数据冗余,进而提升RUL预测精度。假设信号s=[s₁, s₂, ⋯, sₙ]长度为n,即每个采集通道的数据点数量。每个通道共提取24项特征,除最大值、最小值、中位数外,其余21项特征的具体表达式列于表1。通过提取时域特征,可获取刀具磨损过程中信号的整体变化。本文提取均值、方差、峰值等13项时域特征,反映信号的平均水平、离散程度与极值位置,为刀具磨损状态提供基础信息。同时,刀具磨损过程中的信号通常包含不同频率分量,可通过傅里叶变换等频域分析方法提取。本文提取频率质心、均方频率等9项频域特征,获取不同频率分量对刀具磨损的贡献程度信息。时频域方面,采用小波分解对信号进行3层分解,选用“db3”小波基函数,提取对局部微小变化敏感的小波总能量。表1 所提取特征的计算公式 3.1.2 PCA 技术与健康指标构建多源信号提取特征后,数据量显著降低,但剩余数据仍可能包含无关或冗余特征,降低预测效率与精度,甚至引发维度爆炸问题。因此,需进一步特征融合以实现降维。本文采用PCA技术融合提取的多域特征,缓解噪声对RUL预测的负面影响。该降维过程类似信息融合,可充分利用多源数据的互补性[43]。PCA在状态估计、目标识别、军事控制等领域具备广阔发展与应用前景。PCA核心思路是通过计算样本协方差矩阵的特征向量,将特征从输入空间线性映射至低维特征空间。提取主成分前,需对原始特征数据标准化以消除量纲影响。PCA具体步骤如下:(1)计算信号协方差矩阵,表达式为 (2)求取 的特征值 与单位正交特征向量 : 前 个较大特征值 代表前 个主成分的方差, 对应的特征向量 为主成分 在原始变量上的系数。主成分方差贡献率δᵢ表示信息含量: 若 个主成分累计贡献率大于85%,提取的主成分特征即可反映原始高维特征信息。 (3)计算信号样本的主成分得分: 其中 , 为特征主成分矩阵,即压缩后的特征数据,相同工况下得到的低维特征与磨损程度高度相关。3.2 基于贝叶斯的不确定性量化3.2.1 贝叶斯模型更新原理受材料性能、加工误差、测试噪声等因素影响,系统监测往往存在各类不确定性。当前,贝叶斯推理凭借扎实的概率推理数学基础,在不确定性量化与分析中展现巨大潜力。与传统方法仅通过添加误差项处理退化不确定性不同,贝叶斯方法可在获取新观测时动态更新不确定性估计。这种持续优化预测的特性对精准RUL预测至关重要[44]。贝叶斯方法最突出的优势在于,结合先验信息与观测数据可推断不确定性参数的后验概率密度函数(Probability Density Function, PDF)[45,46],表达式为 其中 为观测样本; 为待更新不确定性参数向量; 为不确定性参数先验分布向量,通常取广义无偏均匀分布, ; 为常数; 为给定条件下的条件分布,通常称为似然函数,描述给定不确定性参数 时观测样本 出现的概率;假设独立测试次数为 ,贝叶斯方程中似然函数表达式为 其中 表示实际观测,即本文构建的实际健康指标; 表示模型预测结果,即本文退化模型的健康指标预测值; 为观测协方差矩阵。将式 (6) 代入式 (5),PDF 可进一步写为 其中 为与 无关的常数。工业应用中,响应表达式通常为隐式,导致积分运算难以实现,因此通常采用随机采样方法估计PDF,以解决复杂积分运算问题。3.2.2 DRAM算法当前,Metropolis-Hastings(MH)算法是贝叶斯推理中广泛应用的随机采样方法,通过生成后验样本简化贝叶斯方程中的积分运算。但该算法主要适用于单参数不确定性场景,参数维度升高时采样效率显著下降,马尔可夫链难以捕捉统计特性[47]。为克服高维不确定性参数带来的挑战,本文引入DRAM算法实现贝叶斯推理。DRAM结合延迟拒绝策略与自适应采样,生成更高质量的后验样本,保障 RUL 预测中不确定性量化的稳定性。采样过程具体步骤如下[48, 49]:(1)设置DRAM参数:非自适应采样长度 、采样迭代次数 ,在先验分布范围内获取初始样本 ; (2)选取初始方差为 的建议分布 ,基于当前样本 通过建议分布生成候选样本 ; (3)计算 的接受概率,基于建议分布的对称性 ,表达式为 (4)选取服从 分布的变量 ,若 则接受 ,即 ;否则通过更新后建议分布 生成候选样本 ,重复步骤(3)、(4)判断是否接受候选样本;(5)采样迭代至 时,根据生成的后验样本更新建议分布协方差矩阵 : 其中 为缩放因子,为保障接受概率处于合理范围,Gelman教授建议 取值为 , 为参数维度[50]; 通常取 ; 为协方差矩阵; 为 维单位矩阵[51];(6) 迭代至 次时终止采样,得到收敛的后验样本序列,即马尔可夫链。剔除马尔可夫链非收敛燃烧期样本,即可获取不确定性参数的统计特性。4 实验案例4.1 实验装置与数据描述4.1.1 C-MAPSS数据集为评估所提刀具RUL预测方法性能,采用PHM 2010提供的刀具磨损数据集。实验环境框架与具体设置如图4所示。实验在高速数控(Computer Numerical Control, CNC)铣床上开展,工件材料为不锈钢,采用3刃铣刀铣削。每次切削中,刀具X向切削长度108mm,径向切深0.125mm,轴向切深0.2mm,主轴转速10400r/min,X向进给速度1555mm/min。选取后刀面磨损量(VB)评估刀具磨损,判定磨损标准为 VB≥0.15mm。同步开展在线信号采集与离线磨损测量。本文采集铣削过程中7路信号,具体为X、Y、Z向铣削力信号,X、Y、Z向振动信号与声发射(Acoustic Emission, AE)信号。 图4 切削实验的设置如图4所示,实验平台由四部分组成:CNC铣床、离线刀具磨损测量模块、在线信号采集模块、信号处理与存储模块。工作台与工件间安装三向Kistler测力仪,获取X、Y、Z向实时铣削力;工件上安装 Kistler 压电加速度计,采集三向振动信号;此外,工件上安装 Kistler 声发射传感器,捕捉高频应力波。采集信号经NI数据采集卡(NI DAQ)放大,采样频率50kHz。同时,采用LEICA MZ12显微镜测量每次切削后的刀具磨损量。详细设置列于表2。表2 实验平台的详细信息 铣削过程中,以50kHz采样频率采集7路信号(X/Y/Z向铣削力、X/Y/Z向振动、声发射),单把刀具共完成315次切削。为获取可靠刀具磨损监测数据,采用6把刀具开展6次切削试验,分别记为C₁–C₆。本文采用C₁–C₄监测数据评估所提方法性能。需强调,所提融合多域特征提取与基于贝叶斯不确定性量化框架的方法,适用于多种数据集。但数据集必须同时包含加工信号数据与对应刀具磨损数据,才能保障方法有效性。4.2 评估指标本文采用平均绝对误差(Mean Absolute Error, MAE)、均方根误差(Root Mean Square Error, RMSE)与决定系数 [18, 52]评估RUL预测结果。各指标介绍如下: (1)MAE。MAE 表达式为 其中 为 时刻实际RUL(i=1,2,⋯,N); 为 时刻预测RUL。MAE 越小表示预测精度越高。 (2)RMSE。RMSE表达式为 RMSE是另一常用指标,对误差大小更敏感。RMSE越小表示预测越准确。 (3) 。 表达式为 是评估拟合程度的指标,表示预测模型解释实际变化的比例,取值范围0-1,越接近1拟合效果越好。4.3 实验案例为验证特征提取对揭示刀具磨损退化趋势的重要性,以 为例,图5展示铣削力与振动全寿命信号,随切削时间波动显著,表明刀具磨损随切削次数增加而加剧。但从多通道信号中难以直接获取磨损退化趋势,需对海量信号进一步分析处理。本文提取多域24项特征(公式列于表 2),提升海量信号的信息密度。 图5 刀具在整个切削过程中的多通道信号由于刀具早期磨损退化相对缓慢,该阶段RUL预测意义有限。研究重点应放在磨损后期RUL预测,及时预测对刀具更换、降低生产风险至关重要。此外,为评估所提方法解决小样本问题的能力,仅采用磨损数据集前200次切削时刻作为训练数据更新退化模型,随后通过更新后模型实现RUL预测。从前200个数据点提取多域特征,构建健康指标作为观测量,指导DRAM随机采样过程。需注意,训练集大小影响预测精度与效率,需根据实际情况与计算机性能合理选择。同时需剔除训练集中冗余特征,保障RUL预测精度。以 为例,前200次切削时刻形成特征矩阵 。X向振动信号中提取的24项特征如图6所示。 图6 X向振动信号的24项特征 为提升预测精度与效率,需筛选特征矩阵中不敏感、冗余特征。由于退化过程通常随时间单调变化,选取与时间呈单调关系的特征最适合表征该趋势。斯皮尔曼相关系数为非参数统计量,常用于衡量两个变量间的单调关系。本文计算每项特征与对应时间向量的斯皮尔曼相关系数,表达式为 其中 为斯皮尔曼相关系数,取值范围[−1,1], 与 分别表示完全负相关与完全正相关, 表示无相关性; 为两次观测的排序差值; 为观测次数。图7展示7路信号提取特征的 计算结果,设置阈值0.9,剔除斯皮尔曼相关系数低于阈值的特征。最终, 筛选后得到特征矩阵 。需注意,不同刀具需保留的特征略有差异。 图7 不同通道信号特征的斯皮尔曼相关系数随后,如2.2节所述,多通道信号经特征提取与初步筛选后,数据量显著降低,但仍包含部分无关或冗余特征。因此,本文采用PCA技术进一步对筛选后特征降维。需注意,各通道信号特征的量纲与数量级差异较大,筛选后特征矩阵 融合前采用Z-score方法标准化。降维结果如图8所示,一阶主成分贡献率高达92%,表明一阶主成分包含原始信号92%的信息。这说明原始信号冗余度高,或主要变化集中在少数方向。因此,可保留一阶主成分替代原始信号,并采用三次指数平滑法[53]获取健康指标。 图8 前两个主成分及其累积贡献率 工程应用中,EDM通常用于描述系统与设备的退化趋势,在多种工业场景RUL预测中表现优异。EDM描述随时间呈指数速率退化的系统,其指数退化特性与电子设备老化、材料疲劳、机械部件磨损等诸多实际系统退化趋势一致。此外,EDM构建简便,模型参数具备明确物理意义。因此,本文采用EDM表征刀具退化趋势[54,55],表达式为 其中 为健康指标值; 为常数,表示刀具初始状态或初始退化程度; 为衰减幅度参数,表示刀具初始状态与寿命终点间的退化幅度; 为衰减速率参数,用于控制EDM下降速率,反映退化速度。 与 决定退化趋势,且包含多种不确定性,直接影响RUL预测精度。因此,本案例将两个未知参数作为不确定性参数 ,采用3.2.2节DRAM算法开展贝叶斯推理,再通过持续采集的实时健康指标迭代更新EDM不确定性参数。 假设不确定性参数均值服从二维独立高斯分布矩阵,标准差设为0.1,参数均值范围设为[−10,10]。依据贝叶斯理论,DRAM算法中建议分布设为对称高斯分布,初始方差设为0.8,可随推理自适应更新。为充分考虑不确定性,初始采样点在采样范围内随机生成,采样迭代20000次,非自适应阶段 设为1000。 为降低数据随机性的负面影响,按照图2所示框架,采用所提方法预测4把刀具 的RUL。图9展示4把刀具预测RUL与实际RUL的实验结果。需注意,底部绿色 区域表示预测RUL的相对误差,两条深绿色虚线表示置信度 的置信区间边界,二者包围的浅绿色 区域为置信区间,代表20%预测偏差的容忍范围。可见,受不确定性干扰,4把刀具早期预测RUL存在不同幅度波动,但随迭代估计,预测RUL逐渐逼近实际RUL。同时,预测RUL基本落在对应置信区间内,表明所提方法可缓解不确定性对预测的负面影响,通过自适应迭代推理实现各时刻更优的RUL预测。 图9 4把刀的RUL预测结果 为验证所提方法的优越性,本文实现多种常用刀具RUL预测数据驱动方法,具体为支持向量机(Support Vector Machine, SVM)[56]、长短期记忆网络(Long Short-Term Memory, LSTM)[57]与混合模型(CNN-BLSTM)[58]。同时纳入两种经典物理模型驱动方法(参考文献 [59,60])与所提方法对比。需注意,所有6种预测模型均采用 数据集前200次切削时刻数据作为训练集。随后将预测结果与图9中红色实线表示的实际RUL对比,计算3.2节所述评估指标。 具体模型参数设置如下:SVM模型包含两个超参数:惩罚参数 与径向基(Radial Basis Function, RBF)核参数 。这些参数构成二维网格空间,采用网格搜索算法与三重交叉验证策略确定最优超参数( , )。LSTM 模型中,隐藏单元数量设为特征向量维度的两倍,隐藏层与输出层分别采用双曲正切S型与对数S型激活函数。训练过程中,采用共轭梯度法更新权重与偏置,最大迭代次数设为200,丢弃率(Dropout)设为0.2以防止过拟合,性能目标设为 。混合模型及另外两种物理驱动方法的参数设置见参考文献[58,59,60]。 5种模型预测结果汇总于表3。SVM与LSTM的平均RMSE分别为7.93与6.55。相比之下,所提方法平均RMSE为5.79,降幅分别为27.00%与11.60%。SVM与LSTM的平均MAE分别为7.31与6.00。而所提方法平均MAE为5.20,降幅分别为28.86%与13.33%。结果表明,与传统方法相比,所提方法预测性能更优、更可靠,取得满意结果且具备强可行性。表3 不同现有方法实验预测结果的比较 与方法#1相比,所提方法预测结果更优,RMSE 与 MAE 平均降幅分别为 23.92% 与 23.42%。该提升源于方法#1采用标准 MH 采样算法,通常仅适用于单维参数空间。而 DRAM 算法的延迟拒绝与自适应采样策略,可在高维参数空间实现高效随机采样,进而提升退化模型参数更新效果。 如表3所示,所提模型预测精度与方法#2、混合模型相当,但后两种方法在部分数据集上精度更高。需注意,方法#2与混合模型参数更复杂,参数化成本更高,直接影响最终RUL预测精度。例如,方法#2采用贝叶斯更新与期望最大化(Expectation-Maximization, EM)算法估计退化模型参数,再通过粒子滤波算法实现状态估计。粒子滤波的大量超参数会显著影响RUL估计结果。因此,所提方法在计算成本与操作便捷性方面具备优势,是更高效的RUL预测选择。4.4 讨论对图9与表3所示实验结果综合分析表明,所提方案实现高精度RUL预测,优于常用预测方法。需强调,传统数据驱动方法通常需要大量标签数据进行离线训练,训练成本高昂。相比之下,所提方法无需标签样本,通过自适应迭代估计即可取得满意结果。这一特性表明该方法在解决无标签预测挑战方面具备巨大潜力。此外,DRAM算法的应用实现退化模型中不确定性参数的自适应更新,提升预测的不确定性表征能力与方法整体可解释性。如图9所示,RUL预测值始终落在置信区间内,凸显所提方法的可解释性与可靠性。5 结论5.1 贡献本文提出一种自适应方法,用于无标签样本数据、退化模型存在参数不确定性场景下的刀具RUL预测。所提方法主要贡献归纳为三方面:(1)无需大量带RUL标签的历史数据开展高成本离线训练,展现自适应、无监督预测潜力;(2)采用DRAM算法定量评估退化模型未知参数的不确定性,实现考虑不确定性的RUL预测迭代更新;(3)贝叶斯理论与更新后退化模型的结合,为方法提供坚实理论基础,提升可解释性。为验证所提方法可行性,采用PHM 2010刀具磨损实验数据,结果表明方法性能优于多种代表性方法。具体而言,与SVM、LSTM相比,所提方法平均RMSE分别降低27.00%与11.60%。此外,与其他代表性预测方法相比,所提方法整体预测性能更稳定。综上,所提方法在精度与可解释性方面取得显著进步,为工业系统RUL预测提供有价值思路,推动刀具可持续利用。5.2 未来研究方向未来研究初步思路如下:首先,鉴于加工场景的复杂性与非线性,将采集更多加工数据进一步验证所提方法;其次,研究退化模型快速重构与集成机制,提升方法在复杂应用场景下的适用性。编辑:陈宇航校核:李正平、陈凯歌、曹希铭、赵学功、白亮、任超、海洋、Leo、Kira、Tina、王金、赵诚、肖鑫鑫、张优该文资料搜集自网络,仅用作学术分享,不做商业用途,若侵权,后台联系小编进行删除来源:故障诊断与python学习

未登录
还没有评论
课程
培训
服务
行家
VIP会员 学习计划 福利任务
下载APP
联系我们
帮助与反馈