
不是所有问题都得上深度学习:机器学习三大家族通俗导览
在上一篇文章中,我们一起深入探讨了“深度学习”(Deep Learning)这个当下炙手可热的话题,感受了它作为人工智能领域“强力引擎”的魅力,见证了它如何通过复杂的神经网络结构,在图像识别、自然语言处理等领域取得惊人的成就。
文章完成后,一个更根本的问题也许会浮现在我们脑海中:我们一直在谈的“深度学习”,和大家常说的“机器学习”(Machine Learning),究竟是什么关系?
这是一个绝佳的问题,"黑猫白猫,抓到老鼠就是好猫",有时解决实际问题,并不需要用最酷炫的方法。今天,就让我们来看看经典机器学习三大家族,它能帮助我们建立一个真正专业的知识地图:
• “三大家族”(监督、无监督、强化学习)是三种根本不同的“任务范式”。
◦ 监督学习的任务是“照着标准答案去学习”。
◦ 无监督学习的任务是“在没有答案的数据中自主探索规律”。
◦ 强化学习的任务是“通过不断试错来学习最优策略”。
这三个家族定义了我们要解决的问题属于哪一类。
• “深度学习”与“经典算法”是用来完成这些任务的“技术工具”。
◦ 经典算法(如决策树、SVM)就像是“汽车、轮船”。它们高效、可靠,是完成大部分任务的主力军。
◦ 深度学习(各种神经网络)则像是“喷气式飞机、星际飞船”。它无比强大,专门用来解决那些经典工具难以处理的、极其复杂的任务(比如,在“监督学习”的范式下进行高精度图像识别)。
所以,深度学习并不是与三大家族并列的第四个家族。它是一种可以应用在任何一个家族内部的、更强大的引擎。 比如,在解决一个监督学习问题时,我们可以选择用“汽车”(经典算法),也可以选择用“喷气式飞机”(深度学习)。
理解了这一点,我们再来看这篇文章的目的就格外清晰了:在驾驶“喷气式飞机”之前,我们有必要先全面了解所有可用的“交通工具”,以及它们各自最适合的“任务航线”。
下面,就让我们正式开始这次巡礼,认识机器学习中最经典、最重要的“三大家族”。
第一大家族:有监督学习 (Supervised Learning)
“带着“标准答案”的应试学习。”
有监督学习是目前应用最广、最成熟的一支。它处理的问题模式非常清晰:机器像一个学生,拿着一本既有题目(输入特征)又有标准答案(输出标签)的“习题集”来学习。它的目标,就是学会从“题目”推导出“答案”的通用规律。
工程类比: 这就像我们用大量的“材料成分-工艺参数-实测性能”实验数据,去拟合一个经验公式或构建一个代理模型。我们有明确的输入和输出对应关系。
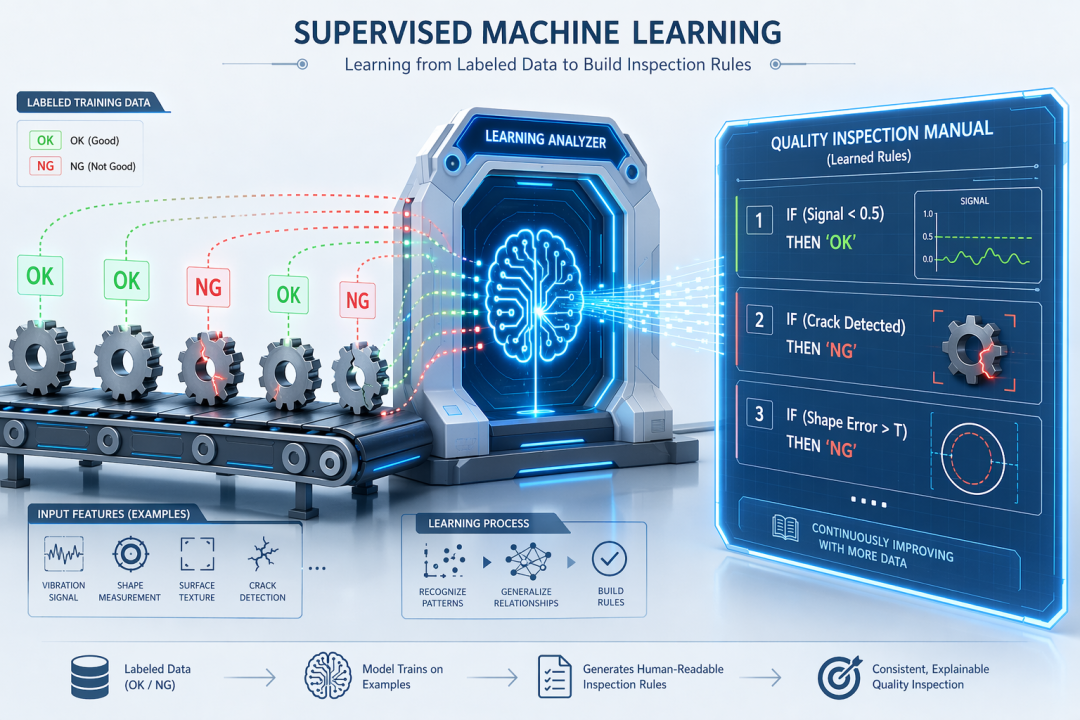
图 1 有监督学习:模型像学生一样,用带有「标准答案」的习题集训练,学会从输入特征推断输出标签
在有监督学习内部,主要解决两大类任务:
• 分类 (Classification) — 做选择题
◦ 任务:预测一个离散的“类别”。
一些代表性算法:这个领域的工具箱非常丰富,包括基于概率的逻辑回归 (Logistic Regression) 和 朴素贝叶斯 (Naive Bayes);基于几何和距离的支持向量机 (SVM) 和 K-近邻 (k-NN);以及非常强大、应用广泛的集成方法,如 决策树 (Decision Tree)、随机森林 (Random Forest) 和 梯度提升机 (Gradient Boosting Machines, 如XGBoost)。
◦ 例子:根据零件的工艺参数和无损检测信号,判断其最终是“合格”还是“不合格”。
◦ 算法应用举例 (随机森林):银行在决定是否批准一笔贷款时,不能只看单一指标。随机森林(Random Forest)算法就像组建了一个“贷款审批委员会”。委员会里的每个专家(一棵决策树)都只看申请人的一部分随机资料(如年龄、收入、信用历史),并给出自己的“批准/拒绝”投票。最终,银行根据“少数服从多数”的原则来做决定。这种集体决策的方式,远比依赖单一规则要稳健和准确。
• 回归 (Regression) — 做填空题
◦ 任务:预测一个连续的“数值”。
一些代表性算法:最基础的是线性回归 (Linear Regression) 及其变种(如岭回归 Ridge、套索回归 Lasso);同时,许多分类算法也能优雅地解决回归问题,例如支持向量回归 (SVR)、K-近邻回归,以及同样表现出色的随机森林和梯度提升机。
◦ 例子:根据混凝土的配方,预测其28天后的抗压强度具体值。
◦ 算法应用举例 (支持向量机):虽然支持向量机(SVM)常用于分类,但它的变种SVR也能出色地完成回归任务。例如,在预测二手车价格时,传统线性回归可能只找到一个大致的趋势线。而SVR会尝试找到一个“管道”,这个“管道”要尽可能地“框住”所有的数据点,同时让“管道”本身尽可能地“窄”。最终的预测线就是这个“管道”的中心线。这种方法对数据中的异常点不那么敏感,预测结果更具鲁棒性。
第二大家族:无监督学习 (Unsupervised Learning)
“在未知数据中自主“寻宝”。”
如果说有监督学习是“按图索骥”,那么无监督学习就是“自主探索”。它面对的是一堆没有“标准答案”的原始数据,需要机器自己去发现其中隐藏的结构、模式或关联。
工程类比: 就像给一个经验丰富的工程师一整箱混杂的各种型号螺栓,他能凭借自己的专业知识,将它们分门别类地整理好。
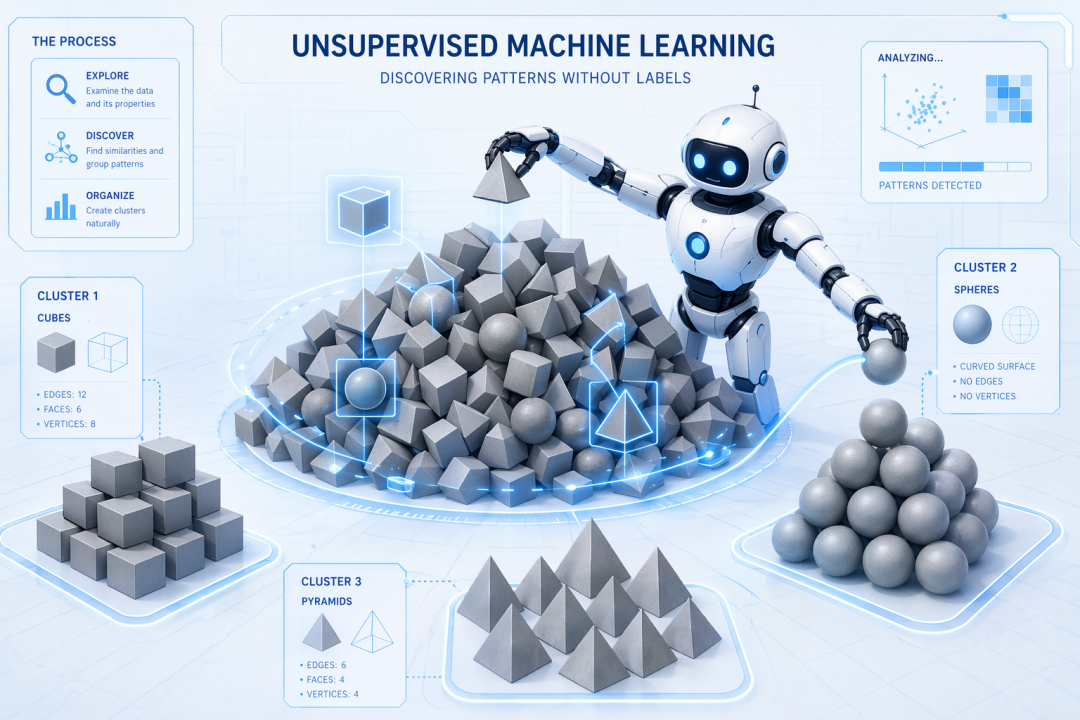
图 2 无监督学习:数据没有标准答案,模型自行在其中发现聚类、结构与隐藏关联
无监督学习最常见的两大任务是:
• 聚类 (Clustering) — 自动“站队”
◦ 任务:把相似的东西自动“归拢”到一起。
一些代表性算法:最经典的是基于划分的K-均值 (K-Means);还有能发现任意形状簇、基于密度的DBSCAN;以及可以构建出簇与簇之间层级关系的层次聚类 (Hierarchical Clustering)。
◦ 例子:对大量设备运行时的振动信号进行分析,算法可以自动将它们分为几个簇...
◦ 算法应用举例 (K-均值):一家电商平台希望对用户进行精细化运营,但事先并不知道该把用户分成几类。他们可以使用 K-均值(K-Means) 算法。将用户的购买频率、平均客单价等作为特征输入,设定K=3,算法可能会自动把用户聚成三类:“高价值VIP”、“偶发性访客”和“价格敏感型用户”。算法本身不知道这些名字,但它成功地找到了这三个具有不同特征的用户群体,为后续的精准营销打下了基础。
• 降维 (Dimensionality Reduction) — 提炼精华
◦ 任务:从纷繁复杂的数据中,提炼出最关键的核心信息。
一些代表性算法:最著名的是旨在保留数据最大方差的主成分分析 (PCA);还有在数据可视化领域表现惊艳的t-SNE 和 UMAP,它们能将高维数据投影到二维或三维空间,同时尽可能保持其内在结构。
◦ 例子:汽车碰撞安全分析收集了上百个传感器的数据,降维就是要找到几个最关键的“主变量”来概括整个过程。
◦ 算法应用举例 (主成分分析):在人脸识别中,一张高清人脸照片可能包含数万个像素点(维度)。直接处理这些海量像素点效率极低。主成分分析(PCA)可以从成千上万张人脸中,提取出几十个最关键的“特征脸”(Eigenfaces)。这些“特征脸”就像是人脸的“主成分”,抓住了所有人脸变化的最主要方向(如脸型轮廓、眉眼间距等)。之后,任何一张新的人脸都可以用这几十个“特征脸”的线性组合来近似表示,维度从几万降到了几十,极大提升了识别效率。
第三大家族:强化学习 (Reinforcement Learning)
“在不断“试错”中学习最优策略。”
这是三大家族中最“智能”的一支。机器像一个学徒或玩家,在一个特定环境里通过不断“尝试”来学习:它每做出一个动作,环境就会回馈一个“奖励”或“惩罚”的信号,告诉它这一步是好是坏。机器手里并没有现成的“标准答案”可抄,只能在一次次试错中,根据累积起来的奖惩反馈,慢慢调整自己的行为倾向。它的目标是学会在什么状态下应该采取什么行动,以获得最大的长期总回报。
一些代表性算法:强化学习的算法演进非常精彩,从最基础的、基于价值表的 Q-Learning 和 SARSA,到直接学习策略函数的策略梯度 (Policy Gradient)方法,再到结合两者优点的演员-评论家 (Actor-Critic)框架(如A2C, A3C),最终与深度学习结合,诞生了像深度Q网络 (DQN)这样的强大智能体。
工程类比: 这非常类似于“最优控制”。比如,一个机械臂要学习如何最快最稳地抓取一个流水线上的物体,通过成千上万次的尝试,它最终会学到一条最优的运动策略。
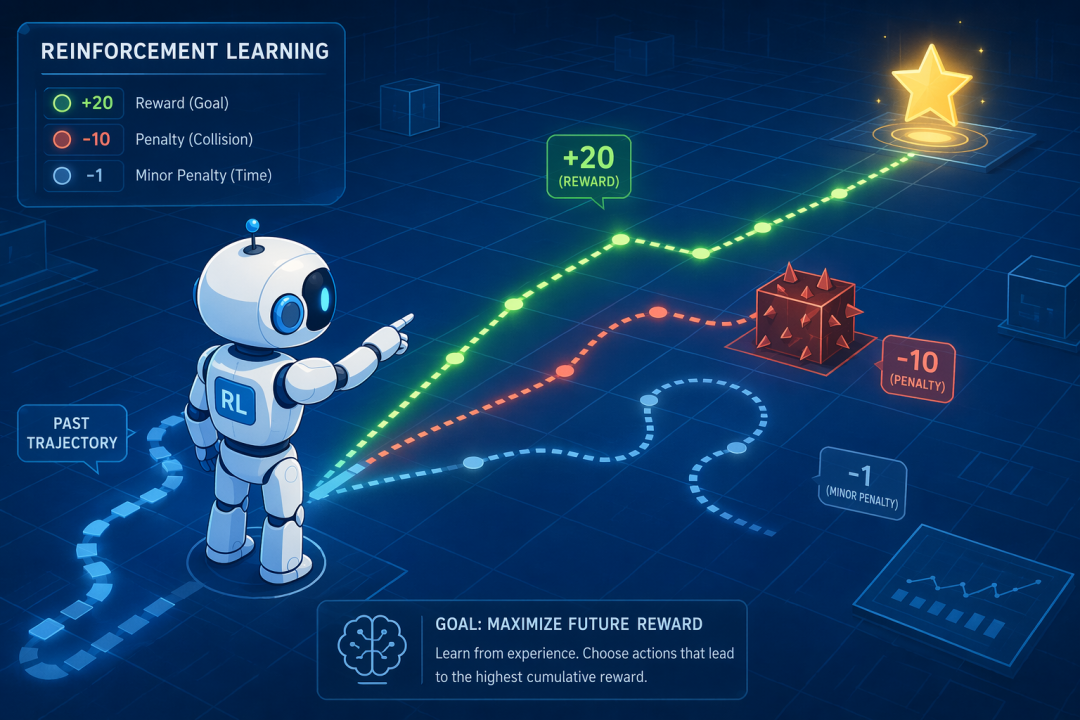
图 3 强化学习:智能体在与环境反复试错、奖惩反馈中,学习长期回报最大的行动策略
结语
现在,我们可以为这三大家族画一幅简洁的肖像画:
• 有监督学习:手握标准答案,学得快,是当下创造最多商业价值的“实干派”。
• 无监督学习:没有外部指导,自主探索,是数据挖掘和异常检测的“探险家”。
• 强化学习:面向未来决策,在与环境的互动中进化,是通往通用人工智能的“梦想家”。
当然,机器学习的世界并非总是泾渭分明。但无论方法如何演进,都离不开这三种最基本的学习思想。理解了它们,就等于拿到了开启机器学习大门的钥匙。希望这篇导览,能帮助您在未来的“CAE+AI”探索之路上,看得更清、走得更远。
参考文献 (References)
一份严谨的参考书目是专业性的体现。本节整合了机器学习领域的经典教材与里程碑式的论文,旨在为希望深入探索的读者提供一份权威且精确的导航图。
[全局理论框架]
1. Hastie, T., Tibshirani, R., & Friedman, J. (2009). The Elements of Statistical Learning. Springer.
2. Sutton, R. S., & Barto, A. G. (2018). Reinforcement Learning: An Introduction. MIT Press.
[核心算法溯源]
3. Cortes, C., & Vapnik, V. (1995). Support-vector networks. Machine Learning, 20(3).
4. Breiman, L. (2001). Random Forests. Machine Learning, 45(1).
5. Freund, Y., & Schapire, R. E. (1997). A decision-theoretic generalization of on-line learning and an application to boosting. Journal of Computer and System Sciences, 55(1).
6. MacQueen, J. (1967). Some methods for classification and a nalysis of multivariate observations. Proceedings of the fifth Berkeley symposium on mathematical statistics and probability, 1.
7. Pearson, K. (1901). On Lines and Planes of Closest Fit to Systems of Points in Space. Philosophical Magazine, 2(11).
[前沿与融合]
8. Mnih, V., et al. (2015). Human-level control through deep reinforcement learning. Nature, 518(7540).


