HyperStudy_随机方法比较:Arm模型的随机研究 HS-5000
了解如何使用相同的拟合函数执行随机研究和基于可靠性的设计优化(RBDO)。
开始之前,请完成HS-4000:优化方法比较:手臂模型形状优化或导入HS-4000.hstx存档文件(可在 /HS-5000/ 中找到)。
您将围绕名义点运行随机研究。
在随机研究中,您将连续使用100、300和1000次运行的Hammersley分布,以比较统计结果的收敛性。您将所有6个Inputs Variable定义为遵循正态分布的随机变量。
一、运行Stochastic
在此步骤中,您将检查使用GRSM找到的最优解的稳健性。
1.添加随机指标。
a)在Explorer中,右键单击并从上下文菜单中选择Add。
此时将打开Add对话框。
b)对于Definition from ,选择一种方法。
c)选择Stochastic,然后单击OK。
2.转到Stochastic 1>Definition>Define Input Variables步骤。
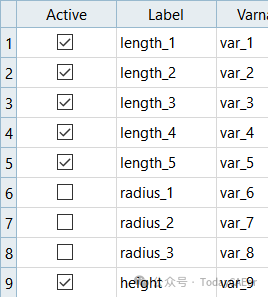
3.在活动列中,清除radius_1、radius_2和radius_3复选框。
4.复 制最优设计中的参数值。
对于随机研究,您必须提供有关参数的标准方差σ(或方差σ²)的数据,以便考虑不确定性。默认情况下,在HyperStudy中,σ² 使用范围规则σ² =((上限-下限)/4)²) 计算,该规则是Inputs Variable边界的函数。如果您没有关于标准差的可靠数据,则可以通过更改参数的上限和下限来修改默认σ²。
a)转到Optimization 3(GRSM, 6 IV, Exact Solver)>Evaluate步骤。
b)单击Iteration History选项卡。
c)为length_1、length_2、length_3、length_4和length_5参数选择最佳参数值,然后右键单击并从上下文菜单中选择Copy。
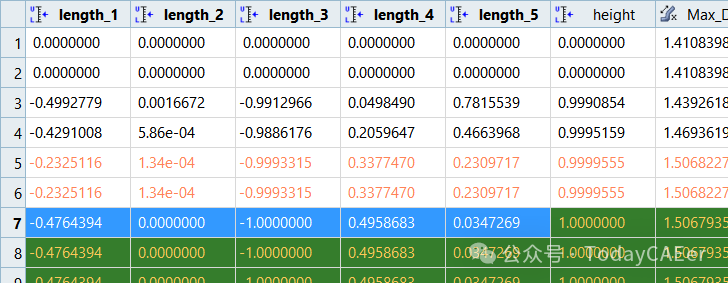
d)转到Stochastic 1>Definition>Define Input Variables步骤。
e)选择length_1、length_2、length_3、length_4和length_5的Nominal字段,然后右键单击并从上下文菜单中选择Paste transpose。
f)对于height,将Nominal值更改为1.0。
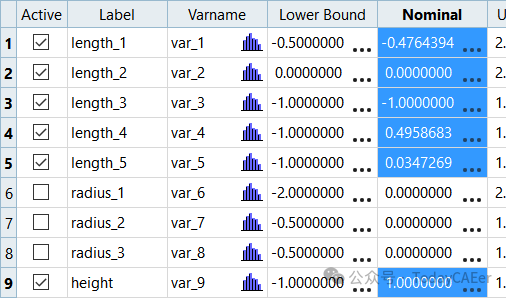
5.更改每个活动Inputs Variable的下限和上限,以匹配尺寸的公差。
在本教程中,假设公差在0.05 mm以内。
a)对于所有活动的Inputs Variable,单击 (...) 在Nominal字段中。
b)在弹出窗口的Value field中,输入0.05并单击 +/-。
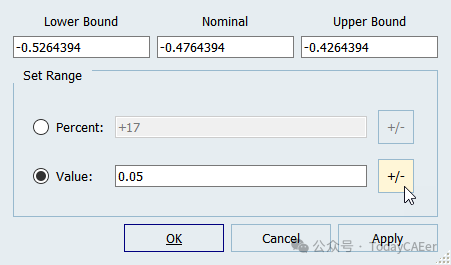
c)单击OK。
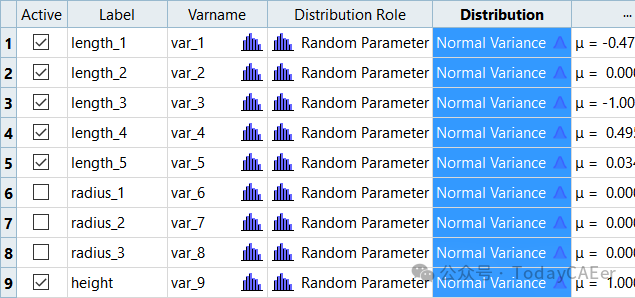
所有活动Inputs Variable的Lower bounds和Upper bounds应复 制下图。
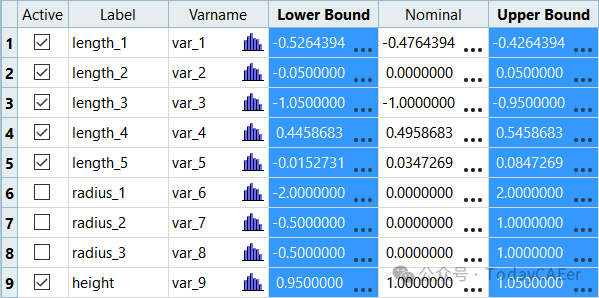
6.单击Distributions选项卡,并验证所有活动Inputs Variable的Distribution是否设置为Normal Variance。
查看第1列和第2列。第1列显示名义参数值,第2列显示方差σ²,该方差是使用参数围绕其平均值的标准差σ计算得出的。
方差的计算方式如下:σ² =((上限-下限)/4)²。例如,Inputs Variable length_1的方差为σ²=((-0.45+0.55)/4)²=6.25e-4。
7.转到Stochastic 1>Definition>Define Output Responses步骤。
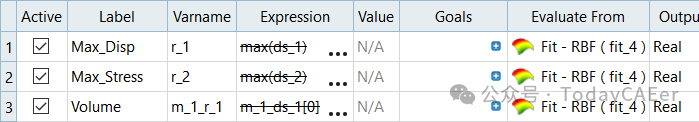
8.在工作区的Evaluate From列中,为所有输出响应选择Fit - RBF(fit_4)。
即使Max_stress未在优化中使用,您也将在Stochastic研究中使用它来检查可靠性。
9.定义规范。
a)转到Stochastic 1>Specifications步骤。
b)在工作区中,将Mode设置为Hammersley。
Hammersley抽样属于准蒙特卡洛方法的类别。此方法使用基于Hammersley点的准随机数生成器对单位超立方体进行均匀采样。
c)单击Apply。
10.评估任务。
a)转到Stochastic>Evaluate步骤。
b)单击Evaluate Tasks。
11.研究方法收敛性。
a)返回到Specifications步骤。在Settings选项卡中,将Number of Runs更改为300,然后更改为1000。
b)转到Evaluate步骤,然后单击Evaluate Tasks。
二、后处理随机结果
1.转到Stochastic 1>Post- Processing步骤。
2.查看围绕名义型设计的Inputs Variable和输出响应的统计量。
a)单击Integrity选项卡。
b)使用Channel选择器,选择Health类别以获取统计数据的汇总视图,并发现最终、缺失或错误的值。
Range列可用于了解数据中值从最小值到最大值的分布。
3.查看随机指标结果的直方图。
a)单击Distribution选项卡。
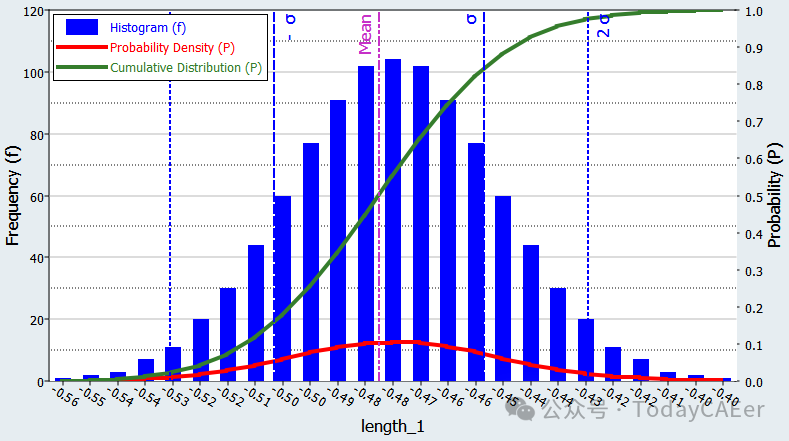
b)使用Channel选择器,选择Length 1。
该图表显示有关所选Inputs Variable的值分布的三条信息。直方图使用左轴,表示产生响应值子范围的运行频率。Probability density(概率密度) 使用右轴,表示Inputs Variable采用特定值的相对可能性。值越高,表示出现这些值的可能性越大。Cumulative distribution(累积分布) 是使用右轴的另一条曲线。它等于Probability density的积分。Cumulative distribution的值表示低于值阈值的数据百分比。请注意,累积分布的初始值将始终等于0,CDF的最终值将始终为1.0。这是因为所有数据都将位于上限和下限之间。
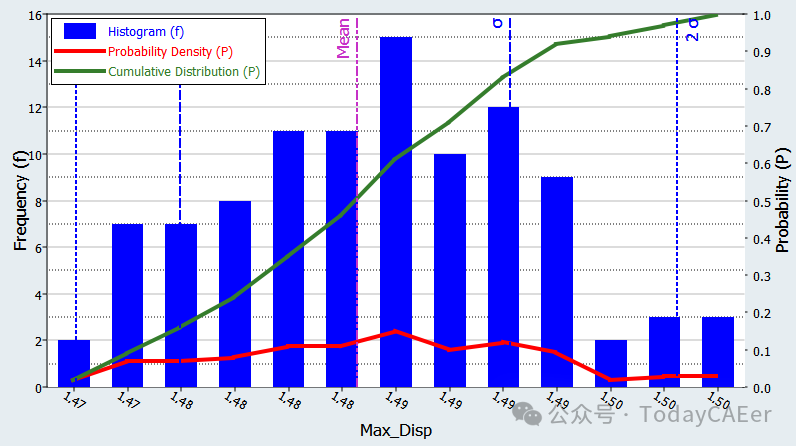
4.查看Max_Disp的概率密度和累积分布。将获得的分布与Hammersley的不同运行数(100、300和1000)进行比较。
Note: 你可以看到从100次到300次运行的变化很大,但从300次到1000次运行的变化很小。
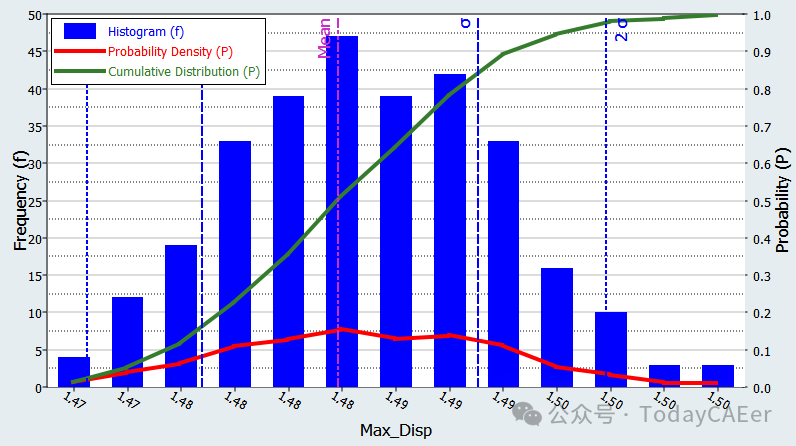
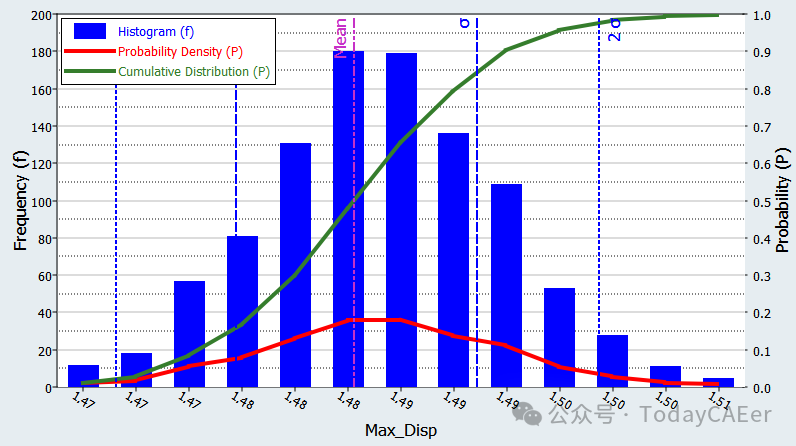
5.估计输出响应的失败概率(输出响应违反用户所选边界的概率)。
a)单击Reliability选项卡。
b)单击Add Reliability。
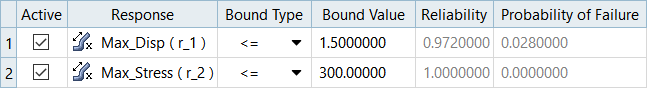
c)定义可靠性。
Bound Values是来自优化问题定义(Max_Disp<=1.5) 的值。
  将Response设置为Max_Disp(r_1)。

将Bound Type设置为 <=。

对于Bound Value,输入1.50。
结果显示了Hammersley方法在运行数函数中的收敛性。通过增加运行次数来增强收敛性。由于使用300次或1000次运行获得的结果非常相似,因此您可以假设在这种情况下,300次运行足以获得准确的结果。



d)通过在Bound Value列中输入不同的值来研究边界对可靠性的影响。
e)Optional:检查Max_Stress的可靠性。
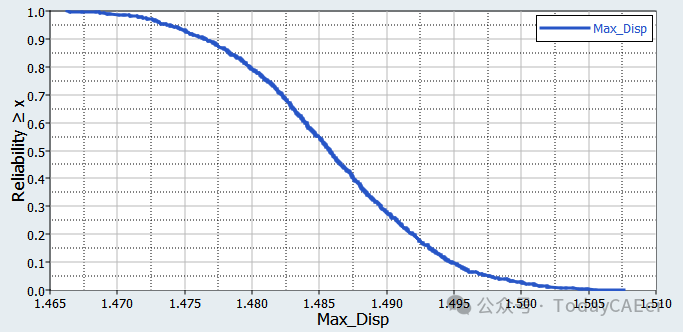
6.单击Reliability Plot选项卡,查看所需阈值与系统可靠性之间的关系。
可以在这些可靠性曲线上观察到Reliability选项卡的Reliability列中报告的值。在Max_Disp可靠性曲线上,只有11.4% 的设计值高于1.5,这意味着88.6% 的设计低于1.5。通过将Max_Disp的阈值更改为1.49763可以达到95% 的可靠性。
三、运行基于可靠性的优化(RBDO)
在此步骤中,您将在Optimization constraint(max_disp < 1.5 mm) 上搜索95% 的可靠性。
您将使用拟合函数而不是精确求解器来评估输出响应。在近似值中,您将使用通过MELS DOE创建的RBF。因此,您将使用SORA方法。您将继续使用6个重要的Inputs Variable,它们都服从正态分布。您将使用GRSM从先前获得的最优解开始优化。
1.添加优化。
a)在Explorer中,右键单击并从上下文菜单中选择Add。
b)在Add对话框中,选择Optimization。
c)对于Definition from,选择一种方法,然后单击OK。
2.转到Optimization 7>Definition>Define Input Variables步骤。
3.在Active列中,清除radius_1、 radius_2和radius_3复选框。
4.复 制最优设计中的参数值。
a)转到Optimization 3(GRSM, 6 IV, Exact Solver)>Evaluate步骤。
b)单击Iteration History选项卡。
c)找到最优设计并复 制length_1、length_2、length_3、length_4和length_5参数值。
d)转到Optimization 7>Definition>Define Input Variables步骤。
e)选择length_1、length_2、length_3、length_4和length_5的名义字段,然后右键单击并从上下文菜单中选择Paste transpose。
f)对于height,将Nominal值更改为1.0。
5.修改分发。
a)单击Distributions选项卡。
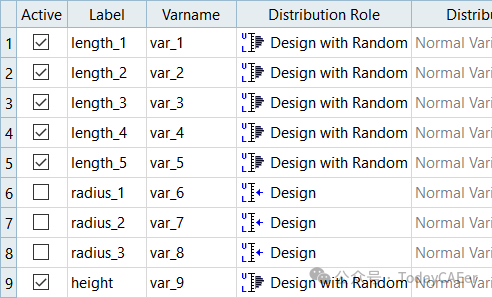
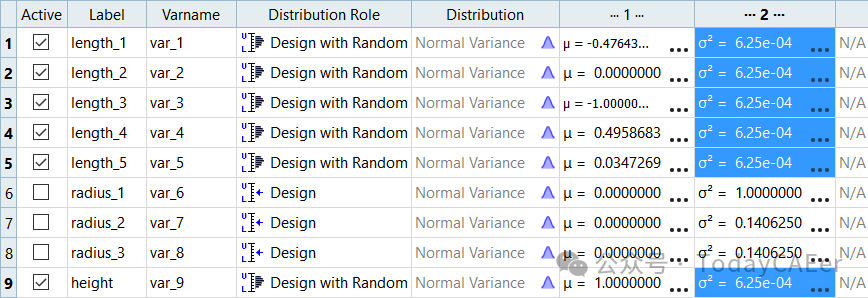
b)在Distribution Role列中,为所有Active Inputs Variable选择Design和Random。
c)在第2列中,为所有活动Inputs Variable输入6.25e-04。
6.转到Optimization 7>Definition>Define Output Responses步骤。
7.单击Objectives/Constraints - Goals选项卡。
8.对Volume Output Response应用目标。
a)单击Add Goal。
b)在Apply On列中,选择Volume。
c)在Type列中,选择Minimize。

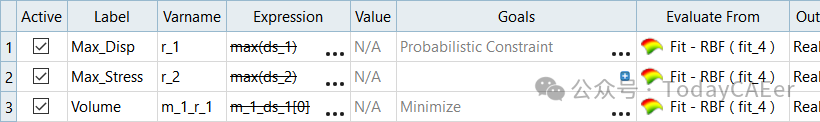
9.对Max_Disp输出响应应用Constraint。
a)单击Add Goal。
b)在Apply On列中,选择Max_Disp。
c)在Type列中,选择More。
d)在第1列中,选择Probabilistic Constraint。
e)在第2列中,输入<= 1.5000000,CDF=95.000000。

10.修改评估源。
a)单击Define Output Responses选项卡。
b)在Evaluate From列中,为所有输出响应选择Fit - RBF(fit_4)。
11.定义规范。
a)转到Optimization 7>Specifications步骤。
b)在工作区中,将Mode设置为Sequential Optimization and Reliability Assessment(SORA)。
c)单击Apply。
12.评估任务。
a)转到Optimization 7>Evaluate步骤。
b)单击Evaluate Tasks。
13.单击Iteration History选项卡,在表中查看Optimization的结果。
首先找到确定性最优值。正如您在迭代1中看到的那样,位移位于约束边界处。此设计并非本概率优化研究中要求的95% 可靠。SORA将努力确保约束满足概率要求。如迭代2所示,满足95% 可靠性的设计是最大位移从1.5的边界偏移的设计。与此改进相对应,目标值(volume) 有所增加。

四、运行验证随机指标
由于SORA使用近似方法进行可靠性计算,因此建议您在优化后进行验证随机研究。
1.复 制随机方法。
a)在资源管理器中,右键单击Stochastic 1(Hammersley),然后从上下文菜单中选择Copy。
b)在Copy对话框的Label字段中,输入Validation SORA然后单击OK。
2.将SORA优化中的最优解复 制并粘贴到验证SORA随机研究的Inputs Variable的名义列中。
a)转到Optimization 7>Evaluate步骤。
b)单击Iteration History选项卡。
c)复 制length_1、length_2、length_3、length_4和length_5最佳参数值。
d)转到Validation SORA>Definition>Define Input Variables步骤。
e)选择length_1、length_2、length_3、length_4和length_5的Nominal字段,然后右键单击并从上下文菜单中选择Paste transpose。
3.更改每个活动Inputs Variable的下限和上限,以匹配尺寸的公差。
在本教程中,假设公差在0.05 mm以内。
a)对于所有活动Inputs Variable,在Nominal字段中,单击 (...) 的。
b)在弹出窗口的Value field中,输入0.05并单击+/-。
c)单击OK接受更改并关闭弹出窗口。
4.定义规范。
a)转到Validation SORA>Specifications步骤。
b)验证Mode是否设置为Hammersley。
c)在Settings选项卡中,验证Number of Runs是否为1000。
d)单击Apply。
5.评估任务。
a)转到Validation SORA>Evaluate步骤。
b)单击Evaluate Tasks。
6.转到Validation SORA>Post-Processing步骤。
7.在Max_Disp上添加可靠性。
a)单击Reliability选项卡。
b)单击Add Reliability。
c)定义可靠性。
  将Response设置为Max_Disp。

将Bound Type设置为 <= 。

对于Bound Value,输入1.50。
结果证实,使用SORA找到的最佳解在95% 时是可靠的。