
YOLO效果不好,这是个数据问题~
致力于数字孪生体技术的研究与发展
通过解决方案和工程化应用造福人类
内容源自:GIS小丸子
有不少的朋友咨询我,为什么他们使用YOLO检测的效果都不太好,还有一些朋友说他们使用大模型做目标检测的效果也不好,然后让我推荐有没有更好的模型。
YOLO当然是有它的上限的,但是现在的模型在相同参数规格下,其实效果也都是基本雷同,即使在一些基准跑分上有几个百分点的差别,但是这点差别在实际应用中其实感受也不是很明显,模型架构也是一个充分竞争的市场。
因而决定模型效果好与不好,更多的是体现在「场景偏好」上,这个模型能不能在你们的这个场景下work,而决定「场景偏好」的就是「数据训练」。
所以大家在将效果不好的原因归因为「模型不好」之前,需要先看一下自己是否有将「数据工作」做扎实了,这是我们在应用层面能够发挥最大「主动性」的工作。
摘要
为提高高级驾驶辅助系统(ADAS)对驾驶员行为识别的准确性与可解释性,本文提出一种集成学习框架,融合深度学习与可解释人工智能(XAI)。利用ResNet50、DenseNet201和InceptionV3提取眼部区域图像特征,并通过XGBoost分类器进行融合分类。该框架在八类眼动相关驾驶行为上取得94.90%的整体准确率与0.97的平均AUC。基于SHAP的分析表明,上侧与侧向凝视特征对专注驾驶状态呈正向贡献,而下侧凝视、眨眼及瞳孔相关特征则是分心行为的主要驱动因素。该研究实现了透明、行为感知的驾驶员状态监测,为自适应、可解释的ADAS系统开发提供了支持。
和应用场景匹配的数据集
用贴合目标场景的数据集来进行模型场景化的训练应该是基本的要求,但是这也是大家一开始做的时候最容易忽略的。
因为采集数据和制作数据是一件「非常具体而且耗时」的工作,大家一般还是会选择下载一些公开数据集或者直接从淘 宝上购买一些现成的「同名」的数据集来直接训练使用,自己可能都没有仔细看一下这个数据集的内容以及样本的分布,直接微调训练,然后直接应用到场景,这个工作就直接结束了。
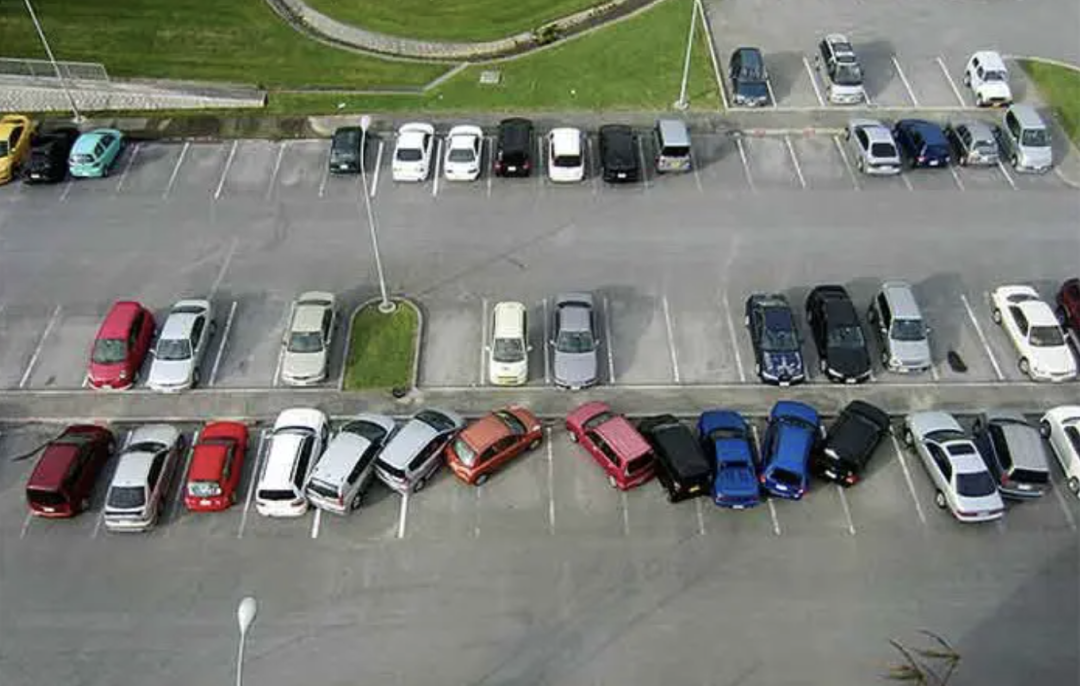
比如我们之前在做无人机的巡检的时候想检测比如下方这个「违规停车」这个场景,但是需要首先把这个问题拆解为一个「目标检测」问题。
比如是:车身不正的车辆,占用多车位的车辆还是未停在车位中的车辆。
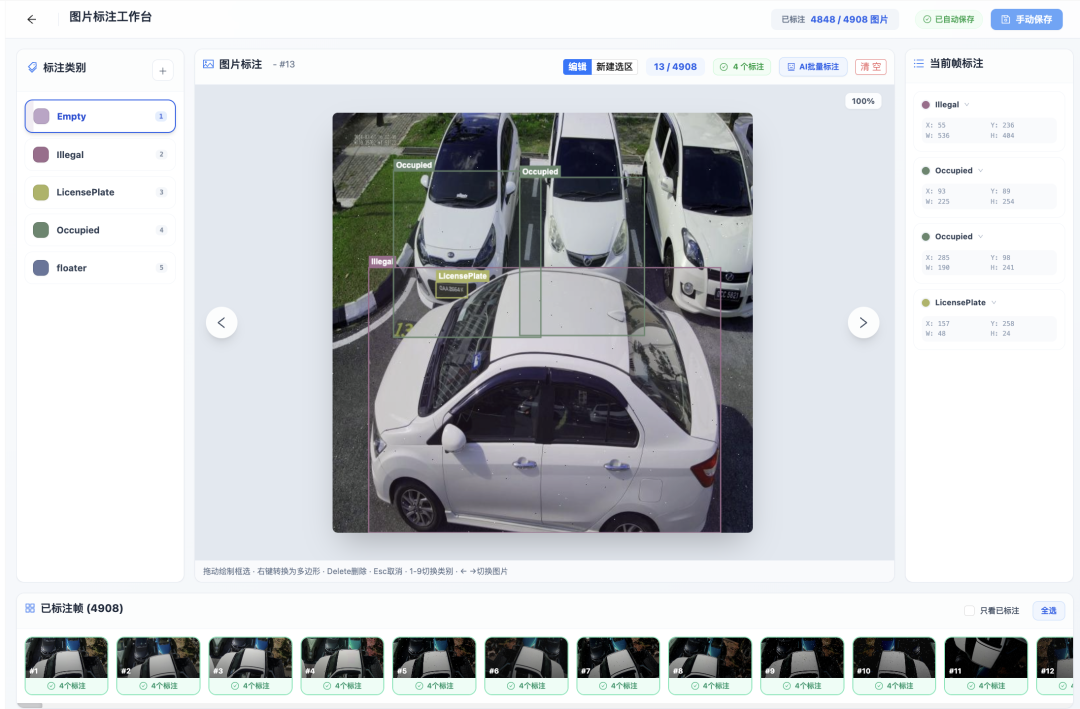
但是仔细看一下这个数据集,其实是做车位的目标检测,子类型包括占用和未被占用状态,但是目标场景中基本上是看不到停车位的,所以这是一种不匹配,而且这是摄像头视角白天的数据集,不匹配无人机视角也没有晚上的暗光环境的数据。
世界模型的合成数据集
当然因为我们做的很多目标检测主要针对的就是一些异常的场景,这些异常场景都是偶发的,所以收集数据也变成了一件困难的事情,所以针对这些场景我一般的处理方法包括三类:
1、地图影像数据收集
比如针对「违规停车」这个场景,我们还是要首先去尝试收集一些公开能用数据,无论是互联网图片还是从高清的影像中下载,或者是从其他的数据集中进行抽取,但是这些依然是一个细致的工作。
比如可以通过视觉推理在高清的卫星影像中来进行搜索对应的目标样本,这是一个海量的资源,但是利用视觉推理的时候尽量用自己本地部署的模型,不然Token消耗比较高,部署就在后台运行就好了。
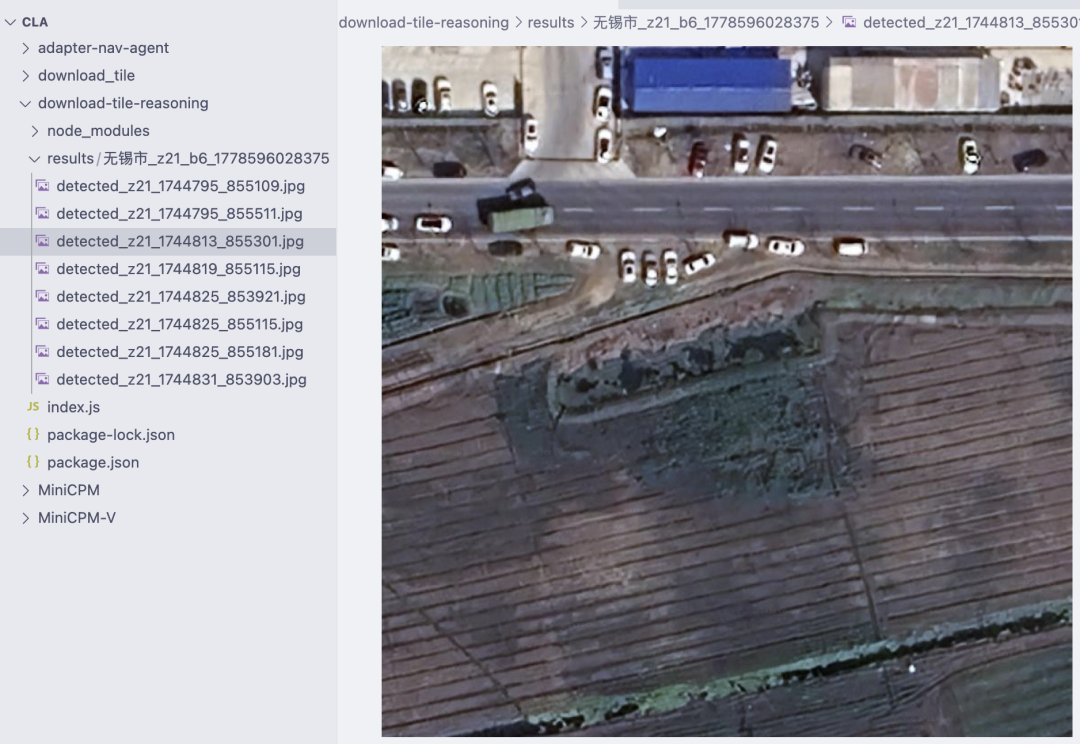
比如这些都是可以搜索到的一些比较典型的车身不正的样本数据。
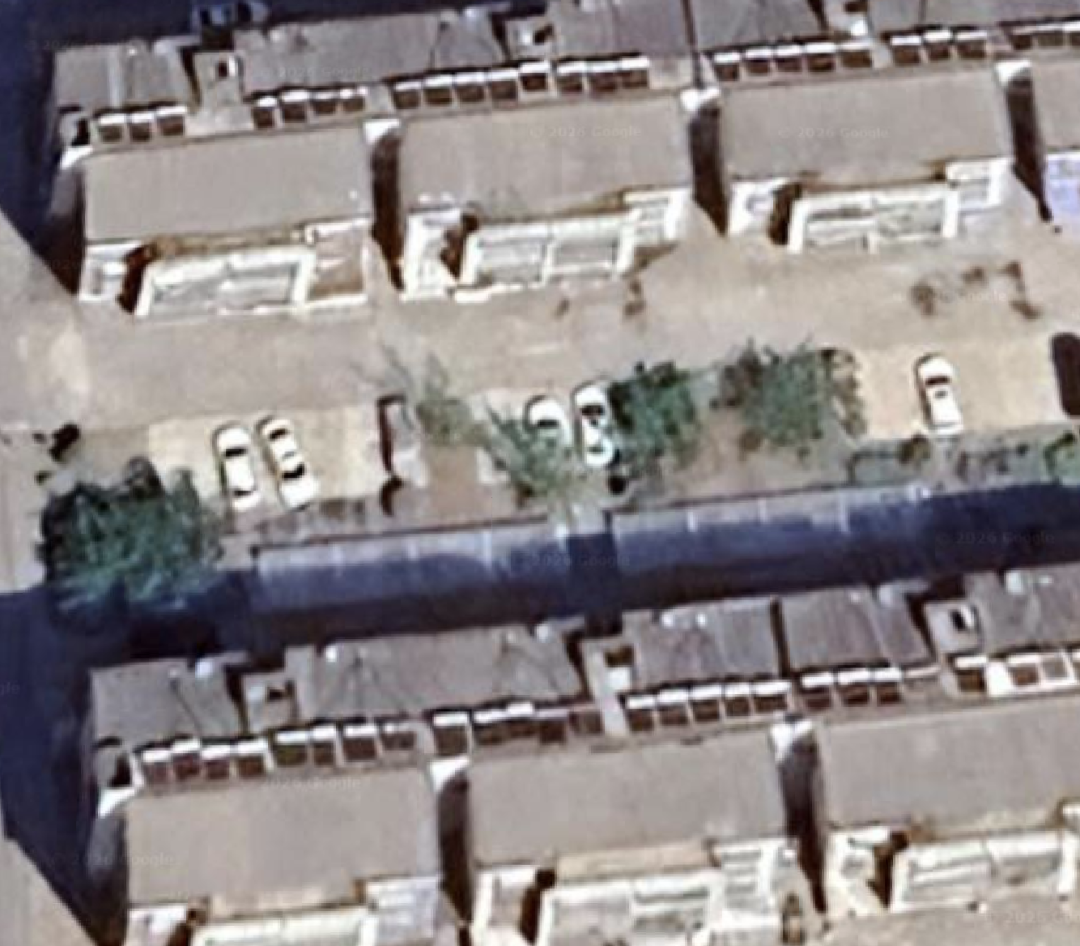
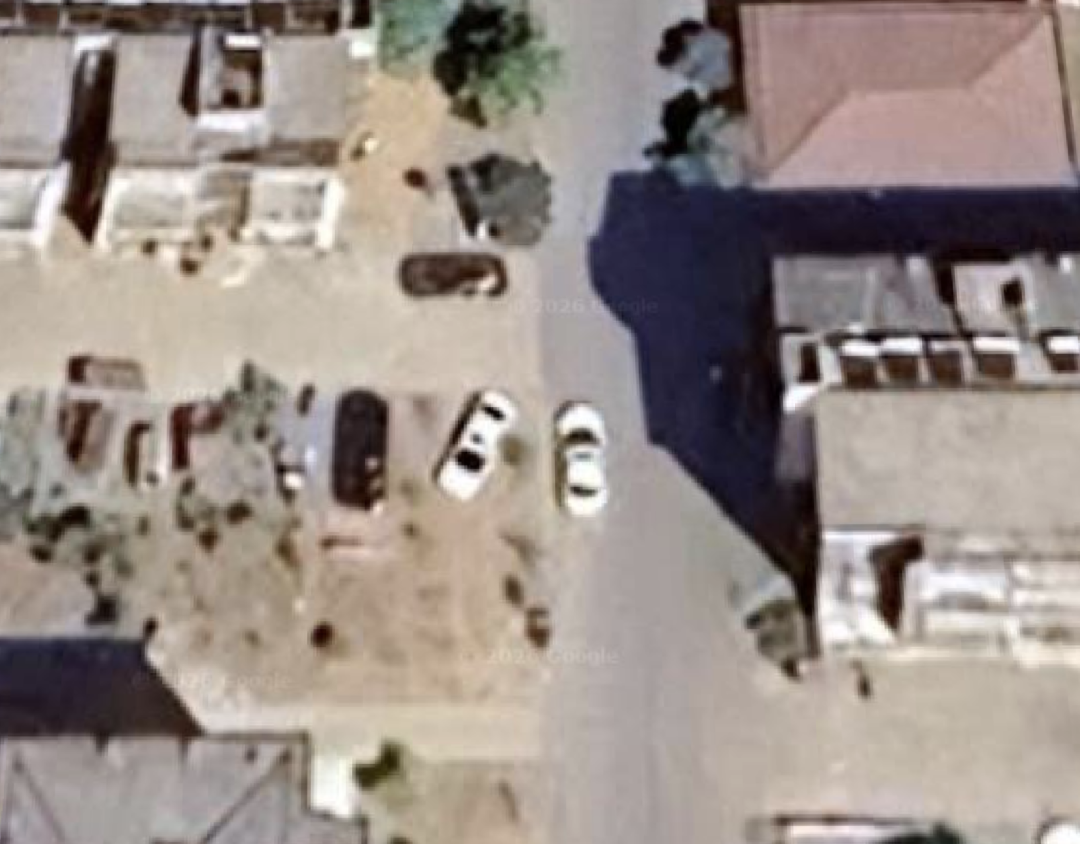
而且如果对应的场景可以在美区找到的话,使用美区的Google数据的话,可以获得更加高清的数据样本,其实完全可以用于无人机等场景的数据采集以及筛选。
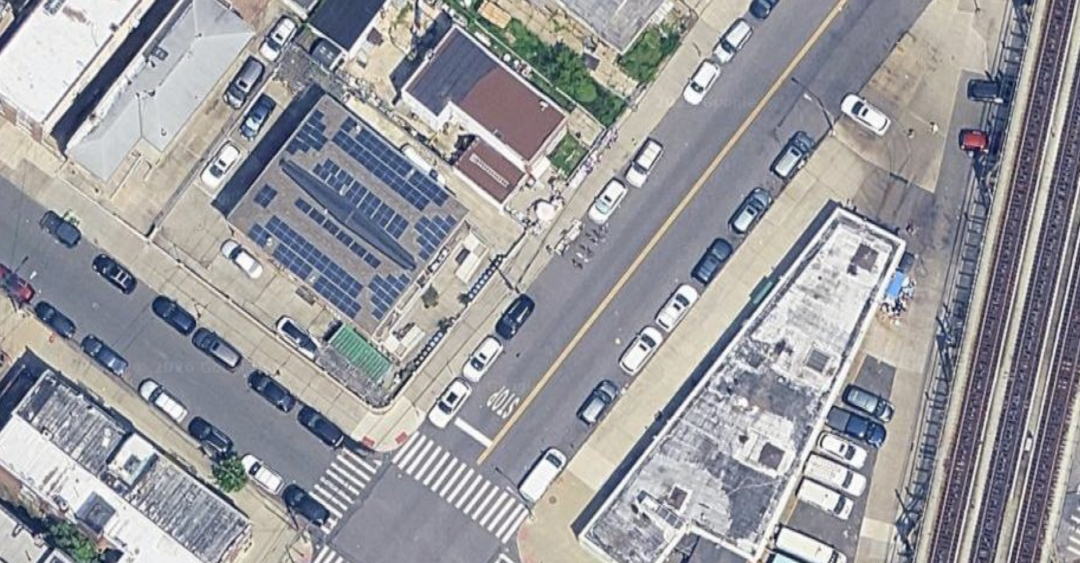
2、互联网图片收集
这种方式其实也是类似采用图片爬取的方式,在公开的图源中搜索筛选符合目标特征的数据集,比如如下这种类型的样本数据,但是这种自动化的筛选也同样要依靠VLM模型的视觉推理才可以。
3、利用生图模型生成样本
这种模式其实我在之前很多篇的文章中都介绍过这种方式,当然现在都把这种图片生成和视频生成模型都叫做能够预测环境状态的世界模型。
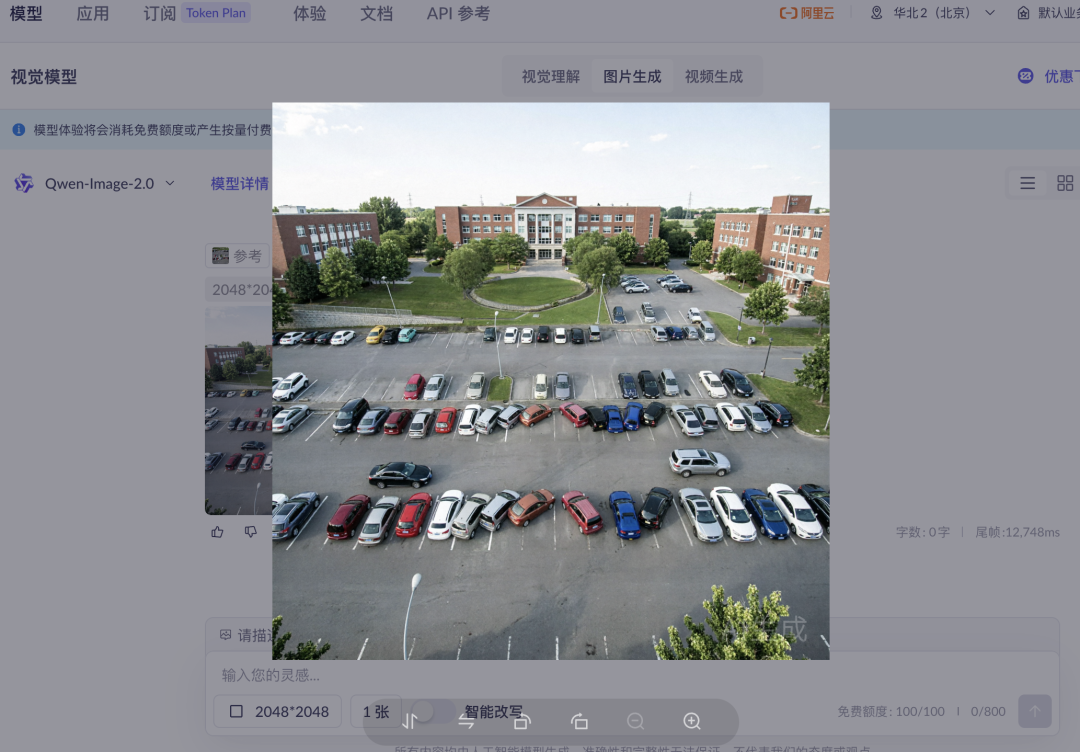
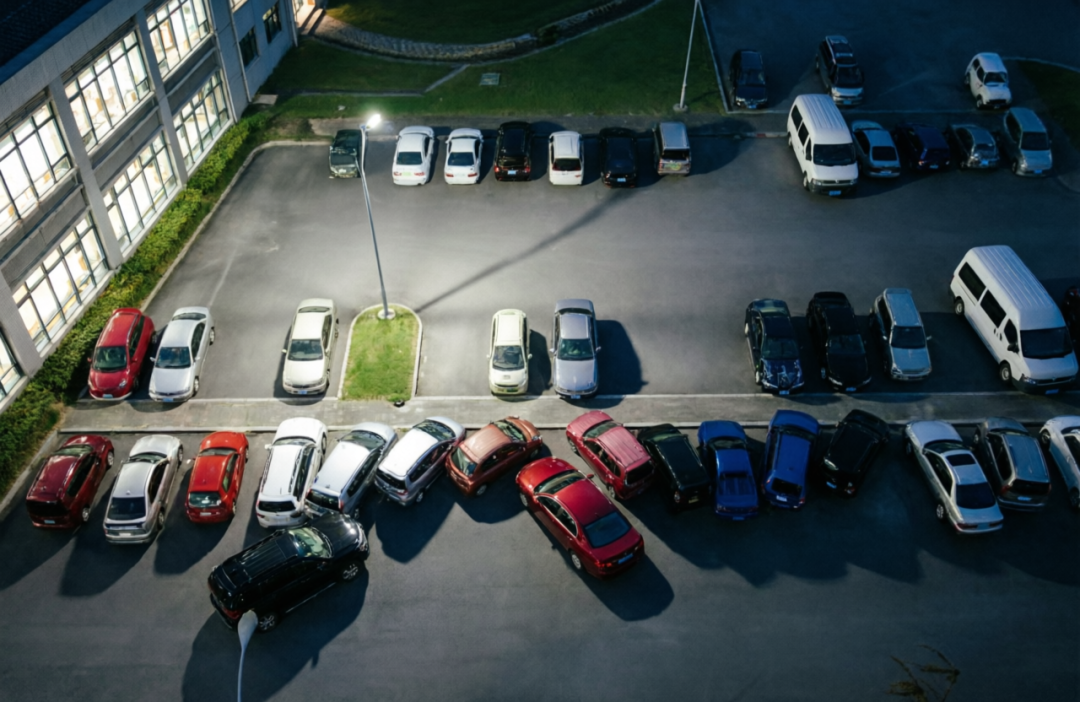
比如可以使用上面的那种互联网搜索得到的图片,然后使用类似Qwen-Image-2.0的图片生成工具来进行样本的扩展,由于现在图片生成的能力已经非常强大了,所以可以考虑在一些基本的场景提示以及多样化的提示词下来扩展生成训练数据。
这种本质上也算是一个比较情况化的蒸馏,这个部分目前做的还比较少,近期我也在尝试做一个这样的工具,然后再分享出来。
提示词:参考附件中的图,生成在校园环境下 违规乱停车的图片。
提示词:参考附件中的图,生成夜晚模式下,有车辆乱停车的图,旁边有教学楼,地面没有车道线。
多样化的数据标注方式
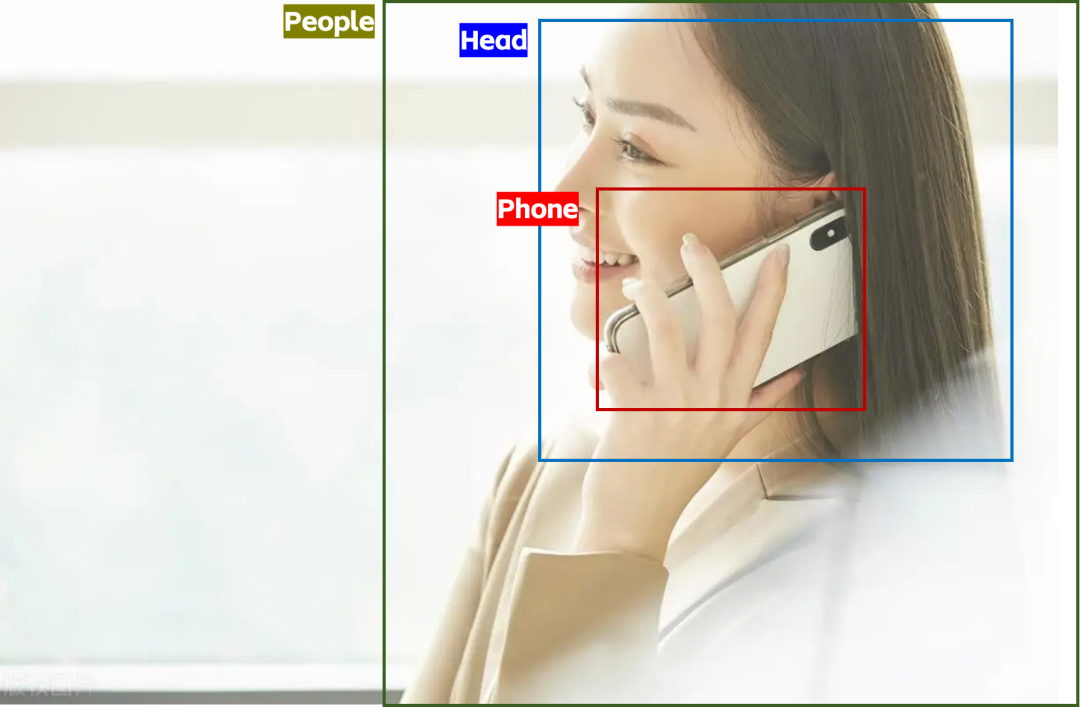
根据上面的一些介绍,其实目标检测的主要还是目标对象,对于又一些复杂的目标或者行为就需要将其拆解为一些更加原子的目标组合:
比如针对「打电话」这个行为的「目标检测」,就需要转换为如下的「People」、「Head」以及「Phone」这三个原子类别的检测,然后再进行关系的判定。
在比如在之前文章中提到的农机自动驾驶中的「驾驶轨迹」的目标检测就转换为作物「行间」的目标检测。
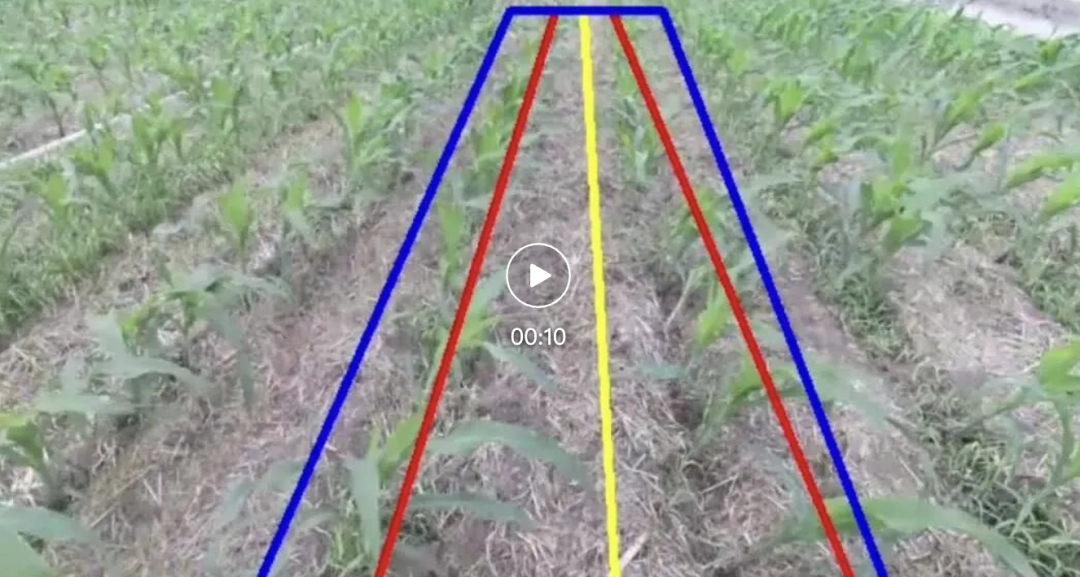
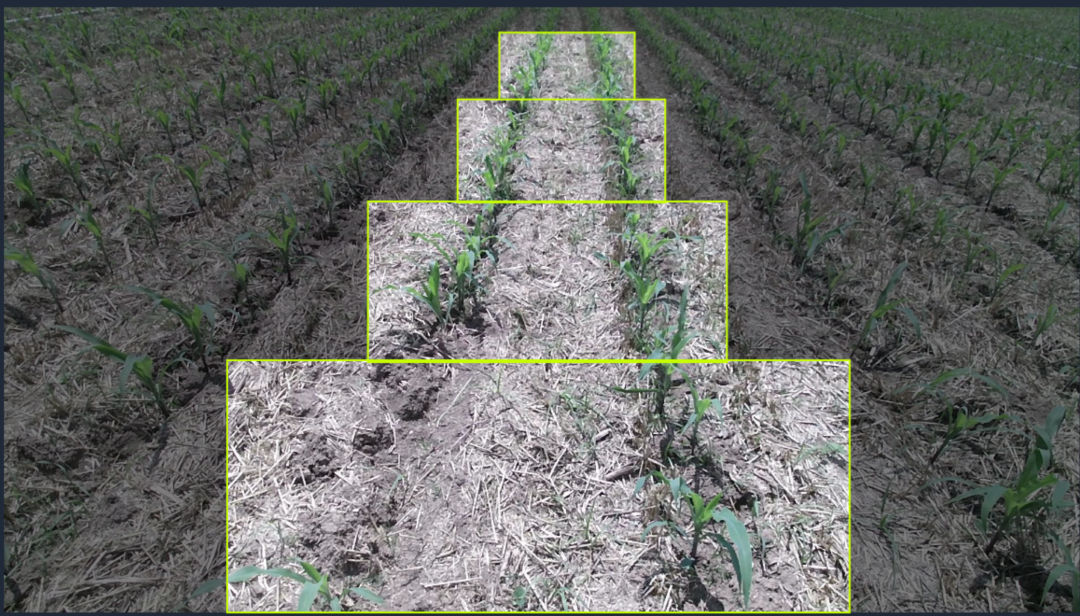
而为了检测作物的「行间」,在数据标注的时候有采用了这种多个目标框堆叠的方式来来进行数据标注,然后再提取检测框中中心线,从而来「驾驶轨迹」的目标检测。
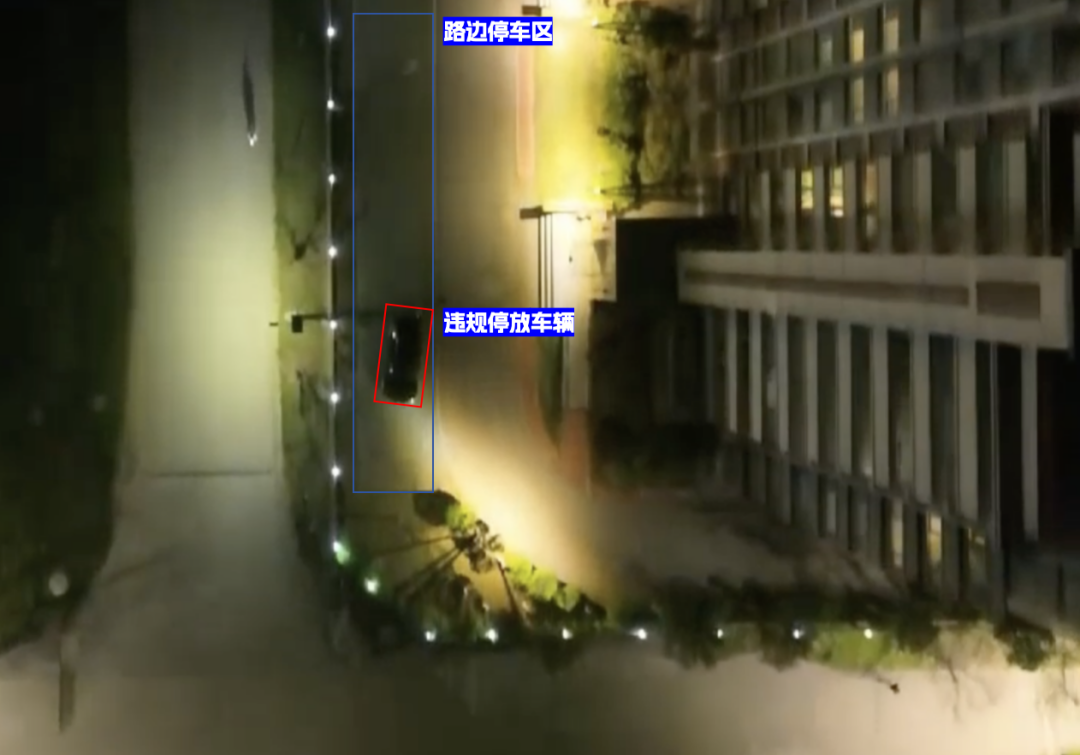
其实对于「车辆违停」的这个场景也可以采用同样的策略,将车身不正这个目标转换为对没有车位的停车区和带有OBB形式的车辆的检测,这样再进行检测框的计算,当然这在标注上而这也是要同时标注在一张上。
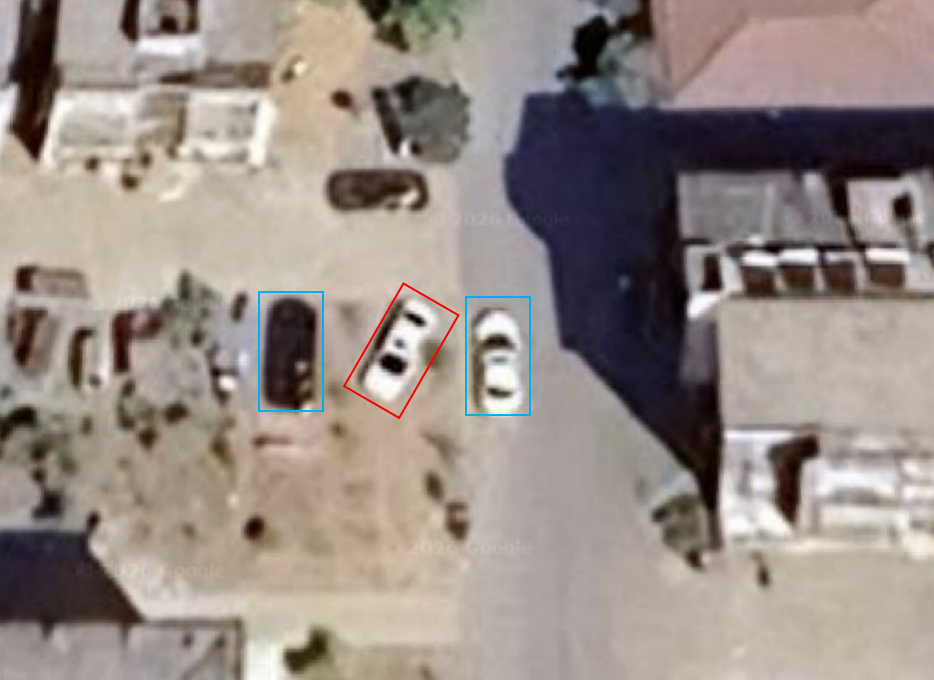
当然如果连停车区间都很难检测,我们可以通过这种相邻车辆的姿态比对来判断当前车身的姿态是否正确,比如以相邻的两辆或者多辆车的姿态为参考来判断当前车的姿态,这就将目标检测拆解为一个原子的几何问题。
所以在模型现实落地的时候,在数据收集以及标注方面都会有大量的工作要做。
闭环式的数据集调整
这个也是最简单也是最直接有效果的方式,比如很多人反馈说他们用了YOLO效果不好或者大模型效果不好。
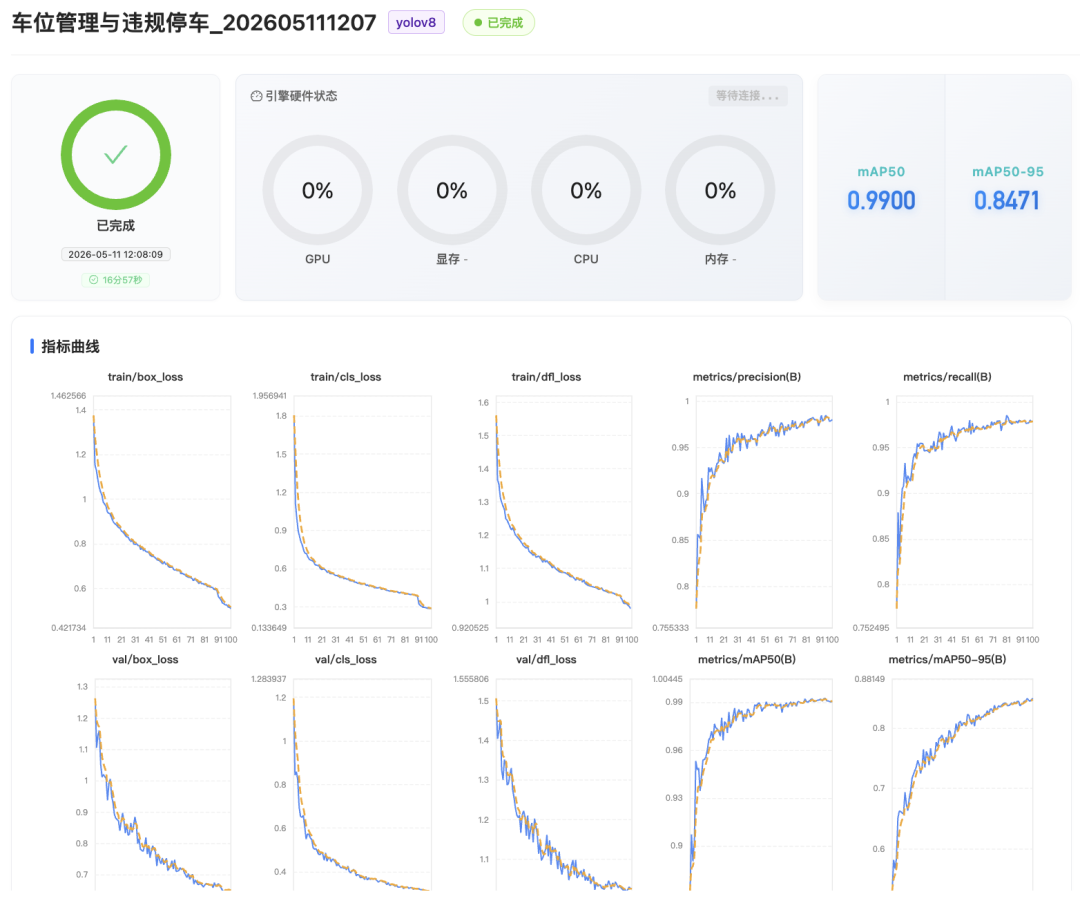
但是这是需要一个拆解开的问题,有时候模型训练是一个踩跷跷板的游戏,比如如何平和精确率(Precision)和召回率(Recall)的平衡。
这就需要我们要结合反馈的效果以及训练时候的指标,来找到一个最佳的平衡点,这个平衡点可能是自己直观感受上的比较好,也可以是一个比较好的F1分数。
但是这些前提条件就是需要我们要不断根据实际检测的坚果来闭环的调整:
「样本训练-模型部署-偏差收集-数据调节」
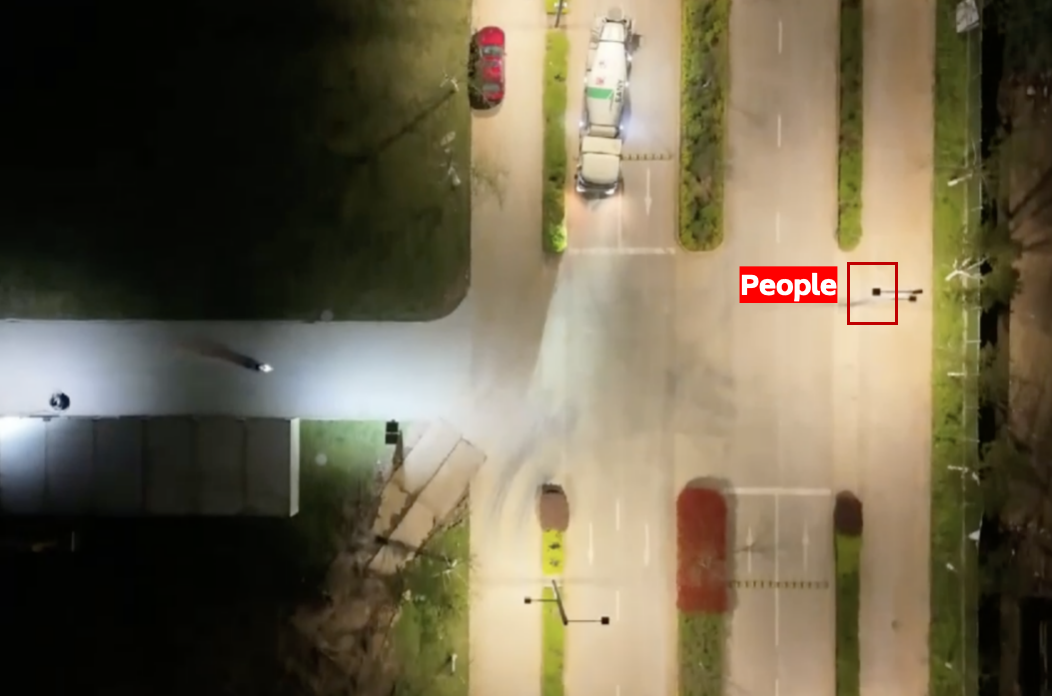
比如下面的场景,由于是俯拍的场景,经常会把路标的路灯或者各种设施识别人「people」,其实有时候就可以将这些错误的检测结果收集起来,然后再进行正确的标注,再回流到样本中进行重新训练,这是一个闭环的过程,通常都会取得很好的效果。
切换推理环境参数
这个其实和第一是呼应的,如果数据集和我们的场景不一致,一方面可以改变我们的数据集适配到场景,另外一方面也可以改变我们的拍摄从而来适配到数据集,比如有时候可能就是简单的更改一下飞行高度、相机焦距以及云台相机的视角,可能就会有比较不错的改善。
大模型小模型混合
当然也不是接了大模型之后就万事大吉了,虽然大模型已经训练了一些「通识」的能力,但是这个通识也是一种「场景偏好」,所以为了让大模型也更好理解你的业务,其实对大模型进行「少样本」进行微调也是必要的,尤其是在样本数量很少的情况下,其实非常建议使用这种「大模型小模型混合」的混合检测。


