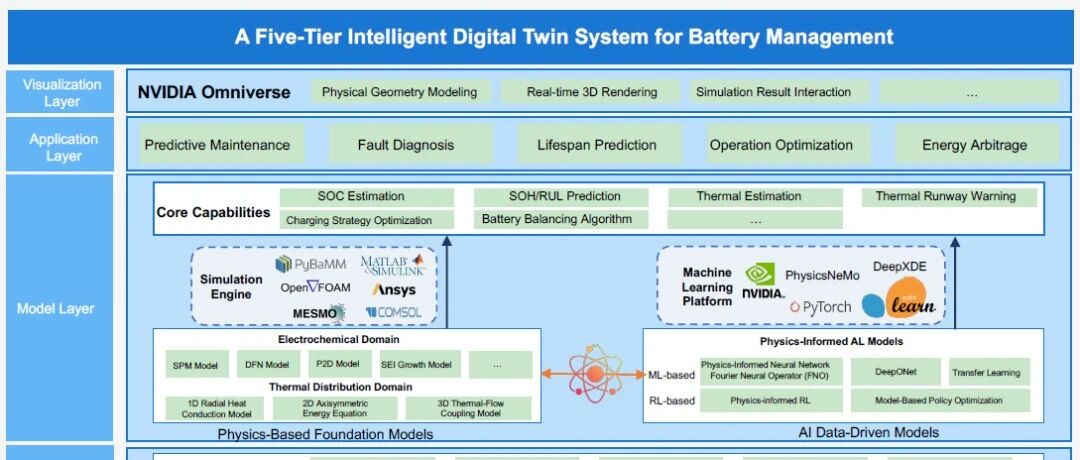
AI+CAE是真有用还是在蹭热点?
最近两年,AI 这个词基本上已经渗透到了所有行业。什么东西都在讲"AI 加",就跟当年讲"互联网+"一样,好像不加就显得落伍了。CAE 仿真圈当然也不例外,各大仿真软件厂商的发布会上,AI 相关功能几乎成了标配卖点。
看到这些消息的时候,很多工程师的第一反应可能跟我差不多:又在蹭热点?
但仔细想想,CAE 引入 AI 这件事,跟很多行业"为了 AI 而 AI"还是有区别的。区别在于:传统 CAE 确实有几个真实存在的、困扰了工程师很多年的效率瓶颈,而 AI 的一些能力,恰好能对准这些瓶颈。
这篇文章想聊的就是这个问题:为什么 CAE 需要 AI?AI 到底能帮仿真解决什么?至于 AI 进入仿真之后会带来哪些新的局限性,那是另一个话题,留给下一篇。
传统 CAE 的核心瓶颈:不是算不出来,是整个流程太慢
说传统 CAE 的痛点,很多人第一反应是"计算慢"。这当然是一个问题——复杂模型的底层本质上是大量偏微分方程的数值求解,算起来确实耗时。但如果只说"计算慢",其实不太准确。
更准确地说,是整个仿真流程都慢。
一个完整的仿真项目,从零开始搭建模型,到模型可以被信任、可以拿来做设计决策,中间要经过很多步骤:几何建模、网格划分、材料参数设定、边界条件定义、求解计算、后处理分析。这些步骤本身就需要时间。但真正让整个周期拉长的,往往不只是这些前处理和计算环节,而是 calibration——也就是模型校准。
所谓 calibration,就是把仿真结果和实验结果放在一起对比,然后不断调整模型中的参数,让仿真尽可能和实验对得上。这个过程听起来简单,做起来却经常把人折腾得够呛。
为什么?因为真正的工程模型里面,需要调整的参数通常非常多。
拿我比较熟悉的电池 P2D(伪二维)模型来说。这个模型里面大概有三十多个参数。其中一部分——大概有二十多个——是可以通过实验测量来确定的,比如电极厚度、颗粒半径、电解液电导率之类的。但是还有六到八个参数,是没办法直接通过实验确定的。
为什么呢?有两个原因。一是有些参数本身就很难在实验中直接测量。二是即使实验测出来了,实验测量的条件和模型里的假设也不一定完全匹配,所以数值不能直接搬进模型里用。
如果只需要调两三个参数,那问题不大,人工试几轮可能就差不多了。但当你需要同时调六到八个参数,而且不是只拟合一条充放电曲线,而是要同时拟合不同倍率(比如 0.5C、1C、2C)下的多条曲线,这个工作量就会急剧膨胀。
一个模型从搭建到校准完成,少则几个星期,动辄几个月,在行业里是很常见的情况。而且这还只是一个设计版本。如果产品要快速迭代——这在现在的研发节奏下几乎是常态——那传统 CAE 的速度就会变成一个很明显的瓶颈。
所以总结一下,传统 CAE 的核心痛点,不是"算不出来",而是:建模慢、调参慢、迭代慢。对于希望靠仿真来加快研发进度的企业来说,这种慢节奏和快速迭代的需求之间,存在比较尖锐的矛盾。
调参困境:专家经验宝贵,很难复 制且未必最优
上面说到 calibration 很耗时间,这里再展开说一个更深层的问题。
传统的模型校准,非常依赖专家经验。一个有经验的仿真工程师,可能根据多年的积累,对某些参数的取值范围有比较好的直觉。他知道哪些参数对结果影响大,哪些可以先固定住,调参的时候该从哪个方向入手。
凭借这种经验,专家确实能把模型调出来——让仿真曲线和实验曲线看起来基本对得上。但这里有一个问题:这个结果不一定是全局最优解,它很可能只是落在了某个局部最优里面。
什么意思呢?在一个六到八维的参数空间里,可能存在多组参数组合,都能让仿真结果看起来和实验比较接近。专家凭经验找到的那一组,很可能只是其中一个还不错的解,但不一定是最好的那一个。
如果真的要在整个参数空间里找到全局最优解,那工作量会非常大——你需要系统性地搜索一个高维空间,这靠人工反复手动调参,既耗时又耗力,说实话不太现实。
而且还有一个隐含的问题:专家经验很难标准化和复 制。一个老工程师花了十年积累出来的调参直觉,很难通过几页文档传递给新人。这意味着一旦关键人员离开,这些经验可能就跟着走了。
这个时候,AI 的价值就体现出来了。
比如可以借助贝叶斯优化这类算法,在更大的参数空间里面更高效地搜索,帮助我们找到更好的参数组合。这不仅可以节省调参时间,也可能提高 calibration 的质量。
当然,这不是说贝叶斯优化就能完全自动化地解决所有调参问题。实际操作中,工程师仍然需要定义参数的合理取值范围、选择合适的目标函数、判断结果是否在物理上说得通。AI 在这里更像是一个高效的搜索助手,而不是一个可以独立决策的替代者。
代理模型:用历史仿真数据换预测速度
除了辅助调参之外,AI 在 CAE 里还有另一个很重要的应用方向——代理模型(surrogate model)。
传统 CAE 每做一次仿真,都要从头求解一遍偏微分方程。模型越复杂、网格越密、耦合的物理场越多,计算时间就越长。在设计优化的场景下,这种"每一轮都从头算"的方式会特别痛苦:你可能需要评估几百甚至上千种设计方案,每个方案都跑一遍高保真仿真,时间成本根本扛不住。
代理模型的思路是:先用一批高保真仿真数据把"输入到输出"的关系学出来,之后对新的输入,直接用学到的模型快速预测,而不需要再去求解复杂方程。
举一个具体的例子。Siemens 在他们的 Simcenter 博客上发过一个案例:用 PhysicsAI 对一个结构碰撞模型做代理建模。他们先跑了 200 组不同碰撞位置的有限元仿真(其中 180 组用于训练,20 组用于测试),然后训练出一个代理模型。结果是:原来每次有限元仿真需要 72 分钟,代理模型的预测时间大约 26 秒,加速了大约 166 倍 [1]。
这个速度差距意味着什么呢?意味着工程师可以从"每天跑几个方案"变成"一个下午扫完几百个方案"。在设计优化里面,这种速度提升会从根本上改变工作方式:你可以更充分地探索设计空间,更系统地做参数敏感性分析,也更容易在早期就筛掉明显不好的方案。
当然,需要说清楚的一点是:代理模型并不是要取代高保真仿真。它更像是一个"快速筛选器"。在概念设计阶段,用代理模型快速缩小搜索范围;筛选出几个有潜力的候选方案之后,再对这些方案跑高保真仿真做精细验证。这种"代理模型粗筛 + 高保真仿真精算"的组合方式,是目前比较务实的用法。
而且从企业的角度来看,代理模型还有一个附带的价值:它能让企业过去积累的大量仿真数据变成可复用的资产。 很多企业跑了几年甚至十几年的仿真,积累了大量数据,但这些数据往往只是以报告或文件的形式存着,很少被系统性地利用。如果能用这些历史数据训练代理模型,那这些"沉睡的数据"就有了新的价值。
AI 不是替代仿真工程师,而是释放工程师
聊到 AI + CAE,很多工程师最关心的问题大概是:AI 会不会替代我?
从目前的情况来看,我的判断是:不会。但它会改变仿真工程师的工作重心。
要理解这一点,可以先把企业里的仿真工作大致分成两类。
第一类是基于成熟模型的日常仿真。 这类工作的模型本身已经比较成熟——方程体系是现成的,建模方法是标准化的,工程师更多是在已有模型的基础上,根据新产品的 spec 或设计方案去改参数、改几何结构,然后运行计算、输出结果、写报告。
这类工作对企业非常重要。很多短周期的项目——比如客户提了一个新的设计需求,需要在一两周内给出仿真评估——靠的就是这种"成熟模型 + 快速执行"的能力。但说实话,这类工作对工程师个人能力的提升不一定很大。它更多是软件操作和流程化执行,做多了确实有些重复和枯燥。
第二类是新模型的开发。 这一类才是仿真里面真正难的部分。
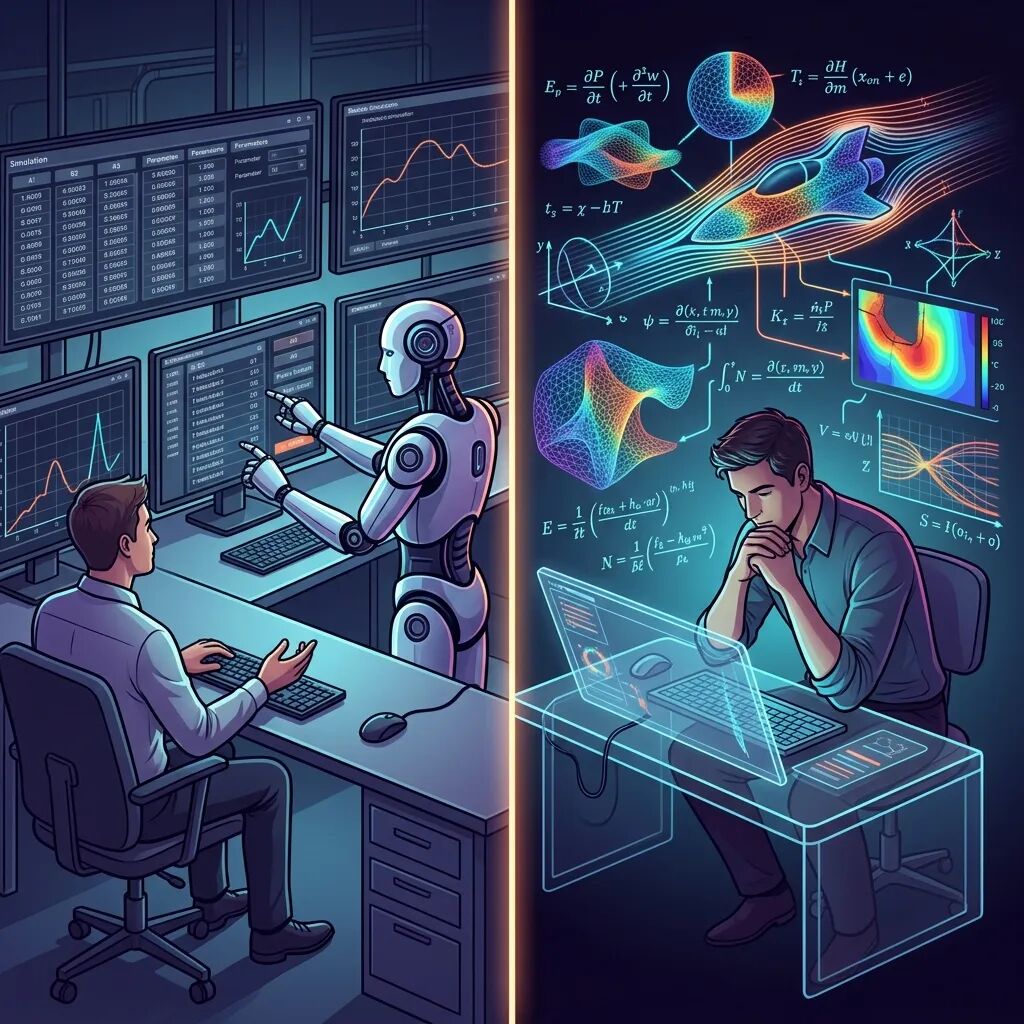
比如电池热失控模型。到目前为止,学术界和工业界其实都还没有一个特别成熟的、被广泛认可的热失控仿真模型。为什么?因为热失控的物理机理本身可能都还没有完全搞清楚——内短路触发之后,究竟是哪些副反应主导了温升?不同材料体系的反应路径有什么区别?这些问题目前还在研究中。
要开发这类模型,首先要求工程师对相关的物理过程非常清楚。然后要根据物理过程选择合适的方程来描述它——用什么样的反应动力学模型?热源项怎么处理?不同物理场之间的耦合关系怎么建?最后到了计算阶段,还要考虑求解器怎么选、时间步长怎么控制、怎么保证模型能稳定收敛。
这些问题,每一个都需要工程师对物理机理、数学建模和数值求解有比较深的理解,而且很多时候没有现成的标准答案,需要自己摸索和判断。这类工作,至少在目前,是很难交给 AI 去完成的。
所以,AI 在 CAE 里的真正角色,不是替代工程师,而是把工程师从第一类工作里解放出来。
让 AI 去处理那些流程化的、重复的日常仿真任务——自动化的参数设定、批量计算、结果提取和初步评估。工程师的时间和精力,则可以更多地投入到第二类高价值工作上:新模型开发、复杂物理机理分析、多物理场耦合、求解稳定性和收敛性问题。
现实中的情况往往是:不是工程师不想做新模型开发,而是根本没有时间。因为企业里面有大量日常仿真任务要完成,很多项目周期很短,需要快速出结果。这些工作虽然不一定能提升工程师本身的技术能力,但它确实是企业日常研发里的现实需求 [2]。
如果 AI 能够分担其中一部分,哪怕只是让这些任务的效率提升 30%-50%,对工程师来说都意味着可以多出时间做更有价值的事情。
写在最后
传统 CAE 的痛点,很多时候不是"算不出来",而是"算得太慢、调参太久、太依赖专家经验,而且专家经验很难标准化复 制"。
AI 引入 CAE 的价值,不是简单地追热点,而是它确实能在几个方面帮上忙:辅助模型校准,在高维参数空间里更高效地搜索;训练代理模型,把反复求解方程变成快速预测;把成熟模型下的重复性工作自动化,让工程师有时间去处理更复杂的问题。
当然,AI 也不是万能的。它进入仿真领域之后,同样会面临自己的局限:对训练数据的依赖、超出训练范围时的外推风险、预测结果的物理一致性问题、以及工程认证场景下能不能被信任等等。
这些问题,下一篇继续聊。
参考资料
[1] Siemens Simcenter Blog, "Star Wars AT-ST Walker: Combining Simulation and AI for Crash Optimization," https://blogs.sw.siemens.com/simcenter/star-wars-atst-walker/
[2] B站视频, "AI 时代技术人如何守住竞争力?AI+仿真企业怎么落地?" , https://www.bilibili.com/video/BV1W3FLzcEAm/?p=2