解决企业AI落地最后一公里问题,用友详解基于“本体”的智能体解决方案
当前企业AI落地面临的挑战
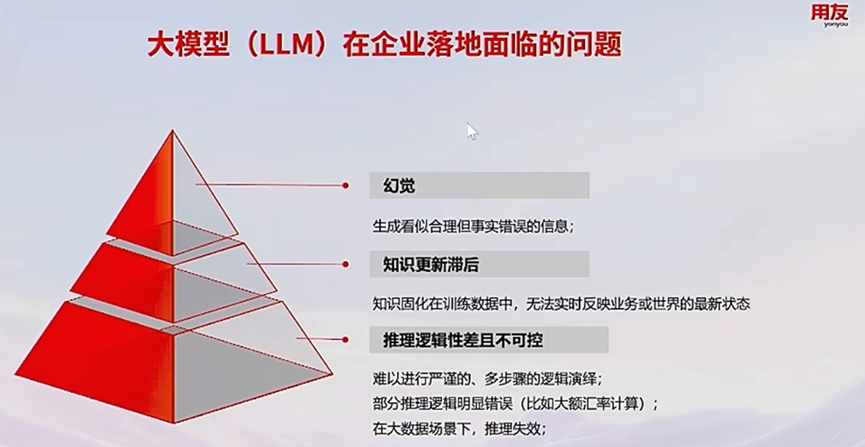
大模型固有的一些技术挑战:幻觉、知识更新停滞、推理能力不足等。例如有些企业需要亿元级金额做汇率的换算,汇率精确到小数点后的八位,绝大多数的大模型进行这个计算都是错误的。又如受限于大模型输入限制,如果Excel在5万行以上,大模型分析Excel就很难实现结合上下文分析,而企业动辄百万行数据。
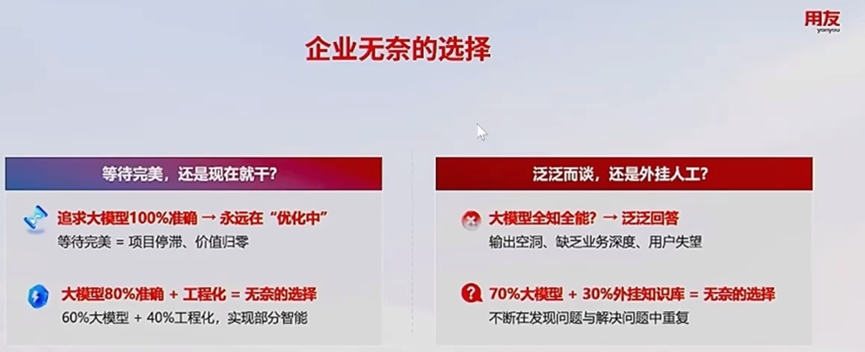
企业通过一些工程化手段落地,但属于无奈的选择。例如大模型本身可能只有80%的准确率,要做到更高的准确率,需要60%靠大模型,还要投入40%的工程化来提升准确率。又如为了让模型回答更具体,需要70%模型知识+30%外挂知识库来实现,但是知识库需要持续发现问题持续迭代。
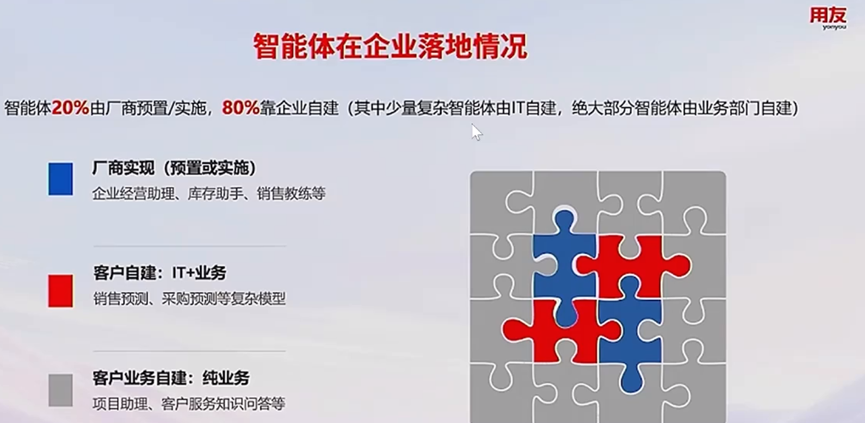
智能体成为当前企业落地大模型的主要路径,企业的智能体中,20%来自厂商通用场景智能体,20%由IT和业务合作建设,60%由业务部门自建。
但是智能体的增多也依然面临很多问题
智能体孤岛:不同智能体数据可能不一致,一旦底层数据结构变动,成百上千的智能体维护工作巨大。
多模态数据融合难:非结构化数据和结构化数据很难统一起来使用
思考能力差:外挂知识库只是靠记忆碎片背答案,并不是真正理解背后业务逻辑,遇到新场景会懵。
不懂业务逻辑:发现应收账款风险之后,应该如何处置,AI无从判断。
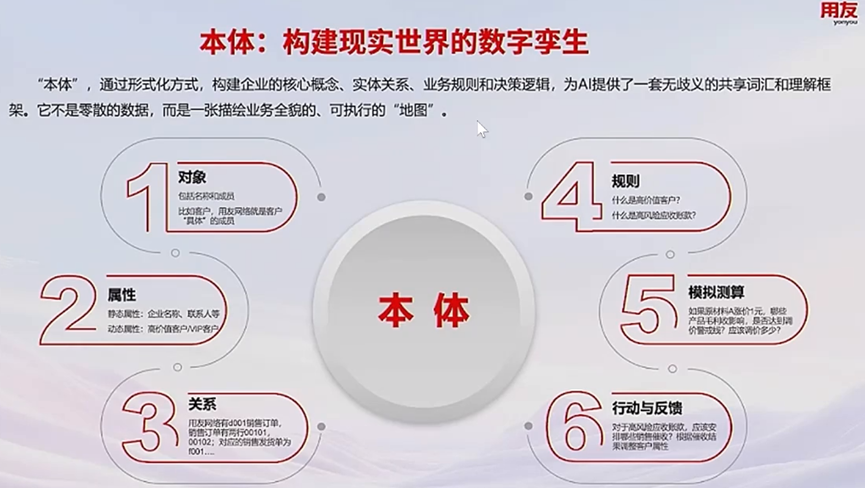
什么是本体,怎么用
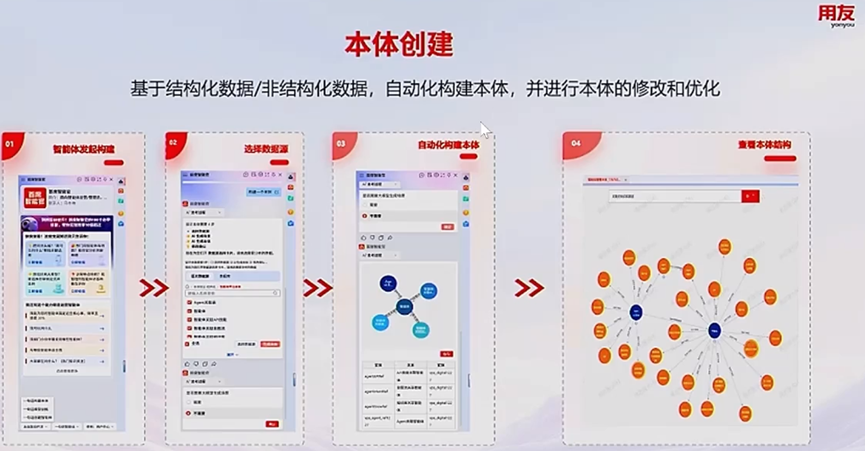
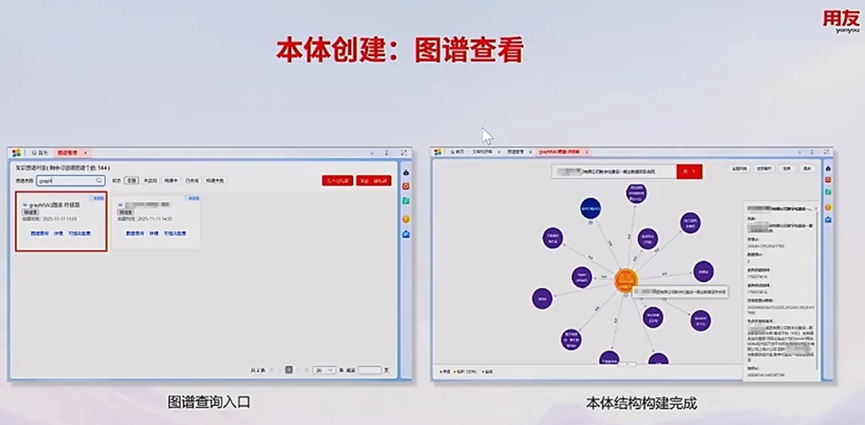
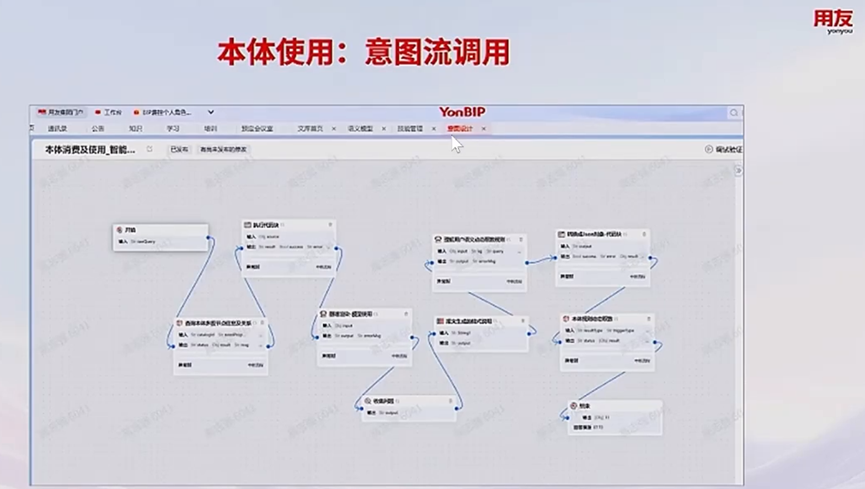
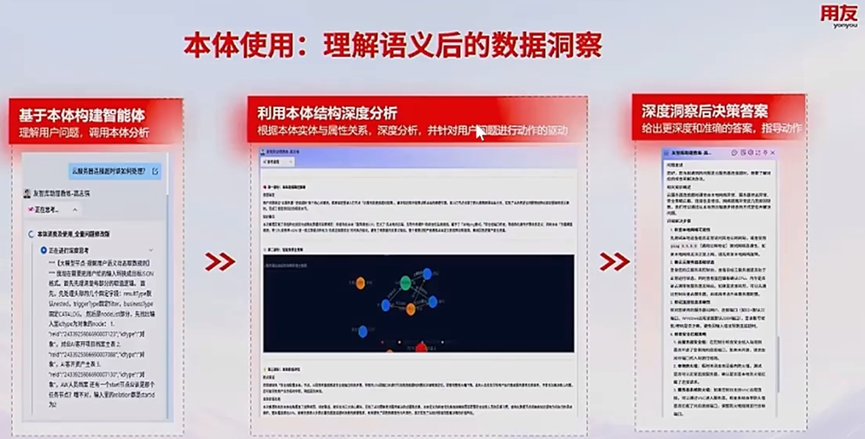
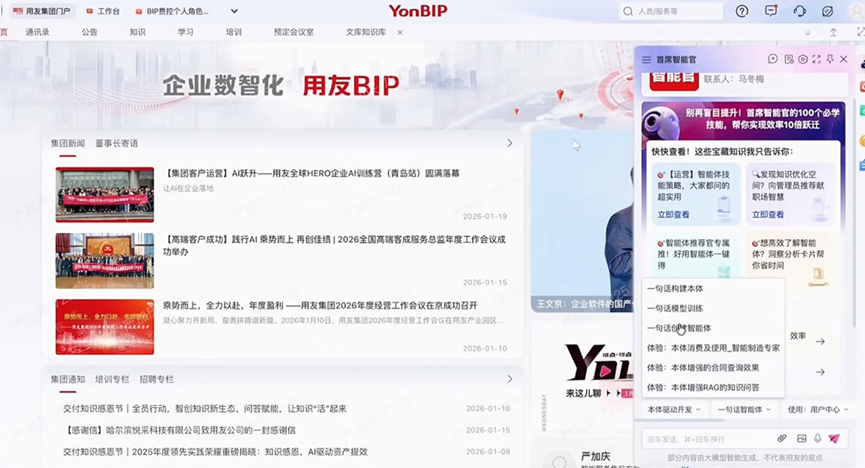
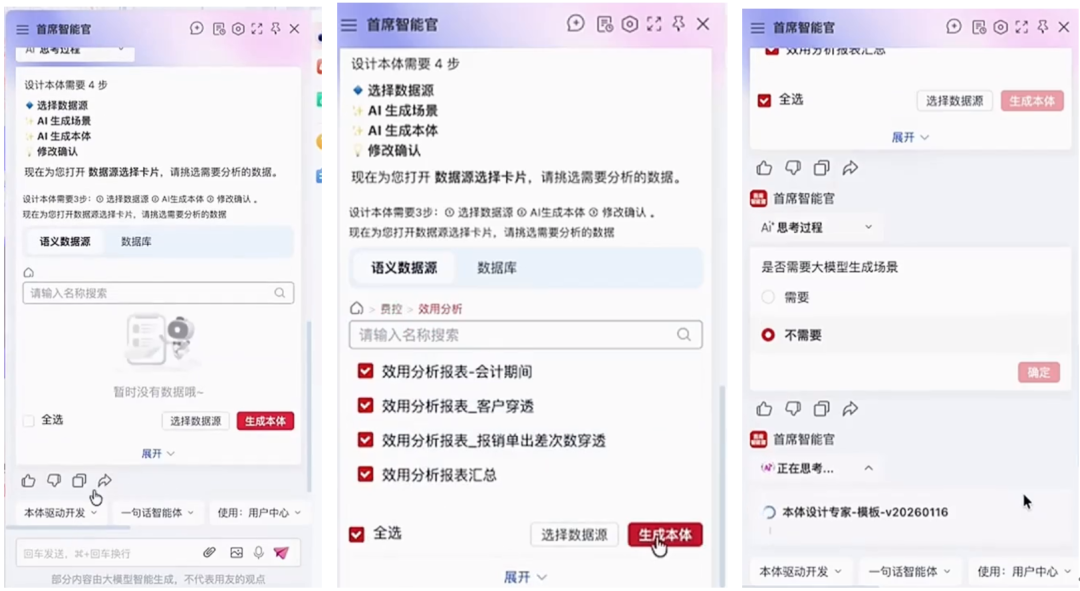
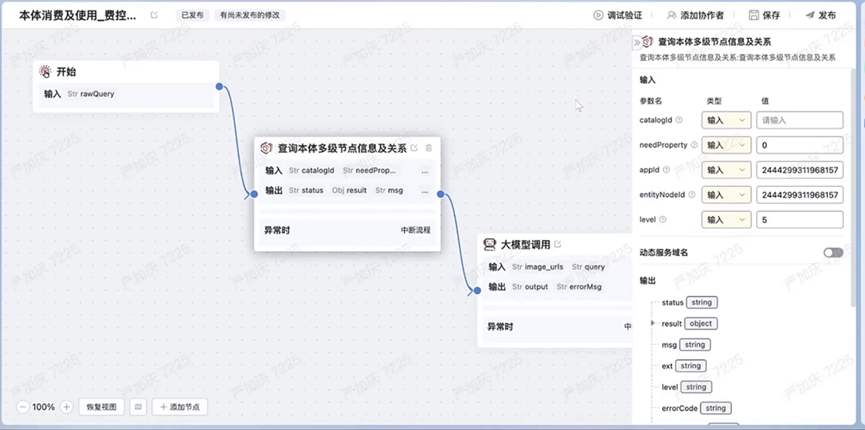
查看创建的本体图谱
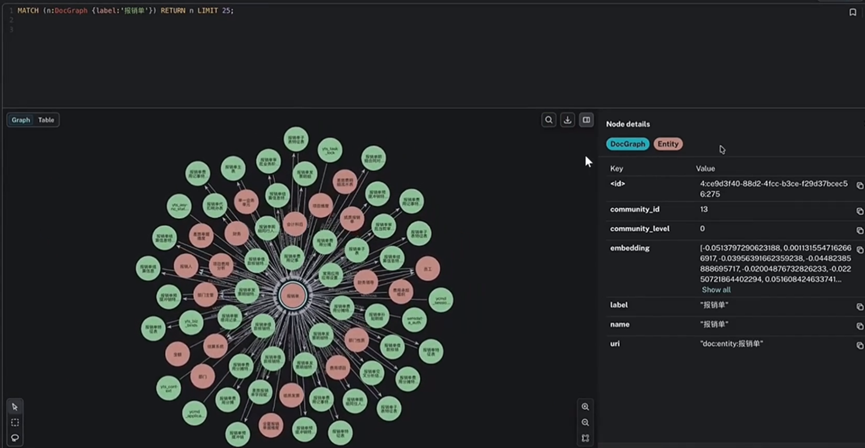
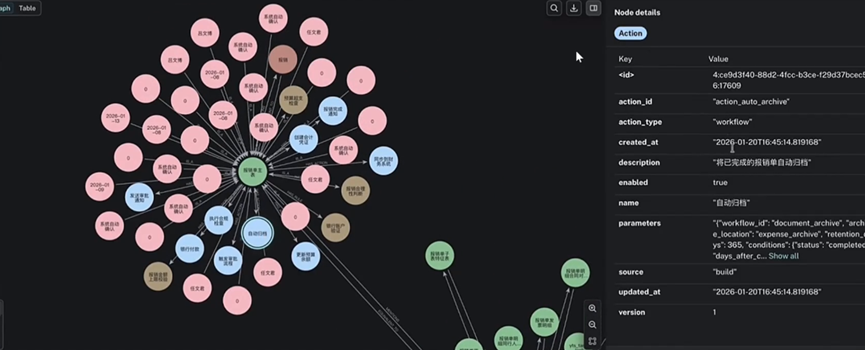
展开其中的报销单,里面包含蓝色是带参数的动作,褐色为规则,粉色是数据实例,表示有一条关联在报销单主表上。
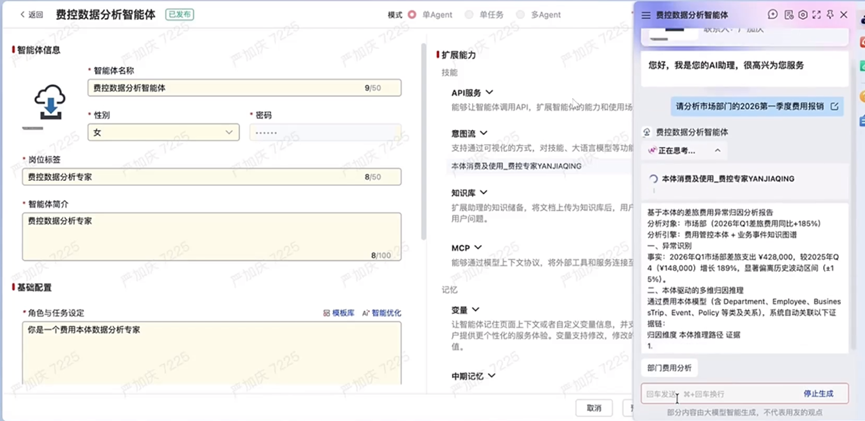
本体智能体的优势
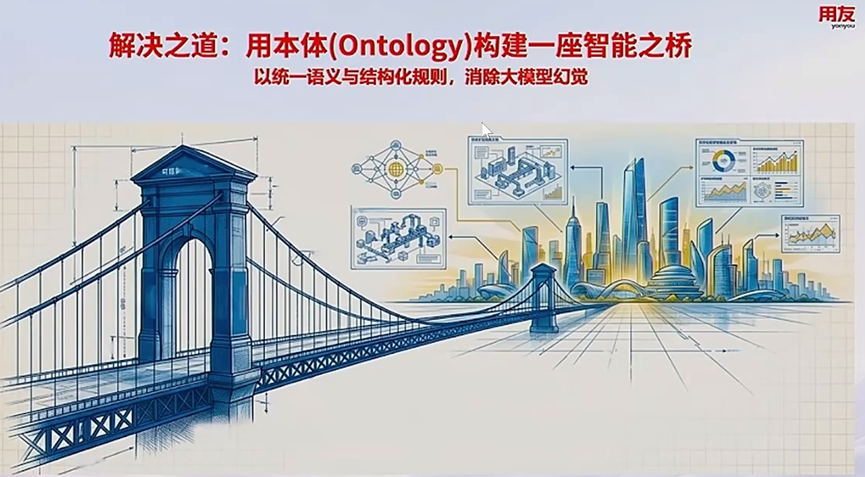
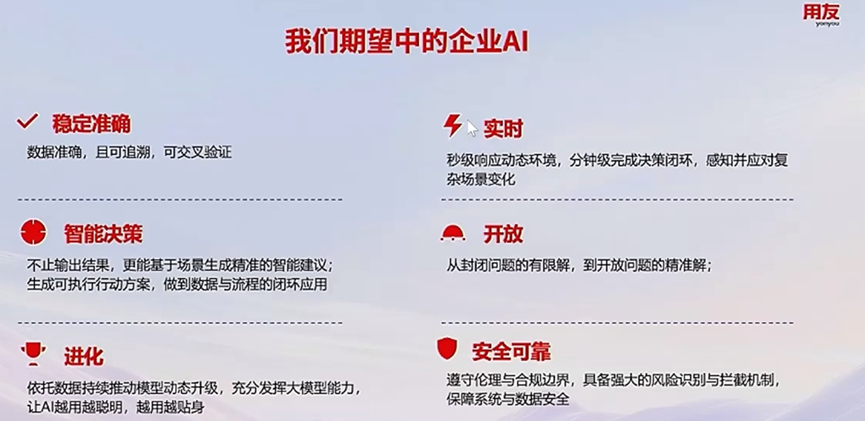
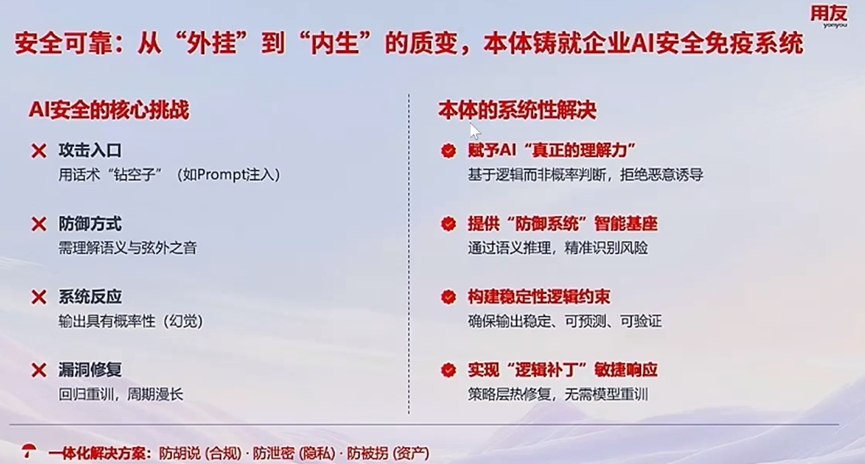
引入本体满足企业AI的6个方面的需求:稳定准确、智能决策、进化、实时、开放、安全可靠
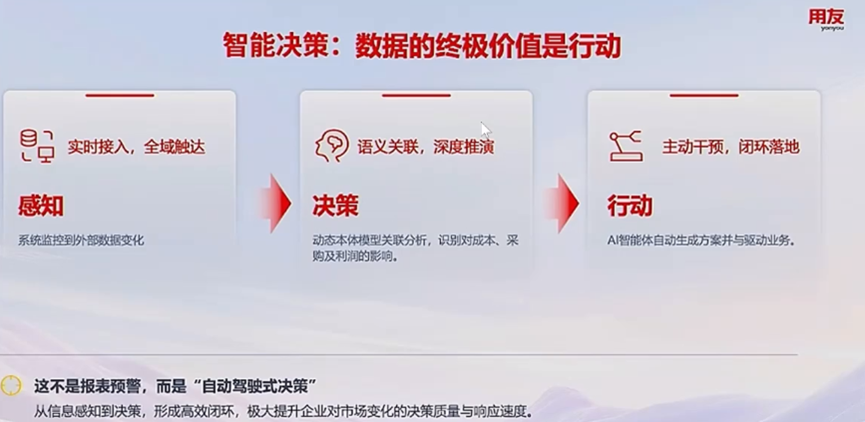
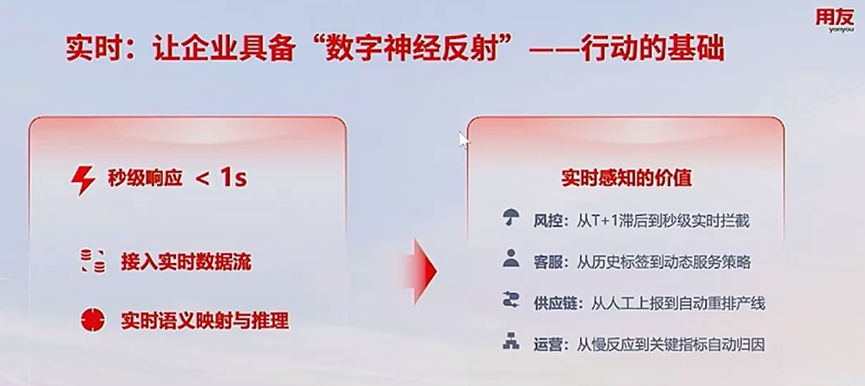
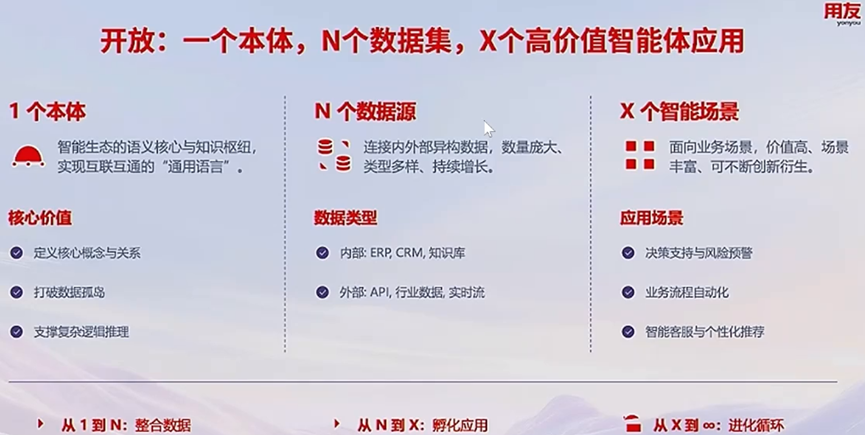
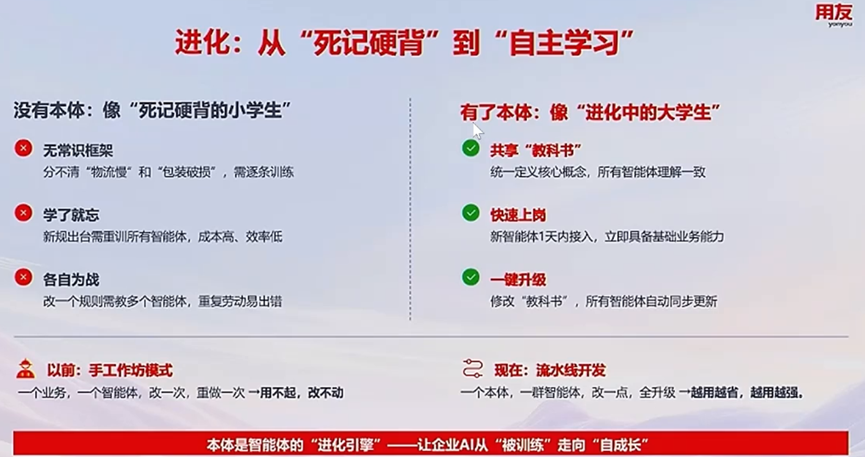
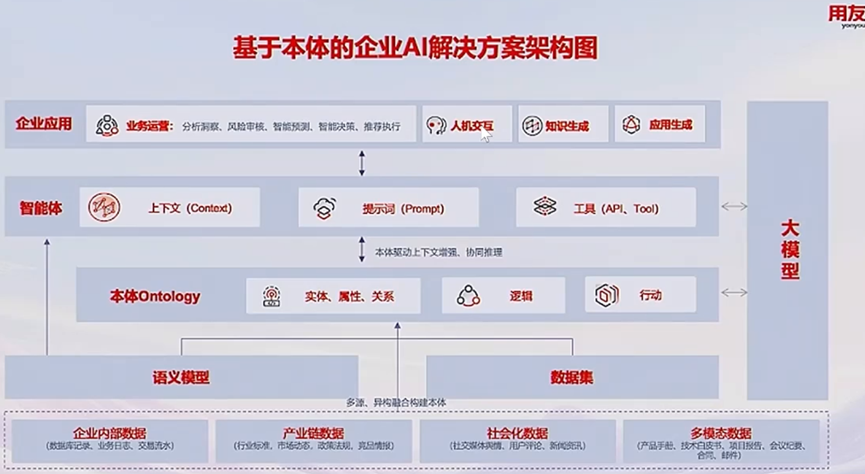
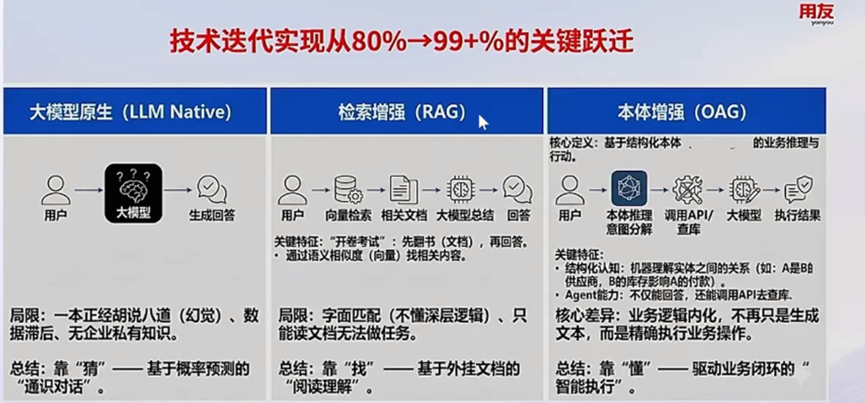
引入本体后,从RAG升级到OAG,智能体能够懂业务操作。
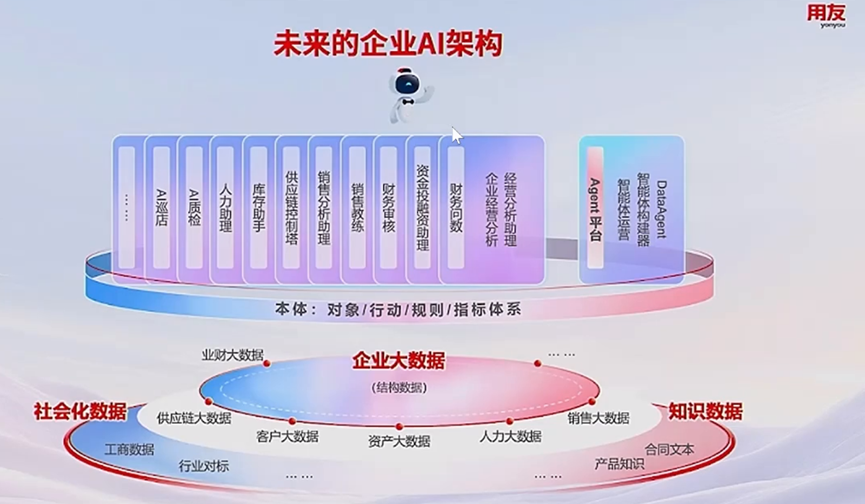
未来企业的AI架构,底层是数据层,中间是本体层,包含数据对象、关系、测算等。上面是智能应用层,含Agent平台和具体的Agent。
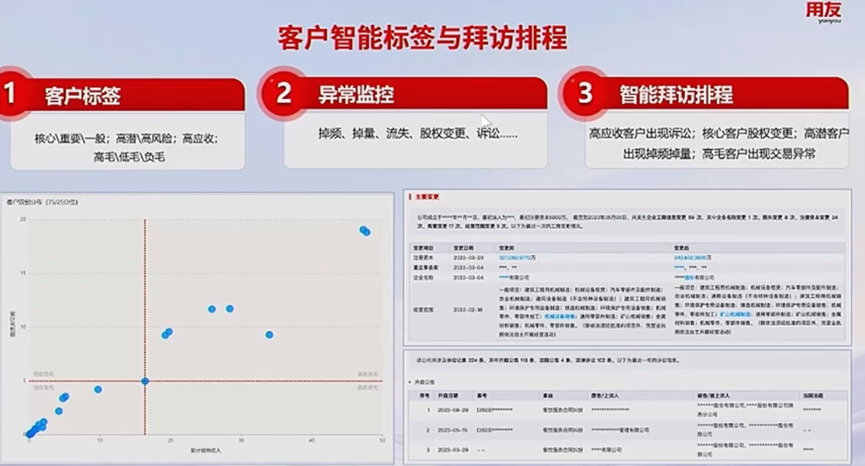
具体场景案例
客户标签管理
用友数据服务里有个客户标签的模型,可以构建不同的客户标签。以往销售做客户拜访的行程安排的时候,只能把这些标签结合起来用,如优先拜访高价值、高应收账款且出现诉讼的客户,这个过程中,结构化数据和非结构化数据是分开使用的。
有了本体后,可以做更精细的控制,比如把优先级分为10级,排程更加的精细。
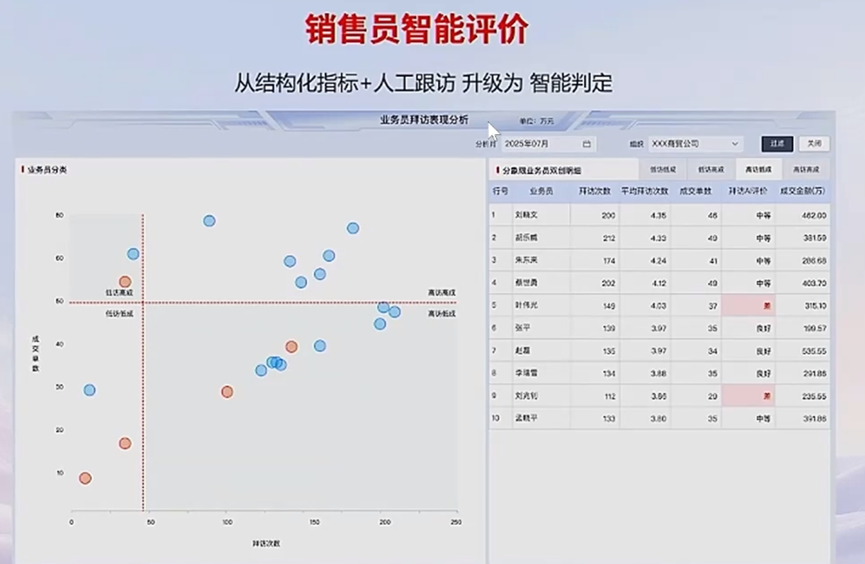
销售员分散在各地,管理者对于销售人员实际去拜访客户的具体情况并不清楚,以往管理销售员业绩的时候,采用拜访客户次数和业绩2个事后指标对销售员进行评价,其中的高访低成(拜访客户多,但是业绩低)销售员很忙但没业绩,以往只能人工跟访去判断这个销售员的能力。
本体智能体应用后,AI可以自动根据销售员写的拜访客户记录进行打分,评价几次拜访客户的记录是否相似,后续拜访是否在之前的基础上有所改善等,从而对业务员的评价更及时、准确和专业。这样可以增加一个维度对销售员做更精细的管理,以后还可以增加更多指标进行划分和管理。
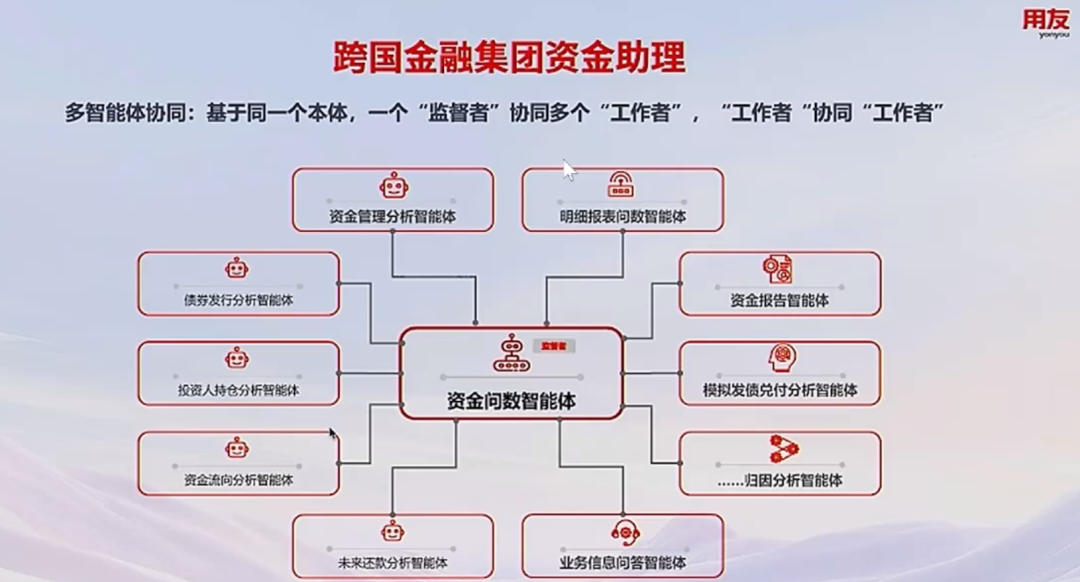
AIE看法
简单的理解,本体就是个加强版的知识图谱,不仅含名词间的关系,还含了动词等。让大模型基于本体进行问答,就是让大模型能够梳理和理解业务概念之间的联系,在理解业务关系的基础上进行回答,比当前的纯RAG更准确。
本体的这一理念,和Graph RAG的理念比较接近,Graph RAG的确是能够提升模型问答效果,但是还面临计算量过高的问题,是比RAG的前进,但似乎仍不是最终答案,仍需要进一步优化。
面对RAG的确定性问题,此前文章也介绍了朗新确定性RAG的一些技术思路:朗新提出提高RAG问答准确率的方案:高可靠智能问答引擎,与Graph RAG、本体多少有些相似,可供参考。
当然,尽管此次的介绍相比之前具体了很多,但还是有很多细节没有介绍的特别具体,估计很多人看完依然还是比较懵逼的。一些问题仍然有必要做进一步的探讨,例如
本体似乎也并没有固化真正存储在业务人员脑子里的经验?
自动创建的本体是否能够保证足够的准确,是否需要实施时的繁重人工检查和调整?
来自不同领域的数据创建的本体们是否能合成企业内的唯一的本体,还是也会形成各个域的很多本体?
本体层与企业之前构建数据中台时创建的数据模型层是什么关系?
此外,25年底以来,Anthropic提出的Skills看起来是个很重要的方向,相比于开发一大堆的Agent,利用Skills固化可重用的业务人员经验可能更有价值,对应的整个企业级Agent体系又将如何构建,都值得进一步探讨。
“本体”还是比较新的事物,有关本体及企业级Agent落地的相关看法,欢迎大家在评论区共同讨论。