
2-65 一个大纯滞后对象,怎样用 25 个模型在线加权改善跟踪效果?
MATLAB 多模型加权自适应内模控制仿真程序
一句话介绍: 这套 MATLAB 程序针对一个带 36 s 纯滞后的一阶过程对象,同时建立 25 个候选子模型及对应控制器,根据各模型与真实对象之间的当前误差和历史误差在线计算权重,再把 25 路控制量加权融合,并与单一固定模型控制器进行同工况对比。
先看它解决什么问题
对于工业过程中的大惯性、大纯滞后对象,一个固定模型往往只能代表某一个工作点。
如果对象的增益、时间常数或者滞后特性与控制器内部模型存在偏差,固定控制器的跟踪过程就容易出现:
响应变慢;超调增大;下降过程产生欠调;模型失配后补偿效果变差。
当前程序采用的思路不是只准备一个模型,而是预先放置 25 个候选模型。
每一个模型都有自己的控制器。程序在每一个采样时刻比较:
真实对象输出和各子模型输出到底差多少?
误差越小,说明这个模型当前越接近被控对象,它对应的控制器就获得更大的参与权重。
完整控制链可以概括为:
参考输入 → 25 个子模型并行预测 → 模型误差计算 → 当前/历史误差评价 → 在线权重 → 25 路控制量加权 → ±2 限幅 → 被控对象
与此同时,程序还建立了一条固定模型控制支路:
同一参考输入 → 单一固定内模 → 固定控制器 → 同一被控对象
最后把两种控制结果放在一起比较。
这里有一个需要先说明的事实:
当前mmimc.m中实际仿真的被控对象本身是固定的一阶纯滞后线性模型,并没有在仿真过程中改变对象参数,也没有加入非线性环节。当前程序的“自适应”主要体现在 25 个模型控制器权重的在线调整。
1. 当前工程实际包含什么?
源码完成了四件主要工作:
建立真实被控对象;建立 25 个子模型及其控制器;
实现多模型在线加权控制;建立固定模型控制器作为对照。
仿真基本设置为:
项目 | 当前值 |
|---|---|
采样周期 ts | 2 s |
仿真步数 M | 4000 |
对应时间范围 | 2~8000 s |
子模型数量 | 25 |
最终控制量限制 | -2~2 |
因此这不是一个依赖外部实验数据的程序,而是一套直接在 MATLAB 内部构造过程模型并完成闭环仿真的控制算法示例。
2. 当前被控对象到底是什么?
源码建立的真实对象为:
Gₚ(s) = 2.5 / (20s + 1) · e⁻³⁶ˢ
它包含三个最关键的动态参数:
参数 | 当前值 | 含义 |
|---|---|---|
过程增益 K | 2.5 | 输入变化最终会被放大多少 |
时间常数 T | 20 s | 一阶过程本身的响应快慢 |
纯滞后 L | 36 s | 控制作用经过多长时间才开始反映到输出 |
其中最值得注意的是:L = 36 s
采样周期为 2 s,因此单纯的过程纯滞后相当于:36 / 2 = 18 个采样周期
再结合离散一阶模型本身的一个采样递推,源码最终使用历史控制量 u_19 计算当前对象输出。
程序中的实际递推形式为:
y(k) = -den(2)·y(k-1) + num(2)·u(k-19)
这也是源码专门保存 u_1 到 u_21 一长串历史控制量的原因。
3. 25 个模型是怎样覆盖不同对象动态的?
程序使用统一形式建立子模型:
Gᵢ(s) = Kᵢ / (Tᵢs + 1) · e⁻ᴸⁱˢ
其中一共设计了 5 组纯滞后:
20 s、24 s、28 s、32 s、36 s
每组又使用 5 组增益和时间常数组合:
(K,T) = (2,15)、(2.5,20)、(3,25)、(3.5,30)、(4,35)
因此最终得到:
5 个延迟工况 × 5 个增益/时间常数组合 = 25 个子模型
具体对应关系如下:
子模型编号 | 纯滞后 L | 组内 K / T |
|---|---|---|
1~5 | 20 s | 2/15、2.5/20、3/25、3.5/30、4/35 |
6~10 | 24 s | 2/15、2.5/20、3/25、3.5/30、4/35 |
11~15 | 28 s | 2/15、2.5/20、3/25、3.5/30、4/35 |
16~20 | 32 s | 2/15、2.5/20、3/25、3.5/30、4/35 |
21~25 | 36 s | 2/15、2.5/20、3/25、3.5/30、4/35 |
这套模型集并不是把 K、T、L 三个参数完全自由组合成一个 125 模型网格,而是:
5 组绑定的 K/T 动态特性,在 5 个不同纯滞后下重复布置。
这里还有一个非常关键的当前程序事实:
第 22 个子模型正好是 K=2.5、T=20 s、L=36 s。
也就是说,它与当前真实被控对象完全一致。
因此本例的模型集不仅“覆盖”真实对象,而且明确包含了真实对象对应的精确模型。
4. 每个子模型为什么还要配一个自己的控制器?
如果只是比较 25 个模型谁更接近对象,还不能完成控制。
程序因此给每一个子模型同步建立一个对应控制器。
对于参数 Kᵢ、Tᵢ,控制器系数直接设置为:
Kpᵢ = 1 / Kᵢ
Kdᵢ = Tᵢ / Kᵢ
控制律在离散域中写成:
uᵢ(k) = Kpᵢ·eᵤ,ᵢ(k) + Kdᵢ·[eᵤ,ᵢ(k) - eᵤ,ᵢ(k-1)] / ts
简单理解:
K 较大时,比例增益相应降低;
T 不同时,动态补偿系数也跟着变化;
25 个模型并不是只负责“识别”,而是各自带着一套与自身参数匹配的控制作用。
五种 K/T 组合对应的控制器参数为:
K / T | Kp | Kd |
|---|---|---|
2 / 15 | 0.5000 | 7.5000 |
2.5 / 20 | 0.4000 | 8.0000 |
3 / 25 | 0.3333 | 8.3333 |
3.5 / 30 | 0.2857 | 8.5714 |
4 / 35 | 0.2500 | 8.7500 |
因此多模型控制真正可以调整的是:
当前更应该相信哪一组模型,以及更应该采用哪一组控制器输出。
5. 程序怎样判断哪个模型更接近真实对象?
每个采样时刻,25 个模型都根据同一实际控制历史计算自己的预测输出 ym(k,i)。
然后程序计算:
eₘ,ᵢ(k) = y(k) - yₘ,ᵢ(k)
也就是:
真实对象输出 − 第 i 个模型输出
如果这个误差比较小,说明该模型当前给出的动态响应与真实对象更加接近。
纯滞后则通过不同历史控制量体现:
20 s 模型使用 u_11;24 s 模型使用 u_13;
28 s 模型使用 u_15;32 s 模型使用 u_17;
36 s 模型使用 u_19。
所以模型集不仅在比较增益和时间常数,也在比较:
哪一种延迟长度更符合当前对象表现。
6. 模型误差为什么还要经过一层处理?
源码建立了两个连续环节:
Fr(s) = 1 / (10s + 1)
Fd(s) = 1 / (10s + 1)
然后使用 c2d 将其离散化。
在当前脚本实际递推中,参考量按下面的形式形成:
r(k) = -den₁(2)·rin(k) + num₁(2)·r(k-1)
每一个模型的误差补偿量为:
eₙ,ᵢ(k) = -den₂(2)·eₘ,ᵢ(k) + num₂(2)·eₙ,ᵢ(k-1)
控制器真正接收到的是:
eᵤ,ᵢ(k) = r(k) - eₙ,ᵢ(k)
所以当前程序不是简单执行:
参考值 − 实际输出 → 控制器
而是把模型输出与真实对象之间的失配也放入控制链:
参考输入 → 参考通道处理 → 减去模型失配补偿 → 子控制器
这正是当前内模控制结构中比较关键的一层。
需要注意的是,源码直接使用离散化所得 num/den 系数按上述递推形式计算,因此如果后续重构程序,不应在没有重新验证的情况下把这一部分直接替换成另一种滤波器调用方式,否则控制行为可能发生变化。
7. 权重为什么不能只看当前这一拍的误差?
如果只根据瞬时误差选模型,某一个采样点上的偶然小误差就可能使权重剧烈跳变。
当前程序因此把:
当前误差 + 最近 4 个历史误差
一起写进模型评价指标。
当 k ≥ 5 时:
Jᵢ(k) = α·eᵢ²(k) + β·[0.4eᵢ²(k-1) + 0.3eᵢ²(k-2) + 0.2eᵢ²(k-3) + 0.1eᵢ²(k-4)]
当前参数为:
α = 0.4、β = 0.2、θ = [0.4, 0.3, 0.2, 0.1]
最近的历史误差权重最大,越早的误差影响越小。
因此 Jᵢ 可以理解成:
这个模型现在错得多不多,以及最近一小段时间里是不是持续错得比较多。
前 4 个采样点还没有完整历史窗口,所以源码使用当前误差单独初始化评价指标。
8. 评价指标怎样真正变成控制器权重?
评价指标得到以后,程序采用非常直接的反比规则:
fᵢ = (1 / Jᵢ) / Σⱼ(1 / Jⱼ)
因此:
Jᵢ 越小;1/Jᵢ 越大;模型 i 获得的权重越大。
而且全部 25 个权重之和为:
Σᵢfᵢ = 1
最终控制量就是:
uᵣ(k) = Σᵢ fᵢ(k)·uᵢ(k)
这不是传统意义上的硬切换:
模型 A 好就完全用 A,模型 B 好就完全丢掉 B。
而是:
所有控制器都可以参与,只是当前更可信的模型拥有更大的控制权。
这也是“多模型加权”与简单模型切换最核心的区别。
源码在 J(i)==0 时将其改成 1e-25,避免出现除零错误。需要注意,这只是对“精确等于 0”的情况做保护,并没有对所有极小正数统一设置下限,因此当模型误差已经接近浮点数精度时,权重可能变得非常尖锐。
用于算法教学和当前仿真没有问题;如果进一步做工程化扩展,权重数值稳定性是值得继续检查的一点。
9. 为什么最终控制量还要限制在 ±2?
25 路控制量加权以后,源码继续执行:
-2 ≤ uᵣ(k) ≤ 2
固定模型控制器也采用相同限制。
这一点很重要,因为控制器中包含误差变化项。当参考值突然变化时,控制量可能瞬间变得很大。
限幅相当于告诉控制器:
无论内部计算结果多大,最终执行量都只能落在 -2 到 2 之间。
虽然当前程序没有进一步模拟阀门开度、电机电流或者执行器功率等真实物理限制,但这个限幅已经让两种控制方案在相同控制能力边界下进行比较。
10. 固定模型控制器用什么作为对照?
为了判断多模型加权到底有没有意义,源码另外设计了一套单一固定模型:
Gf(s) = 2.2 / (24s + 1) · e⁻³⁶ˢ
而真实对象是:
Gₚ(s) = 2.5 / (20s + 1) · e⁻³⁶ˢ
两者纯滞后相同,但:
固定模型增益从真实值 2.5 变成 2.2;
时间常数从真实值 20 s 变成 24 s。
固定控制器参数为:
Kp₁ = 1 / 2.2 ≈ 0.4545
Kd₁ = 24 / 2.2 ≈ 10.9091
于是程序形成一个很清楚的对照:
多模型方案:25 个候选模型在线加权
对比:
固定方案:始终使用一个存在参数失配的模型
两条控制支路最终作用于完全相同的真实对象,并使用相同的参考输入和 ±2 控制限幅,因此对比条件基本一致。
11. 参考输入是怎样变化的?
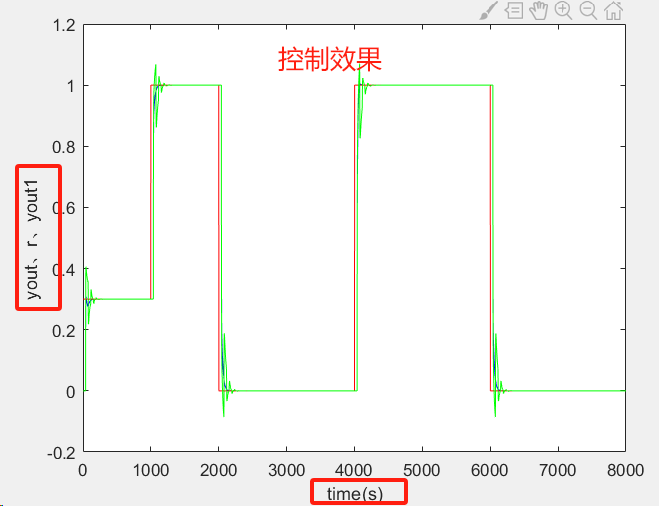
前 499 个采样点,源码设置:rin = 0.3
采样周期为 2 s,所以这一阶段大约持续到:1000 s
随后参考输入变成由 sign(sin(...)) 构造的方波,在:0 和 1之间周期变化。
所以整个仿真实际测试的是:
0.3 稳定给定 → 上升到 1 → 降到 0 → 再升到 1 → 再降到 0
这样既可以观察初始跟踪,也可以观察对象在大纯滞后情况下经历多次设定值改变后的动态表现。
这里尤其要区分:
变化的是参考输入,不是被控对象的 K、T、L 参数。
因此当前源码直接验证的是:
固定过程模型下,多模型加权控制和失配固定模型控制面对变参考输入时的表现差异。
如果要真正验证“对象工况发生变化以后能不能重新分配模型权重”,还需要进一步让真实对象的增益、时间常数或者纯滞后在仿真过程中发生变化。
12. 当前程序的对比结果怎样理解?
源码最终把:
rin:给定输入;yout:多模型加权控制结果;yout1:固定模型控制结果;
放在同一组时间轴上进行对比。
按照当前源码的离散递推关系等价复算,整个 4000 步仿真中,以原始给定 rin 为比较基准,可得到:
指标 | 多模型加权 | 固定模型 |
|---|---|---|
全过程平均绝对跟踪误差 | 约 0.02143 | 约 0.02391 |
全过程均方根误差 | 约 0.13199 | 约 0.13274 |
最大输出 | 约 1.0394 | 约 1.0704 |
最小输出 | 约 0 | 约 -0.0861 |
按平均绝对误差计算,多模型加权方案相对固定模型约降低:10.4%
从动态结果看,差别更明显地体现在超调和下降过程的欠调上:
多模型方案最大输出约为 1.039;
固定模型方案达到约 1.070;
固定模型在下降过程中还会出现约 -0.086 的负向欠调;
多模型输出则基本保持在 0 以上。
全过程 RMSE 的差距没有平均绝对误差那么大,一个重要原因是:
36 s 的真实纯滞后对两种控制方法都是客观存在的,参考值突变后的最初一段时间谁都无法提前让对象输出发生响应。
因此当前结果更适合表述为:
在相同大纯滞后和相同控制限幅条件下,多模型加权方案对固定模型参数失配带来的超调、欠调和平均跟踪误差具有改善作用。
13. 为什么当前这个例子里多模型方法能够发挥作用?
最直接的原因是:
真实对象被模型集覆盖了。
真实对象为:K=2.5,T=20 s,L=36 s
而第 22 个子模型恰好就是:K=2.5,T=20 s,L=36 s
因此理论上,只要评价指标能够正确识别模型匹配程度,接近真实对象的模型就会获得更高参与度。
而固定模型则故意设置成:K=2.2,T=24 s,L=36 s
存在明确参数偏差。
所以这套程序真正展示的不是“25 个模型一定比 1 个模型更好”,而是:
当候选模型集能够覆盖真实对象动态,并且固定模型存在失配时,利用在线模型误差重新分配控制器权重,可以减弱只依赖一个错误模型所带来的控制性能下降。
这也是理解多模型自适应控制时最重要的一点:
模型数量不是目的,模型集是否覆盖可能出现的对象动态才是关键。
14. 它适合用在哪里?
多模型自适应控制教学
程序把:
模型集 → 模型误差 → 性能指标 → 权重 → 控制量融合
完整写在一个 MATLAB 脚本里,非常适合理解多模型加权控制的基本机制。
相比只看理论公式,直接改变某一组模型参数后,可以立即观察权重逻辑和闭环曲线如何变化。
大惯性、大纯滞后过程的算法前期验证
当前对象属于典型的一阶纯滞后过程,可以用来模拟很多过程控制问题的抽象动态,例如:
温度过程;流量或液位慢过程;热工环节;化工过程的一阶近似对象。
但当前程序仍然是一套仿真脚本,更适合控制策略前期验证,不能直接等同于现场实时控制系统。
模型集设计与权重策略实验
可以把当前 25 个模型看成一个基础试验平台,研究:
模型数量改变以后会怎样;
模型覆盖范围过窄会怎样;
权重评价只看当前误差和加入历史误差有什么区别;
不同 α、β、θ 如何影响权重变化;
硬切换与连续加权有什么区别。
变工况控制的进一步扩展示例
当前代码已经具有多模型权重框架。
如果把真实对象进一步改造成:
K、T 或 L 随时间切换
就可以继续研究:
工况变化 → 原模型失配 → 新模型权重上升 → 控制器重新组合
但这一部分属于基于当前程序的扩展方向,并不是现有源码已经实现的功能。
15. 哪些参数最值得修改?
当前脚本里的数值很多,但真正会明显改变控制行为的主要是下面几类。
参数 | 当前值 | 为什么值得改 | 调整后的主要影响 |
|---|---|---|---|
ts | 2 s | 同时影响离散化、延迟采样点和差分项 | 过大会降低时间分辨率,修改后还必须同步检查延迟索引 |
子模型 K/T/L | K=2~4,T=15~35 s,L=20~36 s | 决定模型集能否覆盖真实对象 | 覆盖合理时更容易找到匹配模型,覆盖不足时加权也无法补偿 |
alfa / beta | 0.4 / 0.2 | 决定当前误差与历史误差在评价指标中的作用 | 当前误差占比提高会更敏感,历史作用提高通常会让评价更依赖一段时间表现 |
theta | [0.4,0.3,0.2,0.1] | 决定最近 4 个误差的时间记忆结构 | 改变后会影响模型权重对近期误差变化的响应 |
Fr、Fd 参数 | 1/(10s+1) | 参与参考量和模型失配通道处理 | 会改变进入各控制器的误差信号动态 |
控制限幅 | ±2 | 直接约束最终控制作用 | 收紧会降低控制能力,放宽则可能增加控制峰值和超调风险 |
如果希望把这套程序真正改成“变工况多模型自适应控制”示例,最值得优先修改的不是绘图参数,而是:
真实对象 K/T/L 的时变设置 + 模型集覆盖范围。
16. 怎么运行?
直接运行:mmimc即可完成整个仿真。
运行完成后可以直接观察:
给定输入、多模型加权控制输出、固定模型控制输出
之间的动态跟踪差异。
如果准备修改模型参数,需要特别注意:
纯滞后不仅写在tf(...,'inputdelay',...)中,源码还通过u_11、u_13、u_15、u_17、u_19等历史控制量显式实现不同延迟。
因此修改采样周期或者延迟值时,不能只改 inputdelay 数值,还应同步检查对应的历史输入索引,否则模型声明与实际递推延迟会不一致。
17. 一句话看懂这个项目
这是一个多模型加权自适应内模控制仿真程序:真实对象为 K=2.5、T=20 s、纯滞后36 s的一阶过程,采样周期2 s、仿真4000步;程序围绕5组K/T组合和20~36 s的5种纯滞后建立25个子模型,每个模型配置Kp=1/K、Kd=T/K的对应控制器,再根据真实输出与模型输出之间的当前误差及最近4步历史误差构造性能指标,用1/J归一化得到在线权重,并把25路控制量加权后限制在±2范围内;源码同时使用 K=2.2、T=24 s、L=36 s 的单一失配模型作为对照。当前模型集中的第22个模型与真实对象完全一致,按源码递推关系等价复算,多模型方案全过程平均绝对跟踪误差约0.02143,固定模型约0.02391,同时具有更小的超调和下降欠调,适合用于多模型自适应控制、大纯滞后过程控制以及模型集与权重策略的 MATLAB 教学和前期算法验证。


