首页/文章/ 详情

开源代码论文推荐|多模态特征如何在故障诊断领域有效互补?
1天前浏览1

旋转机械的轴承状态直接关系到设备运行安全与使用寿命。通过加速度传感器、麦克风和电流传感器采集运行信号,可以识别轴承的健康状态与故障类型。实际诊断面临故障标注样本有限、运行负载变化和测量噪声干扰等条件,单一振动信号提供的信息难以持续满足诊断需求。多传感器能够提供互补信息,如何保留不同信号的特征并有效融合,成为本文研究的核心。

研究者提出基于模态交叉注意力的多模态异构特征学习框架(Multimodal Heterogeneous Feature Learning with Modality-Cross-Attention,MHFL-MCA),围绕模态特定编码、双向特征交互和样本级模态重加权开展设计,并在振动—声学、振动—电流两类轴承数据上验证。完整翻译版可点击结尾左下角阅读原文~

论文信息

题目:Multimodal heterogeneous feature learning with modality-cross-attention for robust fault diagnosis of machines under complex conditions

作者:Yuang Zhou、Tianci Zhang、Tongyang Pan、Jingsong Xie、Jinglong Chen

期刊:Advanced Engineering Informatics

原文:https://doi.org/10.1016/j.aei.2026.105277

代码:

https://github.com/yazyeah/MHFL-MCA-Codes-Datasets-and-Results

论文速览

问题:异构信号使用相同编码结构、模态间交互不足和固定融合权重,限制了互补故障信息的利用。

方法:分别提取各模态特征,用双向交叉注意力建立特征之间的关联,再按当前样本计算模态权重,完成融合分类。

目录

  1. 应用场景与研究问题
  2. 方法与主要创新
    2.1 模态特定的异构编码    
    2.2 双向交叉注意力交互    
    2.3 样本级模态重加权    
  3. 实验验证
  4. 适用范围与资源

1 应用场景与研究问题

本文研究同步采集的多模态轴承信号,输入同一时间窗内的两路信号片段,输出预先定义的健康或故障类别。振动、声学与电流信号在统计分布、频谱和噪声特性上存在差异。作者指出,采用同构编码器容易忽略模态特性;将独立提取的特征直接拼接或求和,难以充分建立跨模态依赖;等权融合则无法适应不同样本中各模态信息质量的变化。

传感器组合也受到试验条件约束。渥太华大学数据在轴承驱动端布置加速度传感器,并在轴承附近布置麦克风,同步获取振动与声音。
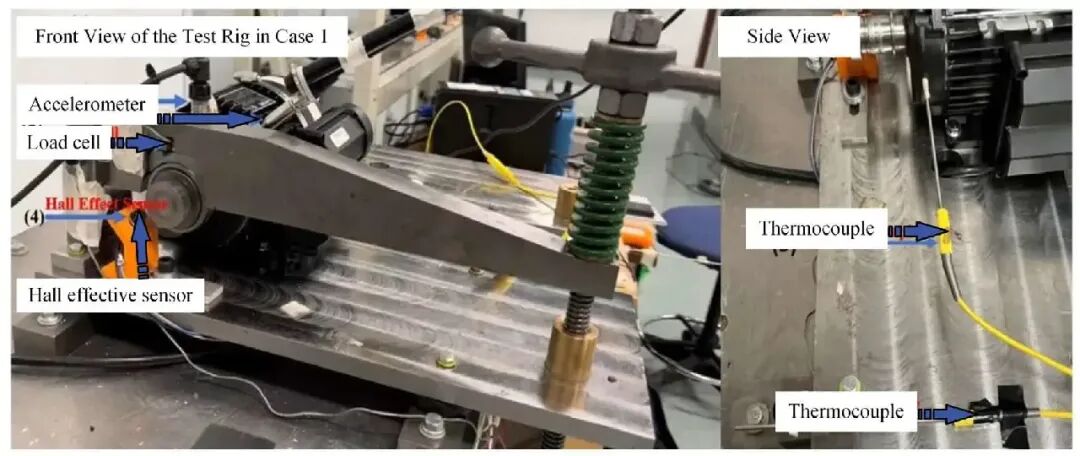
原文图2 渥太华大学轴承试验台,左侧为正视图,右侧为侧视图。  

KAIST 变负载平台使用磁滞制动器施加载荷,制动噪声影响声学采集,因此作者选择各负载下均可获得的振动与电流信号进行跨负载诊断。

2 方法与主要创新

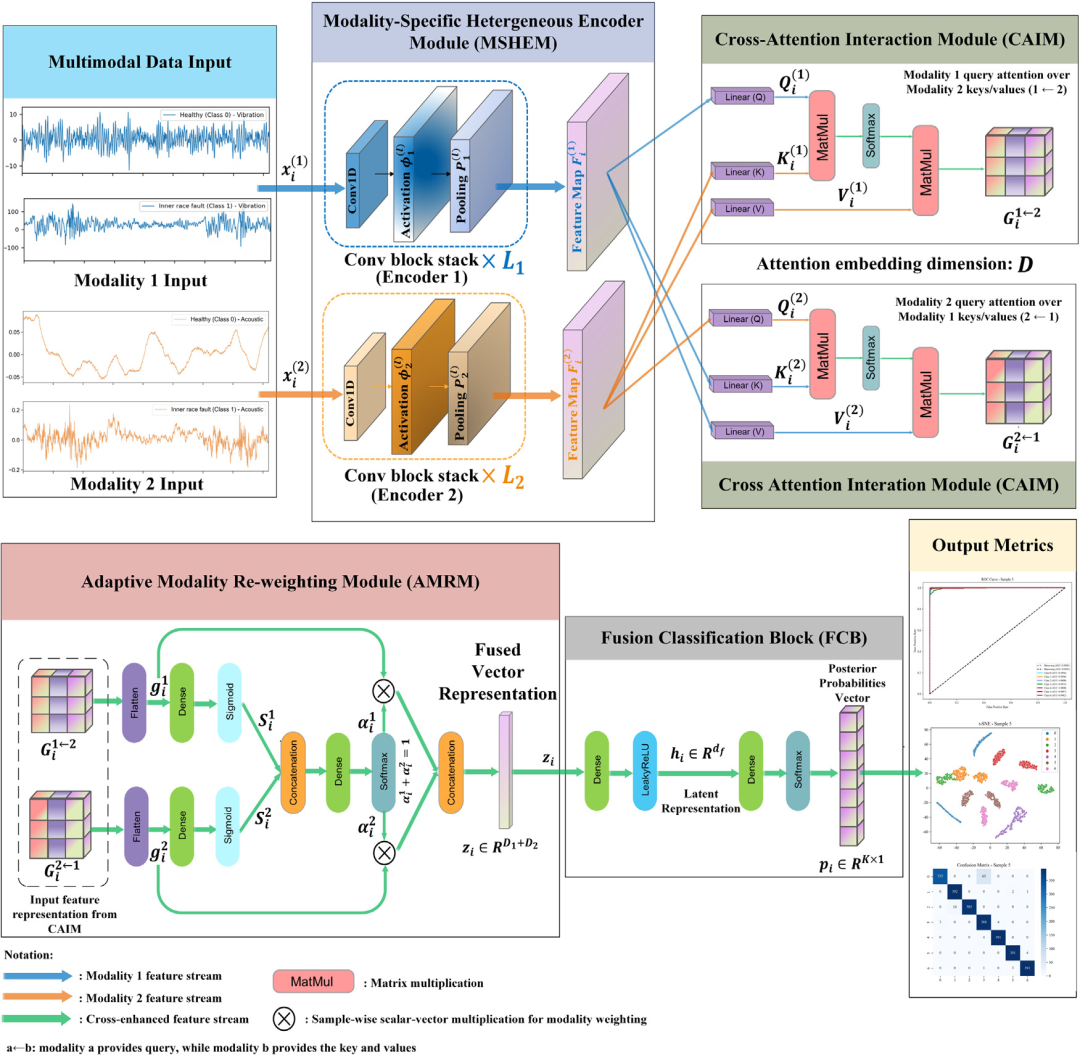
框架在特征提取、跨模态交互和融合三个环节分别进行改进。两路同步信号经过独立编码后形成时序特征,交叉注意力提取另一模态中的关联信息,重加权模块调整两路交互特征的贡献,最终由分类器输出类别概率。


2.1 模态特定的异构编码

模态特定异构编码模块(Modality-specific Heterogeneous Encoder Module,MSHEM)为两路输入分别配置一维卷积网络,独立设置网络深度、卷积核、激活与池化方式,以适应各模态的信号特征。

在振动—声学案例中,振动分支采用 4 个卷积块、长度为 16 的卷积核和平均池化;声学分支采用 5 个卷积块、长度为 8 的卷积核和最大池化。较深的声学分支支持对瞬态与宽带特征进行分层提取。两路网络保留各自的表示方式,输出的时序特征进入交互模块。

这一设计针对同构网络对异构信号适配不足的问题。作者在跨负载案例中将两路分支改为相同结构,检验差异化编码的作用。

2.2 双向交叉注意力交互

交叉注意力交互模块(Cross-attention Interaction Module,CAIM)在两路特征之间建立双向关联。以模态 1 获取模态 2 的信息为例,模态 1 的特征经投影形成查询矩阵     ,模态 2 形成键矩阵      和值矩阵     :


    表示两路特征在时间位置上的关联权重,按行归一化;     是依据该权重聚合模态 2 信息得到的交互特征。交换两路模态的角色,得到反向交互特征。

直接拼接保留的是各分支独立提取的表示,双向交互则使每一路特征都能够利用另一模态中的相关故障信息。注意力作用于编码后的特征序列,输入仍采用同步配对的信号片段。

2.3 样本级模态重加权

自适应模态重加权模块(Adaptive Modality Reweighting Module,AMRM)将两路交互特征分别展平,通过独立的线性映射和 sigmoid 函数计算两个分数,再将分数组合,经线性映射与 softmax 得到和为 1 的模态权重。


其中,     为展平后的交互特征,    、     是随输入样本变化的权重,分号表示拼接,     为融合特征。该模块将固定的模态贡献改为由当前样本决定,使融合过程突出更有诊断价值的模态表示。

融合分类模块(Fusion Classification Block,FCB)通过全连接层和 softmax 输出各健康状态的概率,以最大概率对应的类别作为诊断结果。编码深度与训练超参数通过验证集搜索确定,随后固定。模型采用交叉熵损失和 Adamax 优化器进行端到端训练,各模块参数共同更新。

3 实验验证

3.1 少样本诊断与模块消融

渥太华大学数据包含 7 类轴承状态,转速为 1750 r/min,两路信号采样率均为 42 kHz。每类使用两条同步记录,构建 400 对不重叠片段,每段 2048 点,使用原始幅值。每类选取 5~30 个训练样本,按配对片段划分训练集与留出集,同一留出集用于训练验证及最终评估。两案例主实验均重复 10 次,各指标剔除最高与最低结果后,对余下 8 次统计均值与标准差。

每类 5 个训练样本时,完整模型准确率为 92.79±2.88%,高于振动与声学信号一致特征融合网络(Vibration and Acoustic Signal Consistent Feature Fusion Network,CFFN)的 76.83±5.79%。同一条件下,单独使用振动和声音的准确率分别为 52.40% 和 32.88%,直接拼接为 63.73%,仅加入交叉注意力为 64.73%,仅加入重加权为 68.49%。完整模型的结果体现了跨模态交互与自适应融合联合使用的作用。
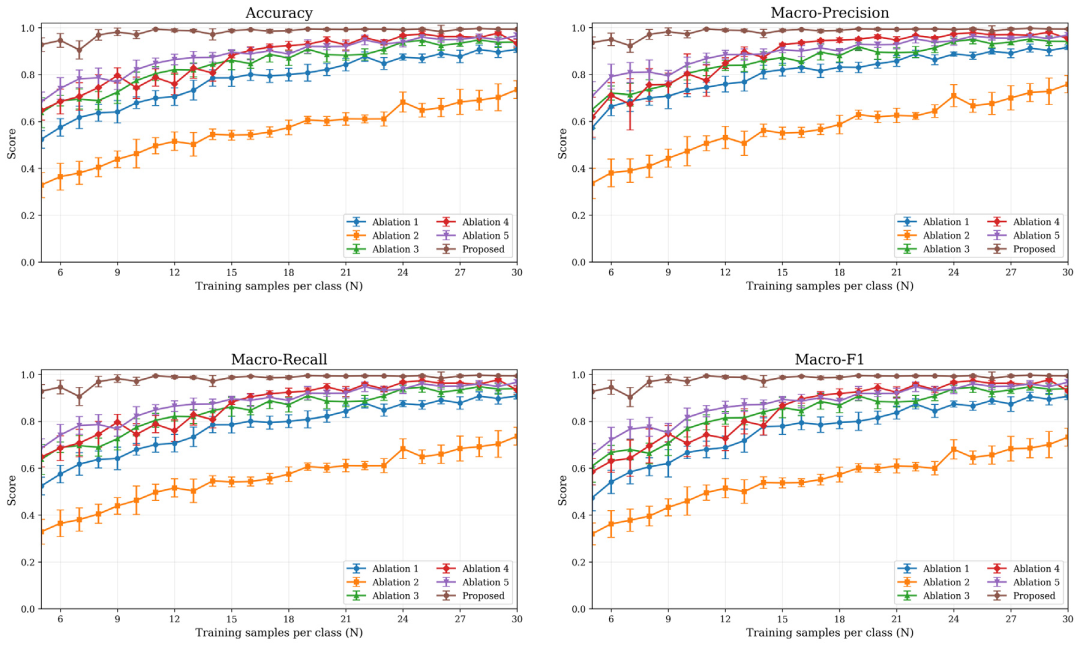


单个模块对各指标的影响存在差异。例如,每类 5 个样本时,仅加入交叉注意力的宏平均 F1 为 58.43%,直接拼接为 60.90%。在较多样本下,传统时频特征支持向量机也取得较高精度,每类 30 个样本时,其早期融合准确率为 99.73%,完整模型为 99.38%。

3.2 跨负载诊断与结构对照

KAIST 数据使用轴承振动与电机 U 相电流,采样率为 25.6 kHz,转速保持 3010 r/min,包含正常状态及 4 类内、外圈故障。每个片段含 2048 点,在加噪前逐段进行 z-score 标准化,加噪后保留设定的信噪比。模型仅在 0 N·m 下训练,在 2 和 4 N·m 下测试。

训练时,两路基准视图均加入 0 dB 噪声,扰动视图的信噪比在 −10~0 dB 间随机取值,少量样本额外施加单模态扰动。训练目标同时约束基准视图的分类误差和两视图预测分布的差异。每类 5 个训练样本时,模型在 2 和 4 N·m 下的准确率分别为 97.39±1.95% 和 91.56±8.32%。

每类 30 个样本、4 N·m 条件下,完整模型为 99.25±0.96%,将两路编码器改为相同结构后为 92.61±4.81%,支持采用模态特定编码。将两阶段权重计算改为直接 softmax 门控后,准确率为 97.52±3.31%,为所提出的重加权方式提供了对照结果。

3.3 强噪声下的诊断性能

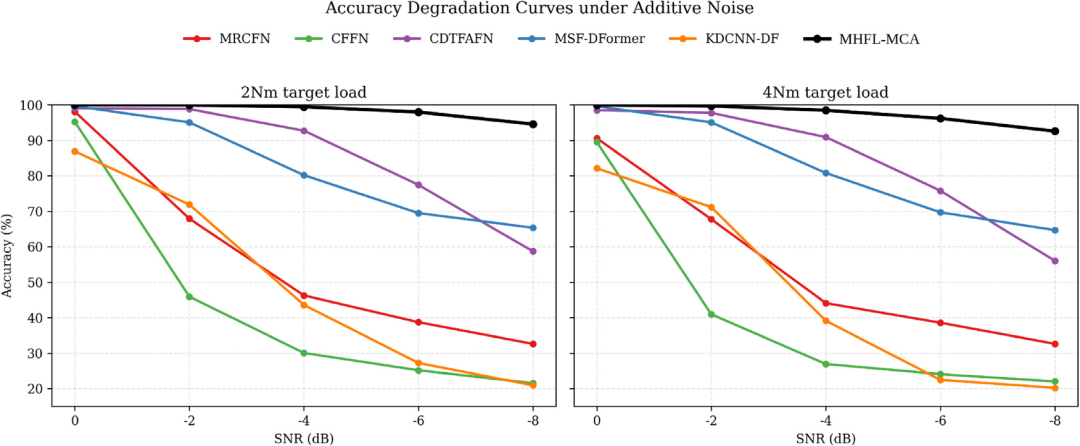
作者以固定随机种子和每类 30 个样本训练一个模型,在目标负载下重复加入独立高斯噪声,并对多次噪声实现进行统计。4 N·m、信噪比 −8 dB 时,准确率为 92.61±0.44%,采用可变形 Transformer 的多传感器多尺度融合网络(Multisensor Multiscale Fusion Network with Deformable Transformer,MSF-DFormer)为 64.72±0.57%。该结果反映了框架结合噪声增强与一致性训练后,在负载变化和强噪声共同作用下的诊断性能。


4 适用范围与资源

研究围绕两个公开轴承数据集的已知健康状态与单一故障分类展开。作者将复合故障、其他机械部件、长期退化以及模态缺失和不同步情形列为后续研究方向。

开源代码至https://github.com/yazyeah/MHFL-MCA-Codes-Datasets-and-Results。
数据节点动态分隔线  

第一作者:周宇昂,中南大学机械设计制造及其自动化2027届毕业生,深圳河套学院2027届直博生,联系邮箱:7803230223@csu.edu.cn

通讯作者:张天赐,工学博士,中南大学机电工程学院讲师,硕士研究生导师。2018年获西安交通大学工学学士学位,2023年获西安交通大学工学博士学位。研究方向为高端机械装备的动力学性能测试及预测性维护技术,主持国家自然科学基金青年基金(C类)、国家重点研发计划子课题等项目7项。连续入选“全球前2%顶尖科学家”榜单,研究成果获陕西高等学校科学技术研究优秀成果一等奖等荣誉,联系邮箱:modaoztc@163.com    


编辑:曹希铭
校核:李正平、陈凯歌、Leo、赵学功、白亮、任超、海洋、陈宇航、Kira、Tina、王金、赵诚、肖鑫鑫、张优
该文资料搜集自网络,仅用作学术分享,不做商业用途,若侵权,后台联系小编进行删除

来源:故障诊断与python学习
ACTDeform振动旋转机械海洋声学电机多尺度试验DAP
著作权归作者所有,欢迎分享,未经许可,不得转载
首次发布时间:2026-11-13
最近编辑:1天前
故障诊断与python学习
硕士 签名征集中
获赞 88粉丝 155文章 348课程 0
点赞
收藏
作者推荐

面向安全关键工程系统的可信智能体 AI 框架:可审计的无故障标签机械故障诊断(下)

接上篇(故障诊断大模型 | 面向安全关键工程系统的可信智能体 AI 框架:可审计的无故障标签机械故障诊断(上)),论文提出了一种由感知、诊断与验证三个智能体协作的可信诊断框架。系统仅利用正常工况数据和轴承几何参数,通过调用物理分析工具,在无需故障类别标签的条件下开展诊断,并记录谐波、频率偏差与边带等关键证据。论文将可审计推理、诊断纠错与组件失效后的规则回退纳入统一流程,为智能体走向可靠的工业应用提供了值得关注的思路。下篇主要介绍实验和讨论,更多实验细节可查看论文附录链接。论文基本信息论文题目:A trustworthy agentic AI framework for auditable label-free machinery fault diagnosis in safety-critical engineering systems论文日期:2026(online)发表期刊:Advanced Engineering Informatics 77 (2027), 105205论文链接:https://doi.org/10.1016/j.aei.2026.105205作者:Yuntong Chen,Binhao Liu,Yingqi Li,Ziang Wang,Liping Ma,Jianyu Liu,Xitian Tian,Lijiang Huang(∗)作者单位:School of Mechanical Engineering, Northwestern Polytechnical University, Xi’an, Shaanxi 710072, China.目录摘要符号与缩略语1 引言2 相关工作2.1 轴承故障诊断的深度学习方法2.2 基于大语言模型的轴承故障诊断2.3 工程信息学中的多智能体大语言模型系统2.4 研究空白总结3 方法3.1 问题定义与框架概述3.1.1 问题定义3.1.2 框架架构3.2 基于自编码器的正常基线学习3.3 感知智能体:大语言模型自适应异常评估3.3.1 动机3.3.2 多指标融合3.3.3 两级决策架构3.4 诊断智能体:基于物理的工具链推理3.4.1 设计理念3.4.2 三层工具架构3.4.3 推理过程3.4.4 跨域泛化3.5 验证智能体:证据一致性与反思纠正3.5.1 动机3.5.2 三步证据一致性协议3.5.3 反思纠正循环3.6 多智能体编排流程3.6.1 流程执行3.6.2 设计属性3.6.3 计算成本3.7 框架的可信性属性4 实验与结果4.1 实验设置4.2 域内评估4.3 消融研究4.4 感知智能体评估4.5 向未见目标数据集的无故障标签迁移4.6 诊断推理分析4.6.1 系统性审计记录评估4.6.2 案例一:标准正确诊断4.6.3 案例二:边带消歧4.6.4 包络谱证据可视化4.6.5 错误分析4.6.6 频率匹配容差分析4.6.7 轴承参数扰动分析4.7 与基于大语言模型的诊断方法比较5 结论4. 实验与结果4.1. 实验设置为评估基于物理的多智能体诊断推理框架,我们在四个滚动轴承数据集上实验:CWRU [22] 为域内评估源域,Paderborn [47]、JNU、MFPT 为跨数据集无故障标签迁移的三个目标域。这些数据集在轴承几何、采集设备、故障生成机理及运行条件上显著不同,为域内准确率与跨域泛化提供严格测试环境。检测率对应可靠性工程中的检测概率(POD)。详细配置见表 2。实验环境:NVIDIA RTX 4090 GPU(24 GB)、AMD Ryzen R7 9800X3D CPU(5.6 GHz)、64 GB 内存。框架采用 PyTorch 2.1 实现。CWRU 数据集来自电机驱动机械系统,使用电火花加工(EDM)在内外圈引入三种尺寸的单点缺陷:0.007、0.014 和 0.021 英寸。使用驱动端加速度计的 12000 Hz 数据,覆盖 0–3 HP 四种电机负载,对应转速 1797、1772、1750、1730 RPM。每个 LLM 的测试量为 7 类 × 4 负载 × 5 个重复片段,共 140 个样本。Paderborn 提供更具挑战的场景,既有 EDM 和钻孔制造的人工缺陷,也有真实运行条件下加速寿命试验形成的故障。信号从 64000 Hz 重采样到 12000 Hz。四个健康轴承 K001–K004 仅用于自编码器训练;测试包含 23 个轴承、五类状态:健康 2 个、人工外圈故障 3 个、真实磨损外圈故障 7 个、人工内圈故障 3 个、真实磨损内圈故障 8 个。关键的是,训练或提示构建都不使用这两个数据集的任何带标签故障数据,自编码器仅学习正常信号。江南大学 JNU 数据集包含 600、800 和 1000 RPM 的变速工况,这是 CWRU 与 Paderborn 不具备的独特挑战。正常、外圈及滚珠故障使用 N205 轴承, ;内圈故障使用 NU205, 。振动采样率 50000 Hz,重采样至 12000 Hz。每种转速取一个正常文件,共三个文件训练自编码器;在正常、内圈、外圈三类的九个文件上测试,每文件三个重复片段,共 27 个样本。MFPT 数据集由机械故障预防技术学会提供,使用以 1500 RPM 运行的 NICE 轴承。正常信号采样率为 97656 Hz,故障信号为 48828 Hz,均重采样到 12000 Hz。三个正常文件用于训练;20 个测试文件包括正常 3 个、内圈 7 个、外圈 10 个,每文件三个重复片段,共 60 个样本。MFPT 在轴承诊断文献中广泛使用,故障类别定义明确。为考察模型通用性,我们评估三个先进 LLM 作为推理骨干:阿里巴巴 Qwen-Plus、OpenAI GPT-4.1 和 Anthropic Claude Sonnet 4.6。监督基线在 CWRU 全部七类故障标签上训练,包括 1D-CNN、ResNet-1D、WDCNN [10](使用宽首层卷积核抑制噪声)、1D-Transformer(patch 嵌入与四层编码器),以及具有梯度反转的域对抗神经网络 DANN [48]。前四个模型使用全部四种负载,按标准监督学习训练 50 个 epoch,采用 Adam,学习率 0.001、权重衰减 、余弦退火调度。DANN 额外接收各目标域无标签振动信号,进行 100 个 epoch 域对抗训练; 按标准公式 调度,域损失权重为 0.5。为减轻不同试验台幅值尺度造成的域偏移,所有五个基线在训练和推理、源域和目标域均统一使用逐样本 z 分数归一化。五个模型在 CWRU 上都达到近乎完美的准确率(至少 99%),然后不重训,直接用于目标域。该设计确保基线失败反映真实域偏移坍缩,而非训练不足。表 2 实验配置 4.2. 域内评估首先使用三个 LLM 在 CWRU 上评估完整系统。各模型处理完全相同的输入,包括自编码器输出、工具实现及提示模板,唯一区别是推理骨干。结果见表 3。三种 LLM 在五次独立运行中的平均总体准确率均超过 92%,表明框架在不同推理骨干间具有良好通用性。Qwen-Plus 最高,为 ;GPT-4.1 为 ;Claude Sonnet 4.6 为 。模型间仅相差 2.7 个百分点,运行间标准差不超过 1.2 个百分点,共同表明性能主要由物理工具链、感知机制和验证协议等架构决定,而非特定 LLM 或随机推理路径。每个值为在相同 140 样本上独立运行五次的均值 ± 标准差,温度为 0。较小的总体标准差(0.6–1.2 个百分点)说明诊断输出稳定。类别方差集中在 OR014,三个 LLM 的标准差均为 3.5 个百分点,与 4.6.5 节 BPFO/BPFI 谐波混叠分析一致:推理路径恰在谐波数相同的边界样本上略有变化。表 3 CWRU 上多 LLM 诊断准确率(%, ) 三模型有一致规律。IR014 和 OR021 达到完全或近乎完全准确,IR014 均为 ,说明中大尺寸故障产生强且无歧义的谱特征,不依赖后端即可可靠识别。OR014 最困难,三者平均准确率分别为 85.0%、75.0%、75.0%,标准差却完全相同(3.5 个百分点),说明困难来自确定性的物理原因,即该故障尺寸下谐波重叠,而非随机 LLM 行为。按第 4.6 节分析,0.014 英寸故障下 BPFO 高阶与 BPFI 低阶谐波重叠,是 CWRU 6205 轴承的基本几何性质,而非框架局限。物理推理的根本优势是特征频率随轴转速线性缩放。我们用四个 CWRU 负载的全部六个两两组合验证(表 4)。对每一对,系统先在第一转速诊断,根据转速比预测特征频移,再验证第二转速包络谱中是否出现预测频率。六对均通过,观测频移比与理论转速比误差不超过 0.3%,确认框架依据物理原理而非模式记忆。跨模型结果也间接支持提示鲁棒性。三个后端的预训练语料、指令遵循及推理策略差异显著,却处理相同提示模板;仅 2.7 个百分点的范围,说明能力主要由结构化物理工具链而非提示措辞细节决定。提示指导工具选择和解释,FFT、包络解调及谐波匹配等数值结果不依赖提示措辞。表 4 跨工况验证(六对) 4.3. 消融研究使用 Qwen-Plus 在 CWRU( )上进行系统消融,沿两个正交方向组织。第一方向比较完整系统与“纯确定性”流程,隔离 LLM 编排的总体贡献。后者采用完全相同的物理工具,但将所有 LLM 决策替换为人工规则:按最大 z 分数选频带,按谐波数最大值分类,并内置 BSF/FTF 审慎规则及规则式边带消歧。第二方向移除各子组件,包括感知智能体、诊断智能体三个子模块及验证智能体两个子模块,定位贡献来源。另设移除全部工具、只保留 LLM 的合理性检查。结果见表 5 和图 4。表 5 消融研究 图 4 CWRU 消融结果(Qwen-Plus, ,一次代表性运行)。(a)各配置总体准确率;(b)七类故障的分类别准确率;(c)相较完整系统的性能下降( )。缩写:TL,全部工具;BA,频带归因;PD,纯确定性;PA,感知智能体;FM,频率匹配;KB,知识库;VA,验证智能体;SD,边带检测。消融揭示三层发现。第一层:LLM 编排比相同工具的规则编排提高 12.2 个百分点。 完整系统 95.0% 减去纯确定性 82.8%,对应表 5 移除 LLM 后的 。纯确定性明显弱于完整系统,但远高于任何无工具配置,确立 LLM 的真实贡献:作为能够选取分析参数、化解歧义的上下文感知编排器,而不是特征提取器。第二层:提升集中在物理歧义样本。 对明显且占主导的故障特征类别(OR007、OR021、IR014),确定性流程已接近完美,达到每类 19–20/20,LLM 仅增加 0–2 个样本;OR014 则由 7/20 恢复到 17/20,提高 50 个百分点,贡献了整体差距的大部分。按 4.6.5 和图 8(c),OR014 恰好存在 BPFO 三倍频与 BPFI 二倍频在 0.7% 内重叠,导致人工最大值规则无法解决的谐波数近似并列。LLM 结合边带、感知频带指导及验证输出改善该类,这正是上下文推理区别于规则逻辑的多证据综合。第三层:各子模块均非冗余。 诊断子模块中频带归因影响最大,移除后下降 17.9 个百分点。没有感知频带指导,诊断智能体只能盲选参数,常选择不理想的包络谱带通范围。内圈类别影响最明显:IR007 为 12/20、IR014 为 15/20、IR021 为 14/20,因为冲击故障特征需要精确选择高频频带才能有效包络解调。验证智能体贡献 10.0 个百分点,其中边带检测单独贡献 7.1 个百分点。OR014 再次受影响最大,无验证时从 17/20 降为 3/20,确认边带消歧是 LLM 编排解决谐波混叠的主要机制。仅 LLM 的合理性检查为 12.9%:通过常识正确识别 18/20 个正常样本,但全部故障类别为 0%,证明仅靠文本描述不能完成振动诊断。此项排除“LLM 仅凭足够先验即可无计算支持分类”的简单假设;决定性消融仍是纯确定性对照,而非此检查。4.4. 感知智能体评估为验证 LLM 自适应异常感知(贡献 C2),在 Paderborn 比较三种感知配置。该跨域挑战要求在一种轴承(SKF 6203,K001–K004)上训练的自编码器 MSE 阈值,泛化到运行特征不同的测试轴承。配置 A:固定 MSE。 当 MSE 比值大于 1.0,即重构误差超过正常基线的 ,触发异常,代表标准自编码器异常检测。配置 B:固定 MSE + 峭度。 在 A 基础上加入规则:MSE 比值大于 1.0,或滤波峭度大于 20,即触发异常。峭度在 2000–10000 Hz 带通滤波信号上计算,以提取冲击故障内容并抑制低频旋转成分。配置 C:LLM 自适应。 完整系统由感知 LLM 综合 MSE 比值、频带 z 分数、峭度、峰值因子及跨域上下文,进行自适应异常评估,即本文方法。总体与分类别结果见表 6。表 6 感知智能体配置比较(Paderborn,23 个轴承)。上表为总体指标,下表为分类别结果;Acc 为分类准确率,Det 为检测率,单位均为 %。 结果呈现感知复杂度提升及其对下游诊断的影响。仅依赖 MSE 的 A 在跨域下严重退化:由于自编码器训练于不同轴承类型,大多数故障轴承的 MSE 比值低于 1.0,通常为 0.4–0.8 倍,使阈值不可靠。如图 5,Paderborn 健康与故障轴承的比值分布大量重叠,大多数故障位于阈值以下,与源域可获得的清晰分离形成对照。因此 A 检测率仅 61.9%,健康准确率为 0%;两健康轴承均误判,其中一个触发 MSE 阈值,而系统缺少推翻误报的上下文推理能力。B 引入反映冲击故障的物理指标峭度,将检测率提高至 95.2%。Paderborn 故障轴承滤波峭度范围为 7.27–301.87,多数超过 20。但激进检测牺牲特异性:B 分类准确率仅 43.5%,因为无法区分故障类型。峭度规则标记异常,却不指导分析频带,诊断智能体因而常把外圈判为内圈,真实磨损外圈准确率仅 14.3%。C 取得最佳总体平衡:分类准确率 63.8%、检测率 90.5%、误报率 33.3%。跨域感知使 LLM 认识 MSE 不可靠,主要依赖峭度与频带 z 分数,将 MSE 作为次要参考。C 可正确识别 66.7% 健康轴承,而 A 为 0%,同时保持高故障检出。B 与 C 检测率相差 4.7 个百分点,反映 C 更保守、更智能的阈值判断:并非高峭度一律报异常,而是综合其他指标评估是否真正意味着故障。 图 5 Paderborn 各轴承类别的自编码器 MSE 比值分布。多数故障轴承比值低于异常阈值(1.0 处虚线),说明固定 MSE 阈值为何在跨域时失效。4.5. 向未见目标数据集的无故障标签迁移最严格评估是跨数据集无故障标签迁移。对 Paderborn、JNU、MFPT 各目标域,自编码器仅用该域正常信号重新训练;物理工具链、提示模板及所有智能体逻辑与 CWRU 完全相同,只更新轴承几何与转速。这一设置没有可直接比较的基线:表 1 的现有 LLM 方法在训练或微调中都需要故障标签,因此不适用。加入在 CWRU 全标签上训练、源域准确率近乎完美的五个监督基线,是为了展示域偏移坍缩的严重性与普遍性。DANN 还额外接收目标域无标签信号进行对抗训练,信息严格多于其他基线。结果见表 7 与图 6。表 7 三个目标域上的跨数据集无故障标签评估 注:全部基线逐样本 z 分数归一化,以减轻幅值尺度域偏移。DANN 额外接收无标签目标域信号,训练 100 个 epoch,余弦学习率调度、权重衰减 、域损失权重 0.5,信息严格多于其他基线。“全部 → X”表示坍缩为单一恒定类别、无判别能力;“部分”表示输出分散但无判别力;× 表示诊断坍缩。Paderborn 的 43.5%–47.8% 恰对应多数类比例(外圈 43.5%、内圈 47.8%),等同于始终预测多数类。JNU 的 25.0% 同样对应正常样本比例;DANN 的 8.3% 低于四个均衡类别的 25% 随机猜测水平,表明负迁移。全部监督模型在 CWRU 七类全标签上训练,测试按文件以 20 片段多数投票评估。 图 6 三个目标数据集 Paderborn、JNU、MFPT 的跨数据集迁移评估。(a)故障检测率;(b)分类准确率。结果有三个发现。第一,无任何故障标注样本,框架在三个域上分别取得 90.5%、96.3%、100.0% 检测率,验证正确指定几何与转速即可迁移诊断能力。第二,五个监督基线,包括获得目标域无标签数据的 DANN,均无法泛化,表现为恒定类别坍缩,或分散但无判别力的输出。Paderborn 的表面准确率恰等于多数类比例,表明域内模式记忆无法跨越设备边界。第三,虽然分类准确率随频谱条件变化,MFPT 为 96.7%,JNU 为 63.0%——其低转速将故障谐波压缩至重叠频段——但检测率始终超过 90%,说明即使下游类型判别受限,多指标感知仍可靠识别异常。比较的公平性需要说明。DANN 用正常及故障混合的无标签目标域信号进行对抗特征对齐,信息严格多于只用正常信号的本文框架。尽管如此,DANN 在三域仍坍缩,准确率为 43.5%、8.3%、25.0%。这说明跨域失败并非目标数据不足,而是诊断知识编码于绑定源域分布的权重所导致的根本局限。本文用运动学方程、谐波匹配等物理公式编码知识,这些规则在设计上不随域偏移变化。结果还揭示超越准确率指标的结构性认识:轴承状态评估本质是具有非对称运行后果的两级决策。第一级故障检测回答“是否需要关注”,与安全直接相关;漏检可能造成非计划停机、连锁损坏或安全事故。第二级分类回答“哪个部件损坏”,用于维护规划;即使分类错误,也会触发检查,在拆解后发现真实状态,带来的是增量成本而非灾难性后果。本文在无故障标签条件下,以 90.5%–100.0% 检测率应对安全关键层级。Paderborn 与 JNU 分类准确率较低,与黑箱错误具有本质差别:每个诊断携带匹配谐波、理论偏差、边带结果等证据链,使工程师可独立评估歧义。分类不确定性由无声失败转化为可审计建议,适于保留人类专业判断的安全关键系统。与监督基线及 LLM 方法比较(4.3、4.7)还产生更广泛的架构启示:监督模型的知识编码于源域权重,分布不成立时知识不可访问;本文将知识编码于运动学方程、包络解调与谐波匹配等物理关系,避免这一问题。与监督 LLM 的参考比较显示,域内准确率与完全监督方法差距在 1.7 个百分点以内,大域差距下跨域检测更稳健。实际部署只需要正常数据、几何与转速,无需故障样本、重训或微调。4.6. 诊断推理分析4.6.1. 系统性审计记录评估为超越个案评估审计记录质量,我们分析全部 140 个 CWRU 测试样本的完整输出日志(Qwen-Plus,一次代表性运行),见表 8。表 8 审计记录完整性统计(CWRU,Qwen-Plus, ) 结果证实,框架在完整测试集系统性生成可审计证据链。边带分析主要在内圈类触发:IR007 为 3/20、IR014 为 8/20、IR021 为 6/20,与内圈缺陷产生轴频幅值调制的机理一致。12 个中置信度诊断对应谐波证据模糊样本,为人工复核提供明确不确定性信号。唯一不完整样本为超时,说明即使失败也可追溯,而非无声发生。为深入展示推理,我们给出两个案例、物理证据包络谱可视化以及系统性错误模式分析。4.6.2. 案例 1:标准正确诊断考察 1797 RPM 的 OR007,即直接明确的外圈故障。感知智能体在 3500–4000 Hz 频带发现极端异常,z 分数大于 160 万,触发诊断。诊断智能体依次计算特征频率:BPFO 107.4 Hz、BPFI 162.2 Hz、轴频 29.95 Hz;对异常高频段计算包络谱;提取 15 个峰;执行确定性匹配。结果无歧义:BPFO 匹配五阶谐波,依次为 107.5、215.5、323.0、430.5、538.0 Hz,平均匹配误差 0.28%,单个误差 0.1%–0.36%,见图 8(a)。BPFI 和 BSF 各仅一阶匹配,FTF 为零。知识库确认至少五阶谐波表示第 3 阶段(进展期)外圈故障。整个诊断仅需六次工具调用,50.6 s 完成。此例体现物理推理范式:LLM 不直接处理原始振动,而是编排由几何频率计算、信号处理到确定性匹配的工具链,综合输出为连贯诊断。平均 0.28% 误差体现以计算工具而非模式识别支撑推理时的高精度。4.6.3. 案例 2:边带消歧考察 1797 RPM 的 IR007(图 7 右),存在谐波歧义。包络谱和匹配后,BPFI、BPFO、BSF 各有两阶谐波,单纯计数无法打破三方并列。LLM 没有默认选最常见故障,而是主动调用边带检测,识别 132.0 Hz(BPFI 减轴频)和 191.5 Hz(BPFI 加轴频)两处清晰边带,间隔恰与 对应。物理依据是内圈缺陷随轴旋转,每转一周通过承载区一次,使 BPFI 信号以轴频幅值调制,在 产生边带。原文将其描述为内圈故障特有、外圈及滚动体缺陷不具备的特征。框架识别并应用该原理,将模糊诊断提升为高置信内圈故障,展示超越简单频率匹配的推理。该案例直接对应表 5 移除边带检测下降 7.1 个百分点:若无此机制,涉及谐波歧义的 7.1% 样本将依赖默认启发式或随机机会,而非物理推理。 图 7 1797 RPM 下两个代表性样本的诊断推理链:标准外圈故障 OR007(左);需边带消歧的模糊内圈故障 IR007(右)4.6.4. 包络谱证据可视化图 8 展示四个代表案例的包络谱。(a)(b)对应上述案例:OR007 有五阶 BPFO 谐波,匹配误差小于 0.4%,是明确外圈特征;IR007 有三阶 BPFI 谐波,并伴随 BPFI ± 轴频边带,确认旋转内圈缺陷的幅值调制。(c)揭示主要错误来源:OR014 的 BPFO 三倍频 322.1 Hz 与 BPFI 二倍频 324.4 Hz 仅相差 0.7%,引发 4.6.5 节的系统性误分类。(d)健康轴承没有占主导的故障谐波,作为基线参考。 图 8 1797 RPM 下四个代表样本的包络谱。(a)OR007:清晰识别五阶 BPFO 谐波,误差小于 0.4%;(b)IR007:三阶 BPFI 谐波及轴频边带(BPFI ± ),确认幅值调制;(c)OR014:BPFO 三倍频(322.1 Hz)与 BPFI 二倍频(324.4 Hz)相差 0.7% 的混叠区域,是内外圈误分类根因;(d)正常:噪声底之上无占主导的故障谐波。4.6.5. 错误分析CWRU 实验的七个误分类样本(错误率 5.0%)揭示两种失效模式,见表 9。表 9 错误分类(Qwen-Plus,CWRU,140 样本中 7 个误分类) 主要类型为 BPFO/BPFI 谐波混淆,占七个错误中的五个,且全部影响 OR014。0.014 英寸故障下,BPFO 三阶约 ,与 BPFI 二阶约 相差 0.7%。采用 2% 容差的匹配工具,会合理地将约 322–323 Hz 的观测峰同时匹配至 BPFO 三阶和 BPFI 二阶,产生额外 BPFI 计数,偏向内圈诊断。这是 CWRU 6205 几何频率比引起的基本物理限制,而非框架缺陷。可行缓解包括收紧容差(代价是漏掉真实匹配),或按幅值加权谐波评分,留待未来研究。单个误报案例说明统计上的不可避免性:每个样本提取 15 个峰,对四类故障频率、各五阶谐波应用 2% 窗口,噪声峰偶然对齐模板的概率不可忽略。正常类误报率为 ,与此参数空间预期偶然匹配率一致,说明增加幅值阈值或峰显著性等判别特征可能进一步降低误报。4.6.6. 频率匹配容差分析第 3.4.2 节的 容差反映三种实际因素。第一,不同负载下转速波动;CWRU 四工况为 1730–1797 RPM,范围 3.7%,实际特征频率即使在同一数据集中也随转速变化。第二,轴承几何公差与内部游隙变化,使名义参数理论频率偏离实测谱频率。第三,有限 FFT 分辨率产生离散化下限:12 kHz、16384 点时, 约为 BPFO 107.4 Hz 的 0.7%。因此 是在容纳综合不确定性与限制偶然匹配间的工程折中。从 4.6.5 错误分析可评估其敏感性。收紧至 会减少偶然落入窗口的噪声峰,可能降低正常类误报;但不能消除主要 OR014 错误,因为两组谐波仅相差 0.7%,仍落在两侧 窗口内。放宽至 会增加各类噪声偶然匹配,抬高误报及类间混淆。当前 取得 95.1% 总体准确率,主要错误来自 CWRU 6205 特定几何巧合,而非系统性框架限制。第 4.6.7 节参数扰动提供进一步定量证据:几何参数扰动 至 时,理论频率变化相当于在真实参数不确定性下测试容差窗口。表 10 确认,在符合工业参数精度的扰动下保持鲁棒。针对不同轴承几何细致优化容差,是未来部署定制方向。4.6.7. 轴承参数扰动分析物理推理依赖几何参数和转速计算理论频率。实际中,制造公差、长期磨损或文档不完整会使名义值偏离真实值。为评估鲁棒性,我们在 CWRU 上系统扰动。每个扰动幅度为 1%、3%、5%,对滚珠直径 、节圆直径 、滚动体数 (四舍五入至最近整数)以及转速 独立施加随机乘性扰动: 各幅度使用五个独立随机种子重复测试,每次用 Qwen-Plus 诊断全部 140 个样本。结果见表 10。表 10 参数扰动分析(CWRU,Qwen-Plus,每次 ,每级五次) 第一,分类准确率随扰动平稳下降: 仅下降 4.1 个百分点, 下降 7.8 个百分点,没有突发坍缩。 代表厂家数据表精度,此时与名义基线在统计上无法区分(均 95.1%),确认 匹配容差充分吸收小不确定性。较大扰动下主要是转速影响,因它成比例平移所有特征频率;转速偏差超过匹配容差时,高阶谐波落出窗口,匹配计数减少、分类歧义增加。第二,更重要的是,即使 ,检测率仍超过 97%。这来自感知—诊断分离:感知依赖直接由信号计算的 MSE 比值、频带 z 分数与峭度,完全独立于几何参数。扰动只影响诊断频率匹配,削弱分类但不削弱上游检测。结果验证两级设计:即便参数不确定性远超典型工业条件,框架仍可靠识别故障存在,并保持合理分类准确率。4.7. 与基于 LLM 的诊断方法比较为将本文置于新兴 LLM 轴承诊断研究中,我们与 Tao 等 [16]、BearLLM [18]、DiagLLM [17] 作参考比较。由于这些方法需故障标签训练/微调、无法直接用于无标签条件,因此采用原论文报告结果,而非受控复现。表 11 从三个维度汇总比较。表 11 与基于 LLM 的轴承故障诊断方法的参考比较 标签效率。 本文在 CWRU 无故障标签达到 95.1%,仅比 Tao 等使用全标签和 LoRA 的 96.85% 低 1.7 个百分点,且是更难的七类而非四类设置。BearLLM 达 100%,但需九个数据集故障标签;其 CWRU 留一跨数据集准确率为 90.3%,即使使用其他八个有标签数据集仍比本文低 4.8 个百分点。这种较小准确率差距对应部署需求的质变:设备投用后即可部署,不必等待故障数据。跨域鲁棒性。 在最接近工业部署的有限数据情形,Tao 等即使有三个源域完整标签和 10% 目标域故障数据,准确率仍降至 64.6%–86.9%。本文监督更少,在相同目标域故障检测率达到 90.5%–100%,说明物理推理在大域差距下比学习模式表示更平稳地退化。需要指出,本比较来自不同论文,数据划分、类别定义和评估协议不同,应视为展示标签效率与诊断能力的范式级权衡,而非受控的一对一比较。在相同实验条件下复现,仍是未来基准研究的重要方向。5. 结论本文提出可信多智能体 LLM 框架,应对安全关键机械状态监测部署智能体 AI 的保障要求。通过将 LLM 从模式分类器重新定位为确定性物理工具链的推理编排器,实现完全无故障标签诊断,并把四种可信属性直接落实于架构:LLM 推理—信号计算分离、可审计推理溯源、安全单调反思纠正及组件失效平稳降级。主要结论如下。无故障标签的物理推理在 CWRU 取得 准确率。其中确定性工具链贡献 82.8%,LLM 编排额外贡献 12.2 个百分点,这是 4.3 节单次运行消融结果。在三个未见目标域的无标签迁移中,平均故障检测率 95.6%;五个监督基线均未能泛化,输出退化为恒定类别或多数类先验。带 LLM 自适应感知的三智能体架构,将跨域分类准确率从 21.7% 提高至 63.8%,误报率从 100% 降至 33.3%,在分布偏移下有效平衡灵敏度与特异性。多层证据一致性验证贡献 10.0 个百分点总体准确率,边带消歧单独贡献 7.1 个百分点,有效缓解 BPFO/BPFI 谐波重叠引起的系统性内外圈误分类。与三种 LLM 方法的参考比较显示,本文无需故障标签,域内准确率与完全监督替代方法差距在 1.7 个百分点以内,并在大域差距下提供更稳健跨域故障检测。此外,三 LLM 后端五次运行均值为 92.4%–95.1%,差距仅 2.7 个百分点,标准差 0.6–1.2 个百分点,确认能力主要由物理工具链架构而非某一 LLM 决定。需要指出若干局限。每样本 30–90 s 的端到端时间主要来自 API 延迟,因此框架定位为定期检查和离线维护支持,而非连续实时监测。框架尚未验证多故障同时存在的复合工况,例如外圈点蚀与保持架磨损同时发生。此时不同谱特征可能重叠,谐波逻辑会报告多个类型及各自计数。多证据综合或许能标记并发故障,但边带消歧原为内外圈二分设计,面对多种故障谱叠加的行为未经测试。通过幅值加权谐波评分和多故障假设检验扩展至复合诊断,是优先方向。防回退约束虽防止真实故障回退为正常,却引入互补风险:若初始诊断因偶然谱峰把健康轴承判为故障,约束会阻止系统自行纠正误报。这反映漏检代价远高于误报的安全关键非对称性。可考虑置信度门控放宽:若原诊断低置信且证据不完整,例如只匹配单个低 SNR 谐波,就放宽约束;也可设计人工覆盖路径,让工程师依据实体检查证据撤销已锁定诊断。与 LLM 方法的参考比较采用不同论文、不同划分、类别及协议,应解释为范式级权衡,而非受控对照。LLM 随机性虽有界,运行间不超过 1.2 个百分点,工业部署仍可能受益于多次诊断投票。最后,物理推理依赖准确几何参数和轴转速,长期磨损可能使其偏离名义值。4.6.7 节仅确认 下平稳退化,尚未覆盖严重磨损或错误文档引起的更大偏差。未来工作聚焦六个方向:以齿轮啮合频率公式替换运动学方程,将物理工具链扩展到多部件旋转机械。融合振动、声发射、电机电流等多传感器多模态信息,丰富异常指标与谐波消歧证据。引入 RAG,积累历史诊断案例以持续学习。构建物理与数据驱动混合架构:无标签框架作为初筛,故障数据可用后由微调模型细化分类。迁移至 7B–13B 轻量级本地 LLM,实现边缘部署;框架仅传输文本提示而非原始信号,自然适应工业“数据留在本地”的严格隐私要求。与制造执行系统(MES)和数字孪生平台集成,对智能产线多设备进行系统级状态监测。编辑:Kira校核:李正平、陈凯歌、Leo、曹希铭、赵学功、白亮、任超、海洋、陈宇航、Tina、王金、赵诚、肖鑫鑫、张优该文资料搜集自网络,仅用作学术分享,不做商业用途,若侵权,后台联系小编进行删除来源:故障诊断与python学习

未登录
还没有评论
课程
培训
服务
行家
VIP会员 学习计划 福利任务
下载APP
联系我们
帮助与反馈