让 LAMMPS 读懂 PFC 的命令和 FISH
过程里挖出四个真 bug,都是"PFC 脚本本该原样能跑"这条硬要求上的正面违反,每一个都能让脚本静默跑错。
1. 为什么要在 LAMMPS 上跑 PFC 脚本
PFC 是离散元的行业标准,脚本资产厚,用户多。但它不开源、并行效率一般、大规模算例吃力。
LAMMPS 反过来:开源、并行是强项、颗粒接触的底层设施齐全。问题是它的输入语言和我们习惯的那套根本不是一回事。
所以目标不是"把 PFC 脚本翻译成 LAMMPS",那是把负担推给用户。目标是:用户手里的 PFC 脚本一行不改,直接在 LAMMPS 上跑出可比的结果。
判据就两条:脚本原样能跑;关键量在同一量级。不追求逐位一致——两边求解器不同、接触模型实现不同,要求数字相等是把目标定错了。
2. 为了这件事,我们到底做了什么
先说规模:仓库里有一份 Code/开发日志.md,44 条可独立验收的记录,基本集中在一天之内——十几个 agent 并行推进,做完一件事就写一行、随代码一起提交。
下面按主线说。
2.1 一、把 PFC 的命令词汇搬进来
这一块最大。每个命令族都是"PFC 有、LAMMPS 没有"的东西:
model | save restore 转发到存档层,.sav 用 SQLite 而不是 Itasca 的二进制格式 | |
ball | ||
wall | 把墙从"一个 fix"变成"一等对象" | |
history | history export 的负 ID 语义:PFC 用负 ID 表示取反(值乘 −1) | |
table | ||
measure | ||
fracture |
接触体系整个换成了 PFC 的口径:ContactModel 基类 + linear / null 模型 + pair_style contact,不再是 LAMMPS 原来那种"函数指针拼积木"的写法。
2.2 二、把 FISH 这门语言做出来
单独建了一个 Code/Fish/ 模块:Fish 类本体 + fish / command 命令块 + fix fish/halt。
语法: @var = expr、def ... end(Itasca 原来的fish define也认)、[公式]、command ... endcommand、完整控制流数据类型:VEC / LIST / MAP / PTR(球指针就是 atom tag) 函数族: ball.*60 个、wall.*、contact.*、fracture.*、measure.*通用库: math.*补全、string.*、file.*、mech.*(含mech.timestep、domain.min/max.*)、数组、loop for/loop foreach、map()构造
这一块的验收口径只有一条:把 Itasca 原版脚本原样丢进去能跑。所以同一个语义有两三种写法时,全都得认——def name ... end 和 fish define name(...) ... end 就是典型。
2.3 三、存档:全量持久化
db save / db restore 现在覆盖整个模型状态:颗粒、接触、键、墙、fracture、接触材料表、FISH 定义(连函数体一起)、history、table。
这条路修的东西很能说明问题:无半径 atom style 下存取时的段错误、新长出来的数组段不清零导致的非确定性段错误(同一个脚本两次跑出不同结果)、以及存档把 FISH 内建函数也写进去、回读时静默丢弃。
2.4 四、接触变成"元素"
PFC 里接触是有两端身份的对象,LAMMPS 里它只是"两个原子之间算出来的一个数"。这条改动当时看着最不像功能,后来价值才显出来——它是 ratio-average 能算对、存档能记录球-墙接触、contact.* 这族 FISH 能存在的共同前提。
球-墙接触的几何原先在存档里全是占位值,因为墙侧发布的逐原子数据块只有 8 列;扩到 14 列之后,接触的两端都能只靠存档还原:球端查颗粒表,墙端查墙几何表。
2.5 五、维度分隔
LAMMPS_DIM 在编译期出两个独立产物,对齐 PFC2D / PFC3D 两条产品线。顺带把产物名从 pfc* 改成 lmp_2d / lmp_3d / lmp——仓库里不允许出现 pfc 的文件名。
2.6 两条辅助线
性能:恢复 PKG_GRANULAR;接触力循环走多线程(pair_style contact/omp,每线程一份接触模型副本);墙的力循环也走多线程。这里踩过一个坑:构建选项 PKG_OPENMP=OFF 时,树里那 320 个 /omp 变体从未真正编进二进制——文件都在,只是没进包。
教程:顶层 Example/tutorials/ 收入了 PFC 6.0 的全部 2D 教程——8 个目录、20 个 .p2dat、841 行,逐字节复 制并 md5 核验。
2.7 一条贯穿线:对齐验证挖出来的静默 bug
这是最后、也是最值钱的一段。起因只是"看看 demo/zhijian_shatu 里的脚本还缺哪些能力",结果一路挖到内核:
wall servo发散:增益原本是实测出来的(用上一拍的力响应去除位移),而刚接触时那个力是两笔大数相减的舍入残差,增益直接趋向 1e12,墙以与模型无关的速度被驱动。改成直接读接触刚度就好了——dF/ddisp本来就是刚度,读得到的东西不必去"测"。ratio-average收敛不了:症状是真的,归因是错的。真根因是存档往返丢了逐球的阻尼系数,整段加压在无阻尼下跑——不平衡力衰减到接触把荷载吃掉之后就停在残余抖动的平台上,没有东西耗散它。四个静默 bug:没有任何一个会报错,全都表现为"跑完了、看着也像那么回事、只是数字不对"。后面单独一节细说。
顺带记一笔我们自己的教训:日志里至少有两条结论后来被更正过——包括我自己写的"比值有数值下限,1e-5 永远达不到"。症状真、归因错,而这种写进注释的错误结论会被后来的人当事实用。
3. PFC 脚本里根本不存在的那些概念
这是整件事的核心。一份 PFC 脚本里,下面这些词一个都不会出现:
dimension 2 | model domain 的 4 个坐标自动判断 | |
units si | ||
atom_style sphere | ||
fix nve/sphere | model clean/cycle/solve | |
timestep | timestep automatic) | |
pair_style contact | ||
fix contact |
拿掉任何一条,脚本要么报错,要么更糟——跑完但什么都没发生。LAMMPS 里没有积分器时 run 2000 是合法的:它会老老实实跑 2000 步、打印一行热力学,然后颗粒一动不动。
这里有个坑值得单独说,我们踩过一次:判断"脚本有没有声明"必须靠标志位,不能靠"值等于默认值"。units lj 本身就是 LAMMPS 的默认值,第一版我们按值判断,结果六个存档往返脚本当场报"存档是 si、当前是 lj"。正确做法是让 units / atom_style / dimension / timestep 这几条命令各自置一个标志位。
3.1 具体接线长什么样:三种接法
上面说的是"补什么",下面说"怎么补"。PFC 命令接到 LAMMPS 上,基本就三种接法。
接法一:一行 PFC 展开成一串 LAMMPS 命令。
model domain 是典型。脚本写一行:
内部发出去的是七条:
三条设计决定值得说:
维度是数出来的。 PFC2D 的 extent给 4 个坐标,PFC3D 给 6 个——数一下就够了,不用问。每条只在脚本没自己写过时才发。 这就是上面那个标志位坑的落点。 走 region+create_box,不直接改内部对象。create_box已经把该做的初始化做全了(通信、邻居表尺寸、各种数组);绕过它自己拼盒子,等于把这些再实现一遍,还得跟上游保持同步。
接法二:PFC 的关键词变成 LAMMPS 命令的参数文本。
contact cmat 这族是这样。脚本写:
解析时,model 之后、range 之前的整段文字被原样存下来——因为它逐字就是 pair_coeff 在类型对后面要的参数。
然后 contact cmat apply 把定义表解析成材料矩阵(材料就是 atom type),给每个类型对挑出该用的那条(范围最具体的赢),最后逐个类型对调 pair 的系数接口,参数是 a b <那段原样的文字>。
顺带一提,apply 需要盒子已经存在(它得往颗粒上写材料号),所以它和 model domain 有先后关系。脚本里看着是两行不相关的命令,实际是一条流水线。
接法三:PFC 的对象落到 LAMMPS 的 fix 上。
wall create 建的是一个墙对象,不是 fix。但力总得有人算,所以第一次出现墙的时候内核自己装一个:
这行用户永远不用写。contacts 也不是可选项——PFC 里接触是个对象,注册表和存档都要看得见它,让用户每次记得加这个关键词就是个陷阱。
model cycle 是同一个思路的另一面:
展开成:
nve/sphere 解决的是"谁拥有时间":LAMMPS 里没有 fix 声明 time_integrate 时,run 是合法的——它会老老实实跑 3000 步、打印一行热力学、然后颗粒一动不动。PFC 里积分是求解器的事,脚本不写,只能我们补。
calm 是临时的(只在这次 cycle 期间有效),所以做成 fix + run + unfix 的三明治,而不是永久装一个。语义两边是对得上的:PFC 文档原话是"reset the linear and angular velocities to zero every i2 cycles"。
4. FISH:一个 @ 的两种意思
FISH 是 PFC 的脚本语言,大量出现在模型脚本里。它的一个核心设计是 @name,但这个符号有两种用法,混了就是灾难:
这里 @rdmin 是取值——展开成数值。
这里 @tau 是引用名字——命令要的是"哪个符号",不是一个数。如果按取值展开,@do_halt 会在解析那一行的时候就被替换成它当时的数值,之后再也不更新。
我们的做法是在输入层加一个识别器:碰到 history id / model solve fish-halt / fish callback add 这几个特定形状,把 @name 改写成带引号的字面量再往下传,命令那边去掉引号拿到名字。其他地方照常取值。
5. 接触是"元素",不是"pair 交互"
前面提过接触元素化的那一条,这里说它的代价和后果。
这个差别在 存档上要命。LAMMPS 的 db 存档如果只走 pair 邻接表,就只能枚举球-球对——球-墙接触整类丢失,因为墙接触来自墙的力循环、根本不经过 pair style。一个直剪算例丢了墙接触,等于把模型的约束全丢了。
所以内核里有一张接触注册表,接触一诞生就登记:两端身份、法向/切向力、间隙、接触点位置、所属模型。球-墙接触的那几个几何量原先在存档里是占位值,我们把墙侧的逐原子块从 8 列扩到 14 列才补齐。现在两端都能只靠存档还原:球端查颗粒表,墙端查墙几何表。实测 60 条墙接触的接触点落在其记录 facet 线段上的最大偏差是 6.9e-18 m,浮点零。
6. 四个真 bug
四个问题都是"PFC 脚本本该原样能跑"上的正面违反,而且全都是静默的。说细一点,因为它们不只是 bug,也是这套东西最容易被做错的地方。
6.1 一、fish-halt 的极性反了
PFC 文档的原话是:
The FISH function s is called during every cycle to determine whether cycling should continue. If s returns false, cycling continues; otherwise, cycling terminates.
返回真就停。 我们的实现写成了"非零继续、零停止",代码注释里还理直气壮地写着"语义是 PFC 的"。
后果:PFC 脚本里的收工条件长这样——do_halt = stop_flag,跑着的时候是 0、该停了是 1。到了我们这里,第一步就停。
连带还有一处:判定"这次算收敛了吗"用的是 final_halt == 0。极性翻过来之后,撞上 cycle 上限的失败跑分会被报成 settled——把失败说成成功,这是最坏的一种错。三处一起改才干净。
6.2 二、FISH 函数不隐式返回最后一次赋值的值
PFC 的规则是函数返回函数体最后一条表达式的值,而赋值也是表达式。所以这种写法在 PFC 里天然可用:
我们的 FISH 必须显式 return,于是 do_halt 求值出来是空值,读作 0。和上一条叠加:条件永远读 0,而 0 正好又是"还在跑"的样子,于是静默跑到 cycle 上限。
6.3 三、同名赋值会把函数整个删掉
这个是最后查出来的,也是最隐蔽的一个。
我们的 FISH 把函数和变量放在同一张符号表里,而赋值语句干的是:
于是上面那段脚本第一次被调用、执行到函数体里那句 do_halt = stop_flag 时,do_halt 就从函数变成了一个值为 0 的变量。此后每步读回 0,再也不调用它。
PFC 是两张表:def do_halt 建函数、do_halt = ... 写变量,引用解析到函数——model solve fish-halt 的文档写的就是"The FISH function s is called during every cycle"。
修法是:赋值命中已有函数时只更新它的值、不动它的种类。
6.4 四、@name 独占一行不是一条语句
@load_par 调用这个函数、只为副作用,返回值丢弃。这行以前能跑纯属侥幸——函数返回空,@ 展开之后整行变空,被跳过了。第二个 bug 一修,函数开始有返回值,同一行立刻变成 Unknown command: 100000。
补一条规则:整行就是一个 @name 时,它是 FISH 调用语句,值丢掉。
7. 结果:直剪算例
跑的是二轴剪切盒:60×60 mm、490 个颗粒、线性接触模型 + 摩擦、两侧伸缩缝防止颗粒从上下盒的缝里漏出去。
成样:孔隙率 0.1476(目标 0.15),PFC2D 同算例是 0.1507。
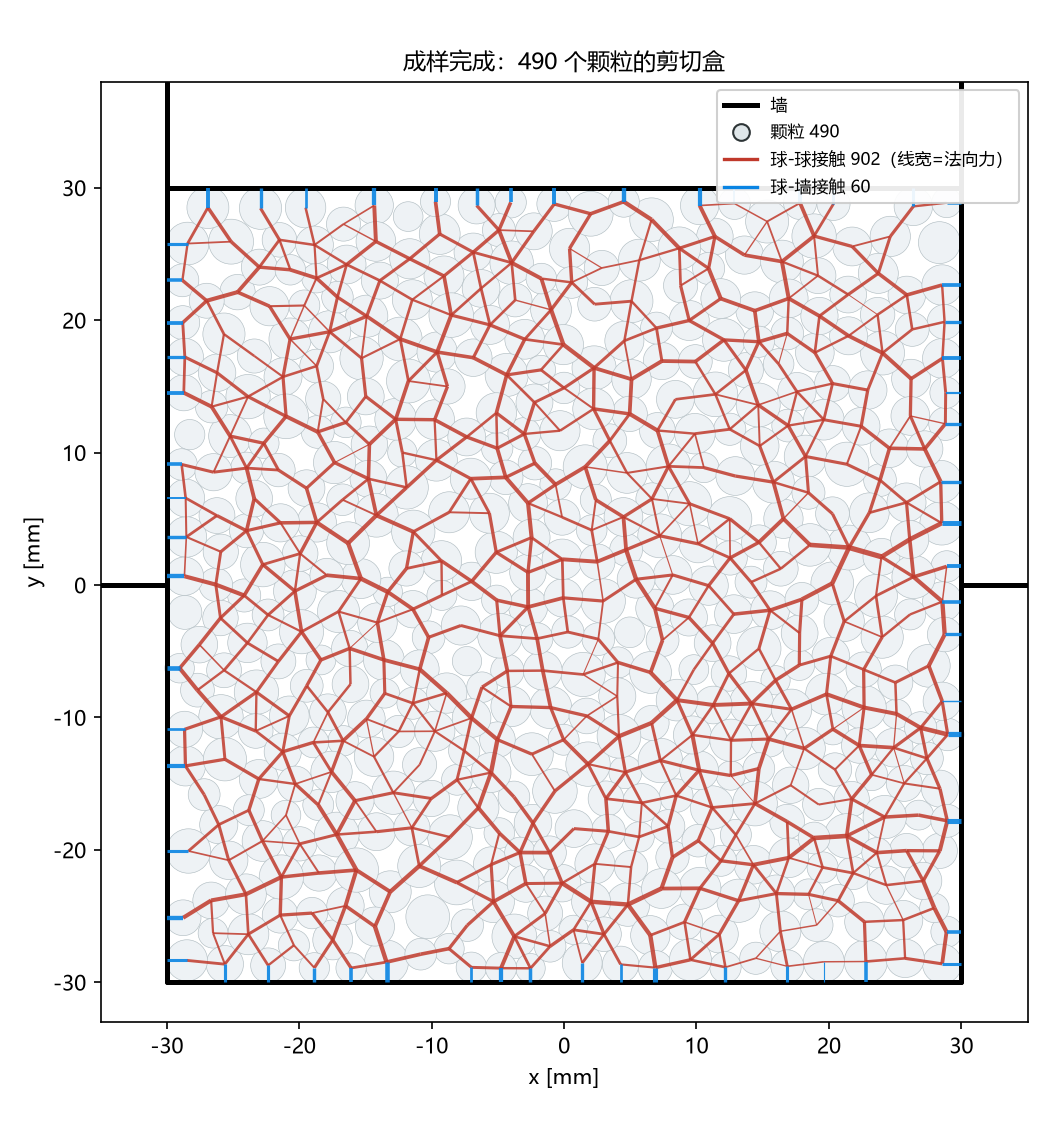 图1 成样完成后的剪切盒。红线是球-球接触,从球心画到球心,线宽正比于法向力——粗的地方就是传力链。蓝线是球-墙接触,从球心画到墙上的接触点。两种接触画法是同一套语言:一条接触一条线。
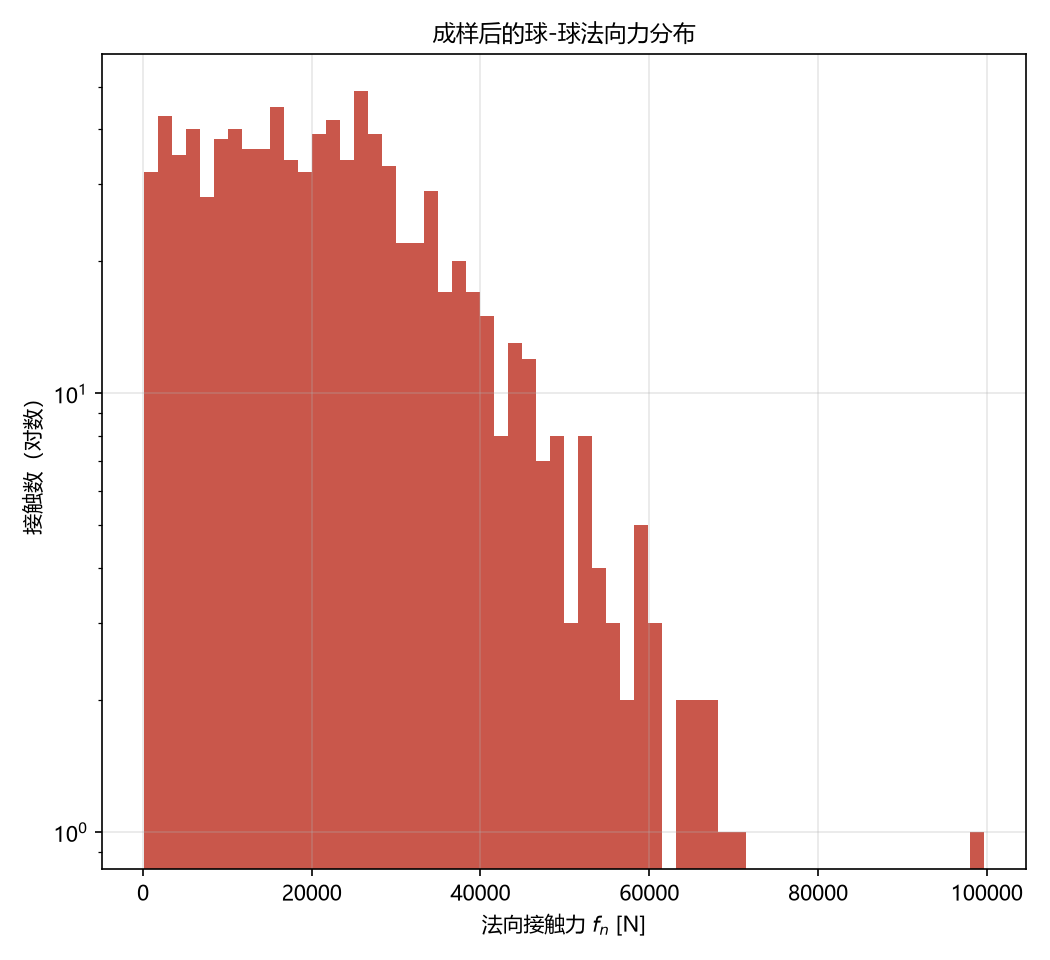 图2 球-球法向力的分布。装填得好不好,看这张图有没有长拖尾——拖尾越长,说明少数接触扛了大部分荷载,力链越不均匀。
加压:顶墙伺服压到 100 kPa。我们把整个加压过程的应力都采了下来,和 PFC2D 各跑一次叠在一起:
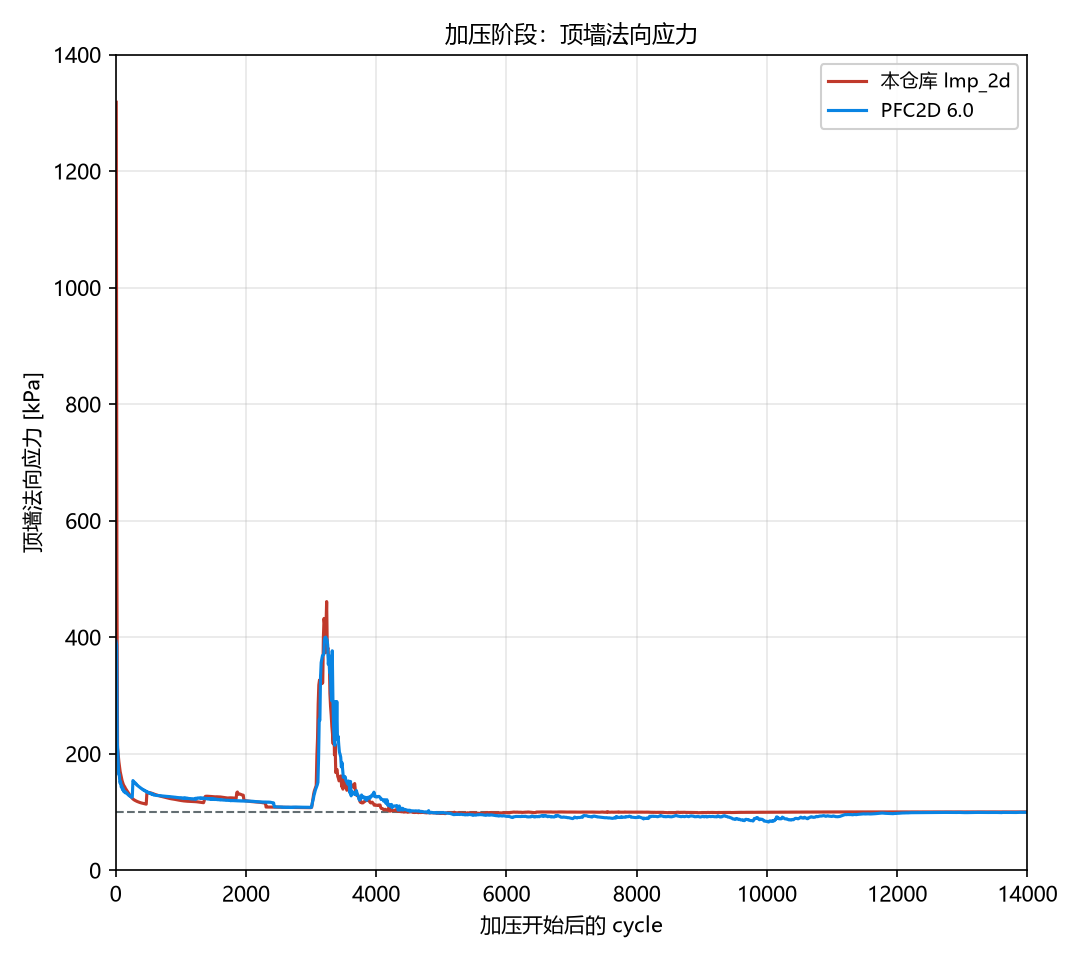 图3 同一个 5yali 脚本,本仓库与 PFC2D 6.0 各采一次。两条曲线除最开始的起动尖峰外几乎重合——包括 3000 cycle 处那个鼓包,那是脚本里
model cycle 3000 calm 10 结束、model solve 接手的一刻,两边都在同一个位置出现。真正的差别只有开头的起动尖峰:本仓库 13 倍、PFC 4 倍。
终值:本仓库 99.999 kPa,PFC2D 99.97 kPa。
加载:上半盒以 0.02 m/s 右移,剪到 6 mm。
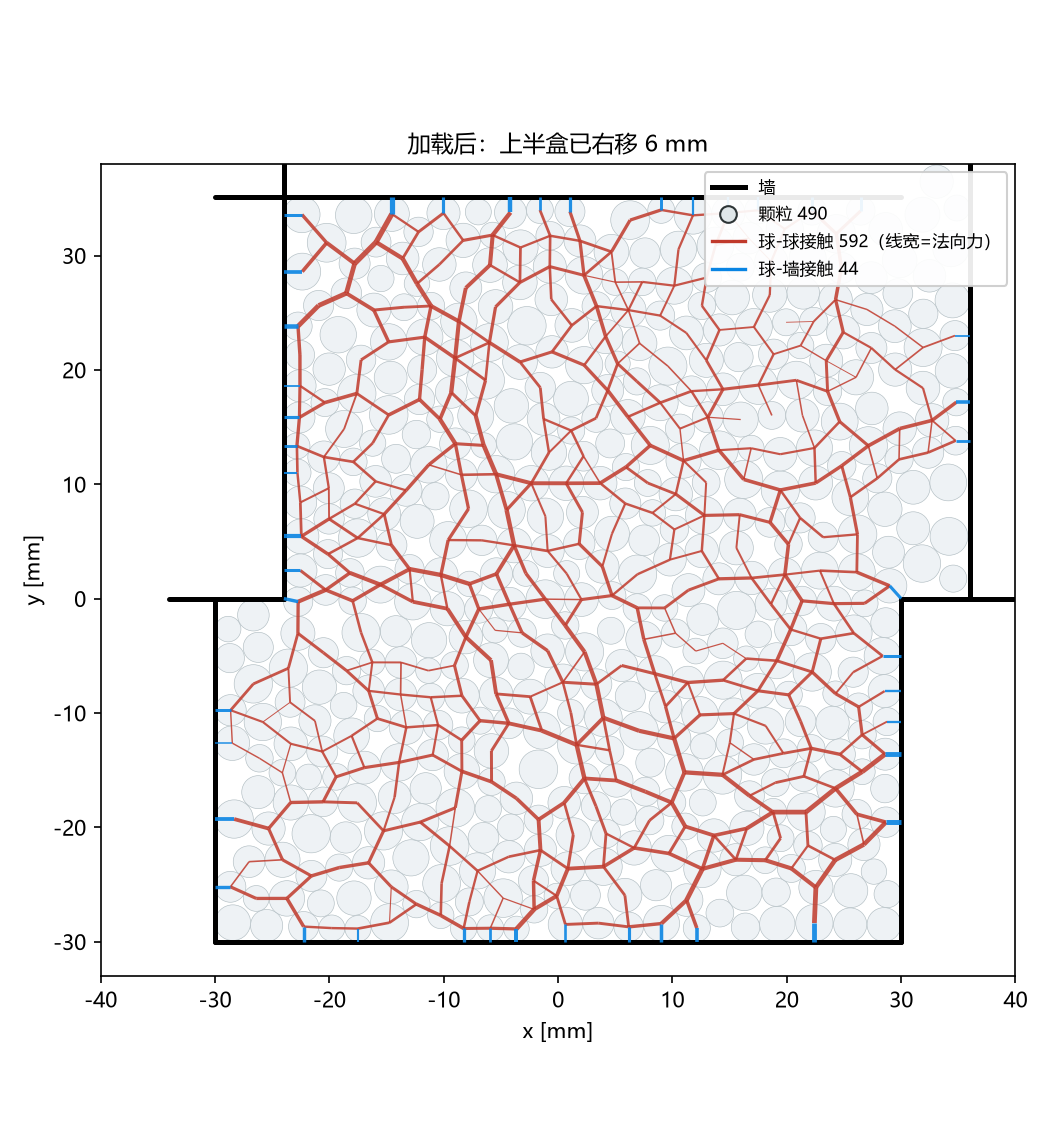 图4 加载后。上半盒右移了 6 mm,中间形成一条清晰的剪切带,带外两侧的组构基本完好。颗粒一个没漏。
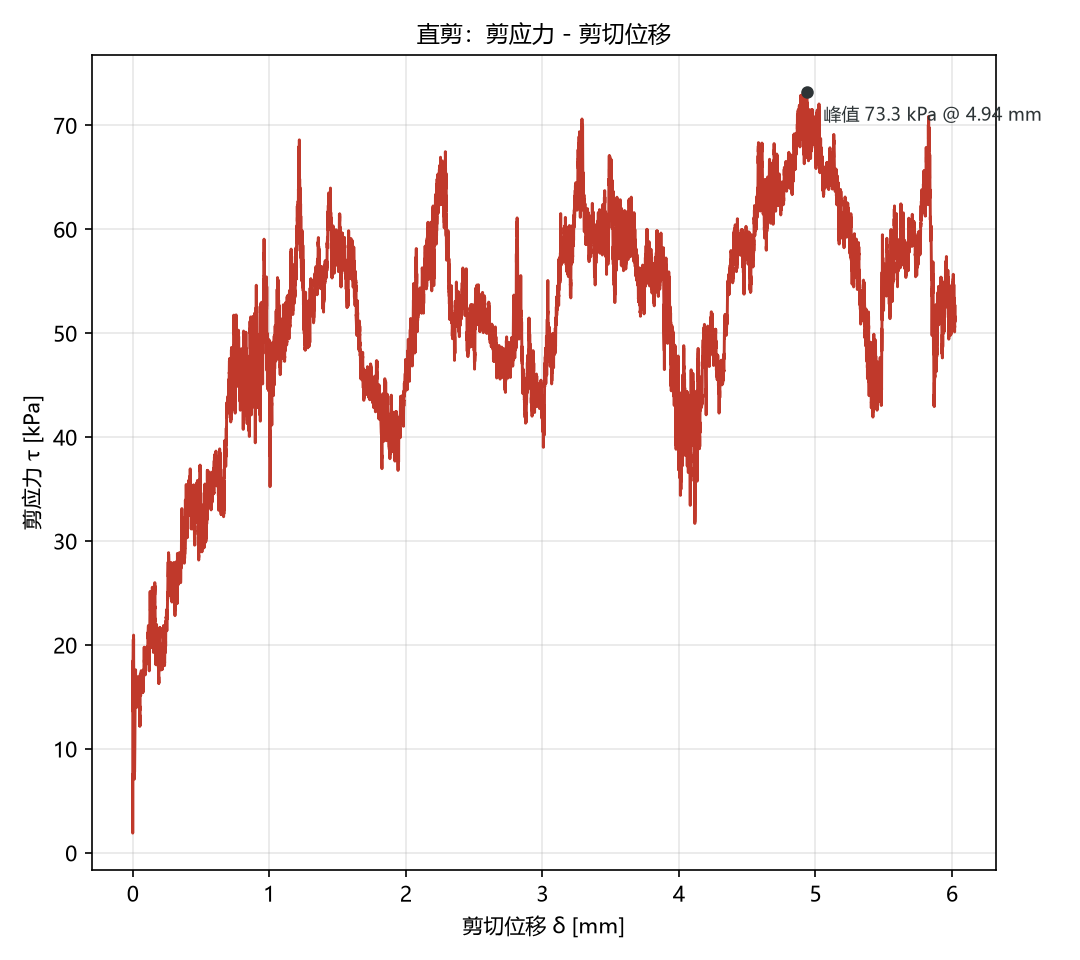 图5 剪应力随剪切位移的变化。峰值 73.26 kPa 出现在 4.94 mm,之后软化到 51.38 kPa。曲线上那些大幅起伏是粘滑——490 个颗粒的二维试样在这个剪切速率下就是这样,不是数值噪声。
8. 几个体会
"脚本能跑完"和"脚本跑对了"是两件事。 上面四个 bug,没有一个会让脚本报错。它们全都表现为"跑完了,结果看着也像那么回事"——只是数字不对。这种错最难发现,也最值得花力气去堵。
和另一个求解器对齐时,最有价值的不是结果数字,是过程曲线。 图3 那张对比图帮我们定位了两个问题:曲线在小位移处的分叉指向起动阶段的增益差异;而在收敛判据上,两边用同一套定义、同样的阈值,才让"收敛所需的 cycle 数"变成一个可比的量。
别把结论写进注释就完事。 我们代码里曾经有一段注释,用很肯定的语气写着"本 fork 的比值有数值下限,1e-5 永远达不到"。症状是真的,归因是错的——下限不在比值里,在一个存档往返丢掉的阻尼系数里。注释里的错误结论会被后来的人当事实用,比没有注释更糟。
我成立了一个 VibePFC 社群,专门聊 AI 怎么落地到 PFC / 数值模拟——让大模型读懂模型、自己改脚本、自动排查"看不懂"的问题。收一个 50 元的门槛费。
想进群的同学,加 QQ
763388012,备注"vibePFC"即可。 9. 参考资料
LAMMPS 官方文档:https://docs.lammps.org/ Itasca PFC 6.0 命令文档:https://docs.itascacg.com/pfc600/ 本文涉及的全部改动与四个 bug 的复盘:本仓库 Code/开发日志.md(44 条记录,按倒序)