从PPO到Agentic RL:2026大模型强化学习算法路线梳理
到了 2026 年,训练大模型要回答的问题早就不是"要不要用 RL",而是——
用哪一种 RL?基于什么奖励信号?配多大的算力预算?
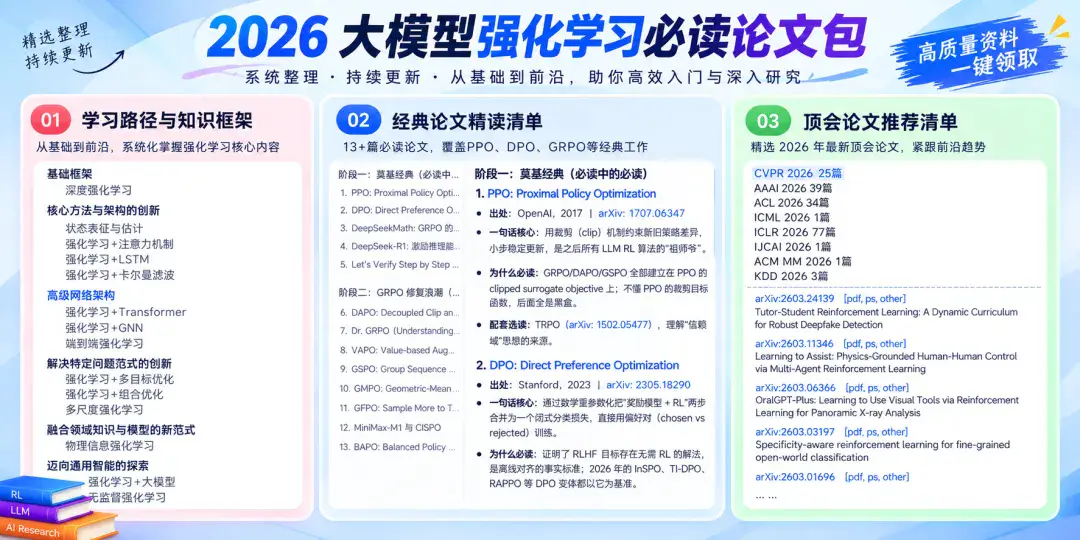
这篇文章我们结合强化学习的算法发展路径,把当前流行的 RL 算法一次讲清。同时整理了 22 篇强化学习必读论文 + 374 篇顶会强化学习前沿论文。
一、三大基石
所有新算法都是它们的"后代"
PPO
Proximal Policy Optimization|OpenAI,2017 · 核心标签:经典基石 / 稳定性优先 / 显存开销大
PPO 的核心是一个"裁剪"机制:严格限制新旧策略的差异,每次更新只迈一小步。就像教 AI 骑自行车——不许它因为一次摔倒就推翻全部经验,只允许微调,靠"小步快跑"累积稳定进步。
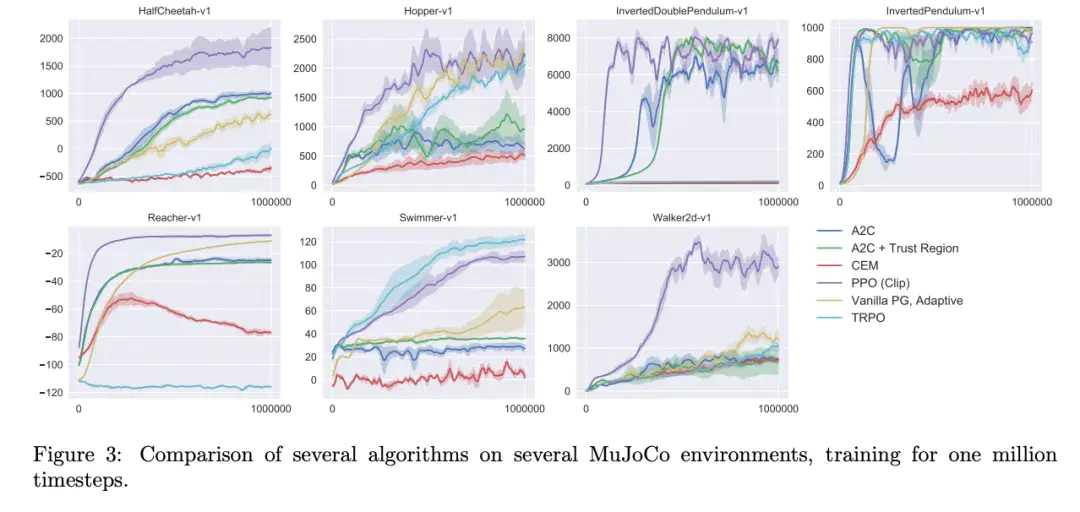
✅ 优势 训练稳健、不易崩、可控可复现
❌ 短板 策略网络 + 价值网络双份开销,千亿模型时代显存吃不消
现状:没死,但已不再是默认选项。多模态、具身智能和生产级对齐仍是首选。
DPO
Direct Preference Optimization|Stanford,2023 · 核心标签:颠覆性简化 / 离线对齐 / 单卡友好
DPO 做了一次漂亮的"减法":绕过奖励模型,直接拿"好答案 vs 坏答案"的对比数据做监督学习。训练流程和 SFT 一样简单,跑起来像微调,成本只有 PPO 的 1/2~1/4。
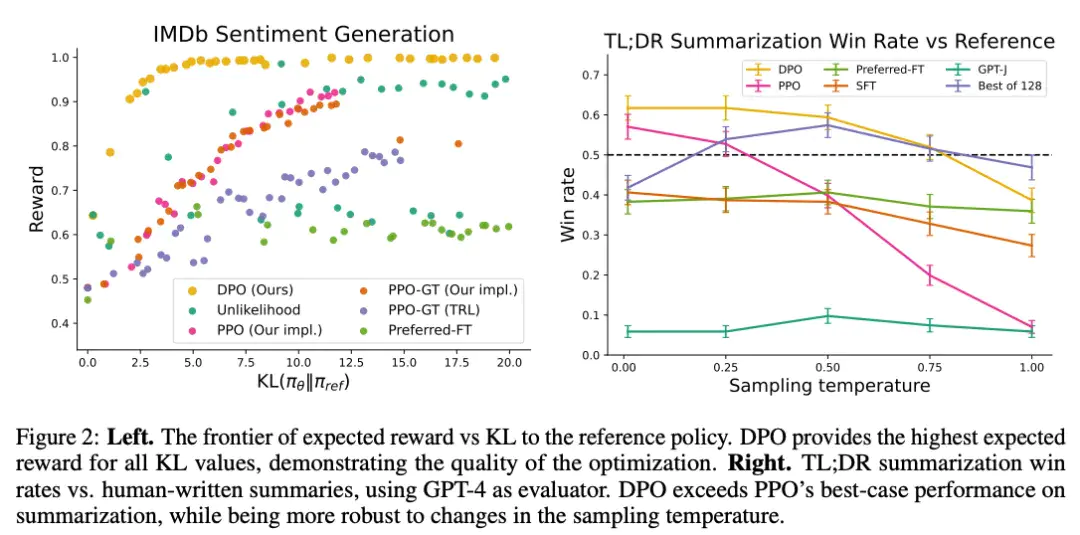
✅ 优势 轻量、稳定、无奖励黑客风险
❌ 短板 不探索——正确答案不在数据里,它就学不会
现状:中小模型对齐的事实标准。2026 年的 InSPO、TI-DPO、RAPPO 都是它的精细化后代。
GRPO
Group Relative Policy Optimization|DeepSeek,2024 · 核心标签:DeepSeek-R1 同款 / 去 Critic / RLVR 标配
GRPO 把 PPO 最贵的"裁判"(Critic 价值网络)直接砍掉:同一个问题采样一组答案,组内互相比——好的加分、差的扣分,像一场没有标准答案的"小组互评"。
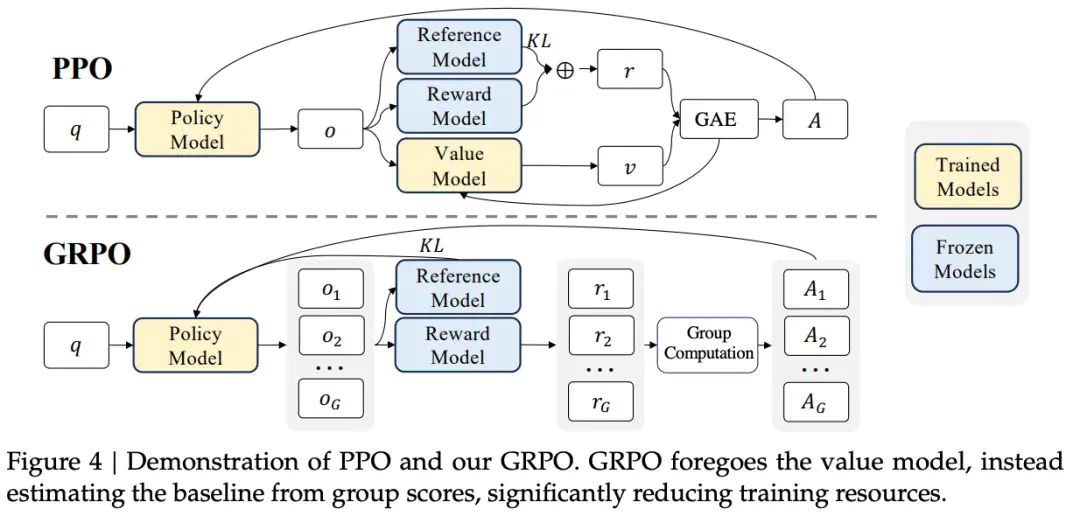
✅ 优势 显存省一半,天然契合"可验证奖励"
❌ 短板 采样趋同时学习信号消失;token 级噪声在长序列中不断累积
现状:DeepSeek-R1、Qwen、OLMo……2025-2026 年几乎所有开源推理模型背后都是它或它的变体。但 vanilla GRPO 是脆弱的。
二、GRPO:最卷的战场
2025-2026 年,算法是商品,稳定化才是真功夫
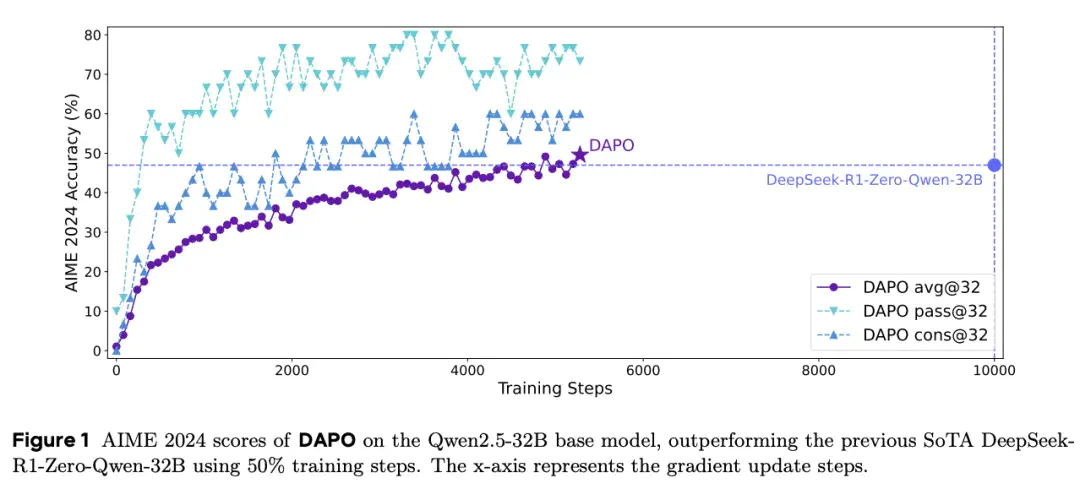
DAPO
字节 Seed · 核心标签:GRPO++ 事实标准 / 工业级
四件套:Clip-Higher(防熵崩溃)+ 动态采样(跳过全对/全错的无效题)+ Token 级损失(消除长度偏差)+ 超长样本惩罚。Qwen2.5-32B 在 AIME 拿到 50 分,训练步数只要 DeepSeek-R1 的一半,且全开源。长推理训练,从它抄作业就对了。
GSPO
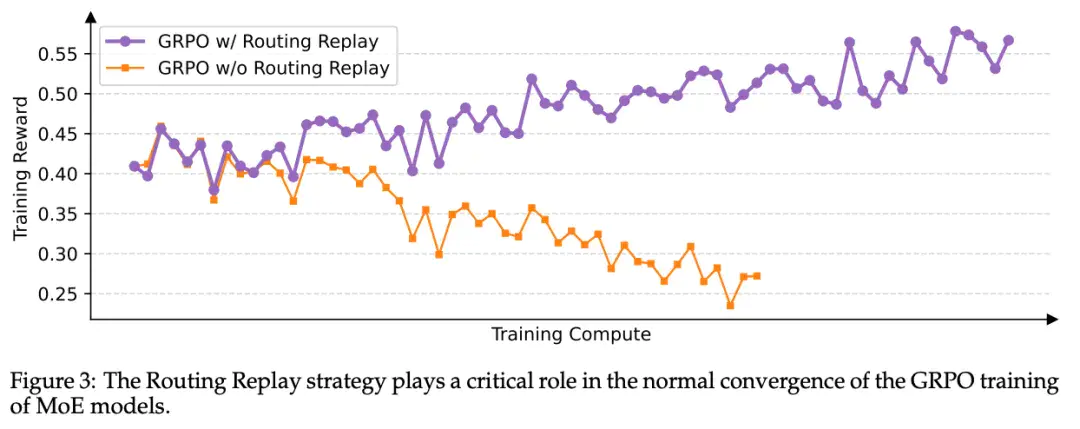
阿里 Qwen · 核心标签:Qwen3 同款 / 序列级优化 / MoE 友好
GSPO 认为好文章看的是整体而非单个字:把重要性比值从 token 级提升到整段序列级,彻底消除长序列的噪声累积,MoE 模型还不用再打 Routing Replay 补丁。训 MoE 大模型,目前最稳的选择。
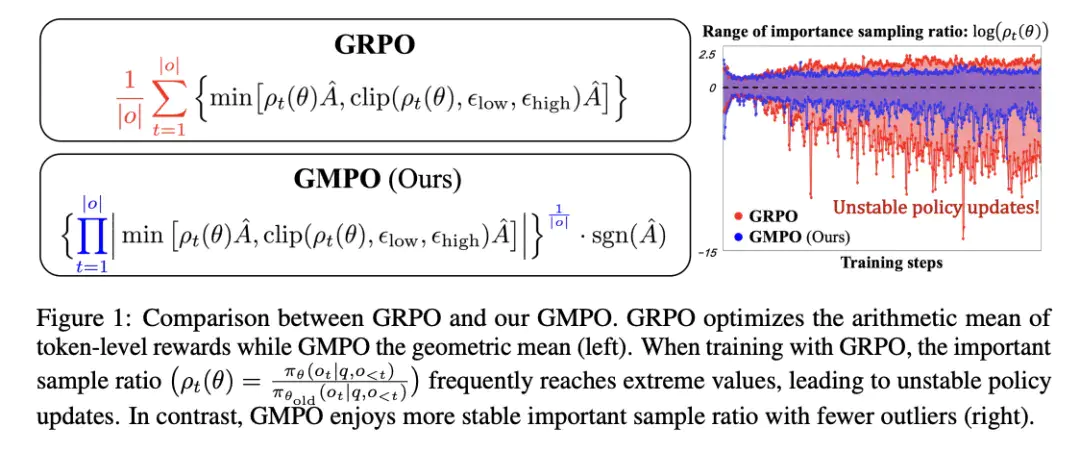
GMPO
Microsoft Research · 核心标签:换种平均就稳了
用 token 比值的几何平均替代算术平均,天然抑制异常 token 的影响(数学上可证 |J_GMPO| ≤ |J_GRPO|)。GMPO-7B 数学 Pass@1 直接 +4.1 个点。
GFPO
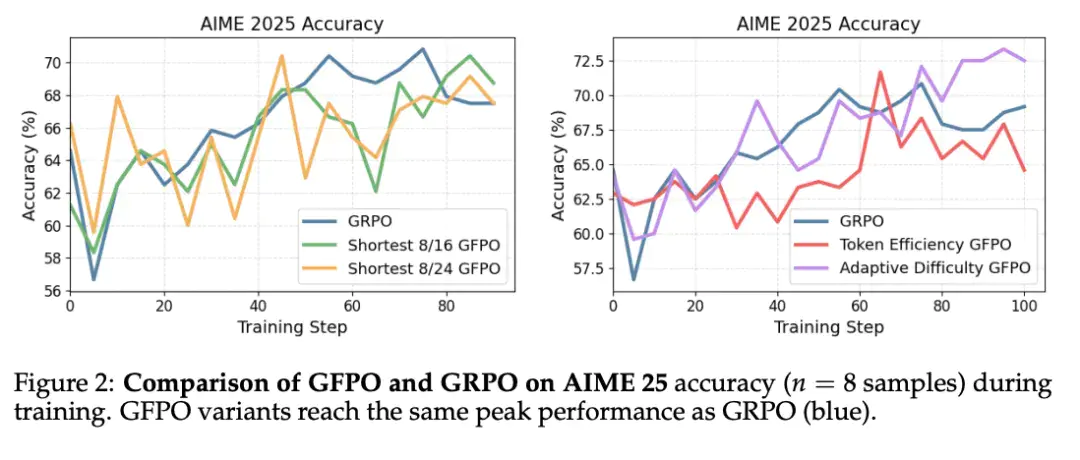
Microsoft Research · 核心标签:治"话痨"专病
RL 训练会让模型越说越长但不见得更准。GFPO 多采样再按"最短回答 / token 效率"过滤,只训最优子集——长度压缩 70-85%,精度不掉。
VAPO / CISPO / BAPO
字节 Seed / MiniMax / Fudan
VAPO:把价值模型请回来做精细信用分配,长 CoT 任务上打脸"无 Critic 万能论";
CISPO:只裁剪权重不裁剪 token,保住"wait、recheck"这类低概率反思词,比 DAPO 快 2 倍;
BAPO:离线 / 异步场景的自适应平衡器,防止模型学历史失败案例学到"摆烂"。
三、2026 主战场:Agentic RL
从"会聊天"到"会做事"
单轮做题的红利吃完后,所有人的火力都转向了多轮工具调用、长程规划的 Agent RL。这里有三个新问题:奖励更稀疏、信用更难分配、rollout 更烧钱。
ARPO
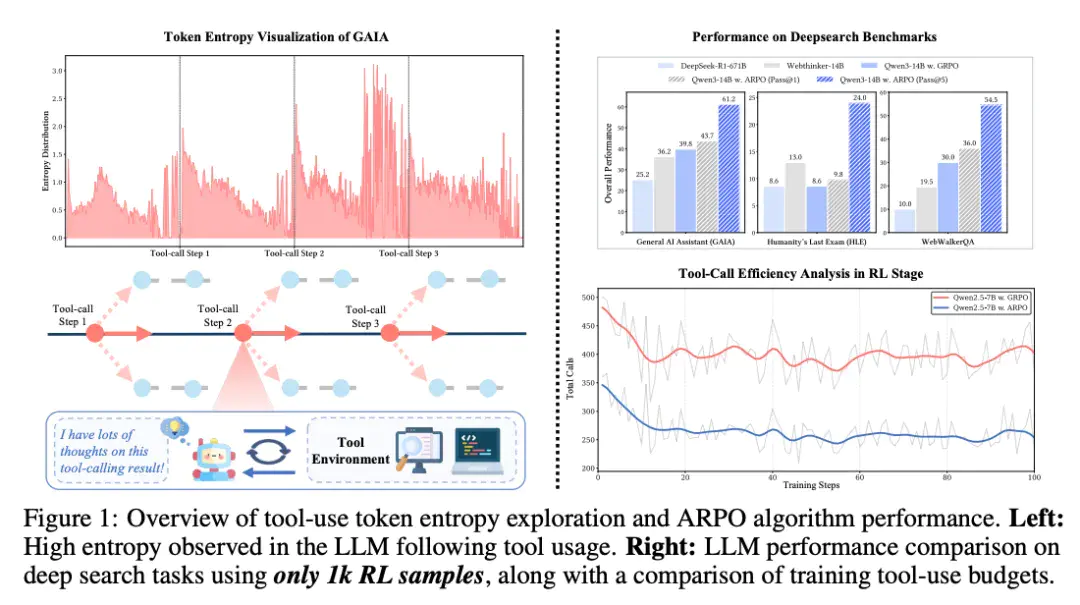
Agentic RL 开山作
关键洞察:Agent 在工具调用返回的那一刻,token 熵会骤增——那是决策分叉点。ARPO 只在这些"卡脖子"步骤分支采样、重点探索,token 消耗大降、任务成功率大升。
Tree-GRPO
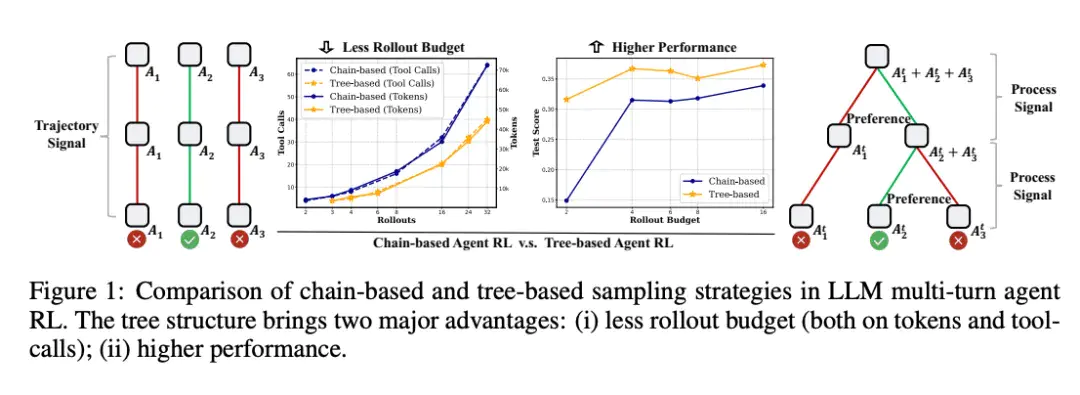
ICLR 2026
把树搜索搬进 Agent RL:共享前缀让同样 token 预算下 rollout 数量翻倍,树结构还天然免费送出步级过程监督信号。11 个数据集全面碾压链式方法。
GiGPO / CW-GRPO / AT-GRPO
ALFWorld / ACL 2026 / ICLR 2026
GiGPO:组中组,轨迹级 + 步级两层优势,ALFWorld +12%;
CW-GRPO:用 LLM Judge 给每轮检索打"贡献分"重缩放优势,搜索 Agent 提升显著;
AT-GRPO:多智能体系统专用,按角色 / 轮次分组,长程规划从 14% 干到 96%+。
另外,Critic 回归可能是 2026 最值得玩味的一条线:智谱 GLM-5 从 GRPO 起步,GLM-5.2 在长程 Agent 阶段明确放弃组相对优化、改回基于 Critic 的方法。
原因在于:当一条几十步的 Agent 轨迹被压缩成数量不等、长短各异的子轨迹,GRPO"组内可比"的假设就崩了——同一 prompt 的 rollout 根本没法公平对比。只有 Critic 能对单条轨迹做 token 级优势估计。
加上 GCPO(几何子空间约束)等 2026 新工作的出现,一个清晰的判断是:
"GRPO 家族 + 可验证奖励"的共识,正在长程 Agentic 场景松动。2026 年的 RL 版图,正在裂变成"短推理用 GRPO 系、长 Agent 回 Critic 系"的双轨制。