
2-42 GM(1,1) 的背景值权重怎么选?粒子群自动搜索的应用
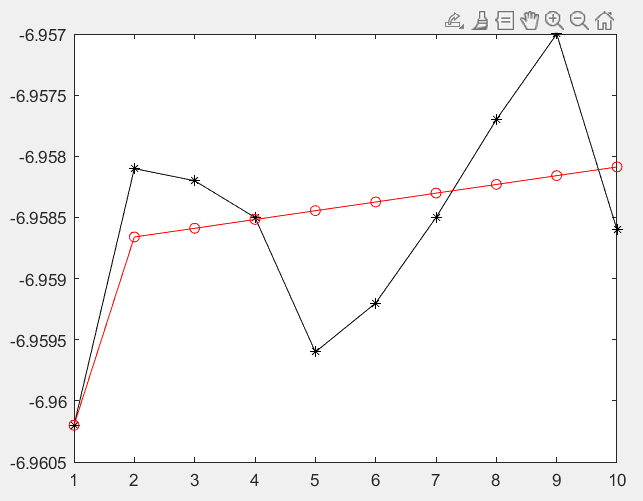
一句话介绍: 这套程序针对一组 10 点短序列,把传统 GM(1,1) 中固定的背景值权重扩展为可搜索参数,再用 20 个二维粒子迭代 30 代寻找更合适的权重组合;随后仍通过最小二乘求发展系数和灰色作用量,并输出粒子群收敛过程以及原序列与 GM(1,1) 拟合序列的对比结果。
先看它解决什么问题
GM(1,1) 很适合“小样本、信息不完全”的序列建模,但模型里有一个容易被忽略的细节:相邻累加值怎样组合成背景值,会直接改变参数矩阵,进而改变发展系数和灰色作用量。
传统写法常把相邻两点等权平均,也就是把背景值权重取为 0.5。当前程序没有把这个权重固定死,而是让粒子群在 0~1 内自动搜索。
当前程序的真实处理链是:
10 点原始序列 → 一次累加 AGO → 可调背景值 → 最小二乘求 GM(1,1) 参数 → 计算一级拟合误差 → 对误差再次建立 GM(1,1) → 构造粒子群适应度 → 20 粒子迭代 30 代 → 取得最优二维 权重 → 用第一维 权重重新拟合原序列 → 输出参数与拟合对比
需要先说明一个关键事实:
粒子群并没有直接把发展系数 a 和灰色作用量 u 当作粒子位置;它搜索的是背景值权重,a 和 u 仍由最小二乘计算。
1. 当前工程里真正有哪些文件?
工程主体很小,核心逻辑集中在 4 个 MATLAB 文件中。
文件 | 当前作用 |
|---|---|
main.m | 主入口,定义数据与粒子群参数,完成初始化、迭代寻优和结果调用 |
fun.m | 粒子群适应度函数,串联两次 huise 计算 |
huise.m | 给定背景值权重后建立 GM(1,1),返回当前序列的拟合误差 |
yuc e.m | 用最终选中的第一维 权重重新建立 GM(1,1),打印参数并绘制真实值/拟合值 |
maydata.mat | 工程附带的历史工作区数据;当前 main.m 中加载语句已被注释,不参与默认运行 |
maydata.mat 里保存的是另一组 50 点序列以及 50 次迭代等变量,而当前主程序实际写死的是 10 点序列 + 30 次迭代。因此,理解当前程序时应以 main.m 的活动代码为准,不能把 maydata.mat 中的旧工作区变量当作本次默认结果。
2. 当前程序默认分析的是什么数据?
main.m 直接给出序列:
X = (-6.9602, -6.9581, -6.9582, -6.9585, -6.9596, -6.9592, -6.9585, -6.9577, -6.9570, -6.9586)
这组数据共有 10 个点,整体集中在 -6.96 附近,最小值为 -6.9602,最大值为 -6.9570,波动范围只有约 0.0032。
也就是说,这不是一个大样本机器学习任务,而是一个典型的短序列灰色建模实验。
3. GM(1,1) 为什么先做一次累加?
huise.m 和 yu ce.m 的第一步都是:
y = cumsum(x);
也就是把原序列 x 变成一次累加序列 y:
y(k) = Σᵢ₌₁ᵏ x(i)
GM(1,1) 的基本思路不是直接在原始离散点之间硬拟合,而是先通过累加降低局部起伏,再用一阶灰色微分方程描述累加序列的变化趋势。
对当前程序来说,这一步把:
原始 10 点序列 → 一次累加序列
然后所有背景值、参数矩阵和时间响应式都基于这个累加序列继续计算。
4. 粒子群真正搜索的参数是什么?
传统 GM(1,1) 常使用相邻累加值的等权背景值。当前源码把这个关系推广成:
z(k) = m·y(k) + (1-m)·y(k-1)
其中 m 是背景值权重。
当 m=0.5 时,就是常见的相邻均值;当 m 向 0 或 1 移动时,背景值会更偏向前一个或后一个累加点。
当前每个粒子有两维:
粒子位置 = (m₁, m₂)
两维都被限制在:
0 ≤ m₁ ≤ 1,0 ≤ m₂ ≤ 1
其中:
m₁ 用于对原始序列 X 建立第一层 GM(1,1);
m₂ 用于对第一层模型产生的误差序列再次建立 GM(1,1)。
因此,项目说明里所说的“优化发展系数和灰色作用量”,在当前源码中的实际实现方式是:
先优化背景值权重,再由新的背景值矩阵间接改变 a 和 u 的最小二乘估计。
5. 给定一个背景值权重后,a 和 u 是怎样算出来的?
对每一个候选权重 m,程序都会构造矩阵 B 和向量 C。
每一个背景值对应一行:
B(k,:) = (-z(k), 1)
而观测向量取原序列第 2 个点到最后一个点:
C = (x(2), x(3), …, x(n))ᵀ
随后源码直接计算:
U = (BᵀB)⁻¹BᵀC
其中:
U = (a, u)ᵀ
也就是说:
a 是发展系数;u 是灰色作用量。
这一步仍然是标准的最小二乘参数估计,所以当前程序并不是“用 PSO 彻底替代最小二乘”。PSO 改变的是进入最小二乘的背景值,最小二乘仍然负责真正求解 a 和 u。
6. GM(1,1) 最后怎样还原出拟合序列?
求得 a 和 u 后,程序先令:t = u / a
再按当前源码构造累加序列的时间响应:
ŷ¹(k) = (y(1) - t)·e⁻ᵃ⁽ᵏ⁻¹⁾ + t
然后通过相邻差分恢复原尺度序列:
x̂(1) = x(1)
x̂(k) = ŷ¹(k) - ŷ¹(k-1),k ≥ 2
huise.m 最终返回的是:
e = x̂ - x
也就是“模型拟合值减原始值”的误差序列。
这条关系非常重要,因为后面的粒子群适应度正是建立在这个误差序列之上。
7.fun.m 的适应度到底在最小化什么?
对一个二维粒子 (m₁, m₂),fun.m 先计算:
e₁ = huise(X, m₁)
接着又把第一层误差 e₁ 当作新的序列:
e₂ = huise(e₁, m₂)
最后构造:
J = Σᵢ (e₁(i) - e₂(i))²
但函数返回的是:
fitness = -J
而 main.m 使用 max 寻找最大适应度,所以整个粒子群实际等价于:
在 m₁、m₂ ∈ [0,1] 内,让 J 尽可能小。
这里必须区分一个概念:
abs(fitnesszbest)只是当前自定义目标 J 的数值,不等同于常见的 MSE、RMSE、MAPE,也不能直接当作“预测精度百分比”。
当前工程没有另外编写传统预测误差指标,也没有在默认脚本里把 PSO-GM(1,1) 与固定 m=0.5 的普通 GM(1,1) 做统一指标对比。因此,辅助说明中“预测精度得到较大提高”的描述,不能仅靠当前活动代码直接定量验证。
8. 粒子群怎样在 0~1 之间寻找权重?
当前粒子群配置为:
粒子数 sizepop = 20;
迭代次数 maxgen = 30;
学习因子 c1 = c2 = 1.49445;
每个粒子 2 维;
速度限制为 -0.25~0.25;
位置限制为 0~1。
速度更新可概括为:
v ← v + c₁r₁(pbest - x) + c₂r₂(gbest - x)
随后依次执行:
速度限幅 → 更新粒子位置 → 位置限幅 → 重新计算适应度 → 更新个体最优 → 更新全局最优
这里没有单独设置惯性权重 w,源码直接把上一代速度完整保留下来,相当于速度历史项系数为 1。
整个搜索链可以压缩成:
随机初始化 20 个二维粒子 → 计算适应度 → 30 代速度/位置更新 → 保留个体最优 → 保留全局最优 zbest
9. 最终得到的两个最优权重都进入预测了吗?
这是当前源码一个非常值得注意的实现细节。
粒子群搜索得到:zbest = (m₁*, m₂*)
但 main.m 最后调用的是:yu ce(X,zbest(1))
也就是说,最终对原始序列进行 GM(1,1) 拟合时只使用:m₁*
第二维最优值 m₂* 只参与 fun.m 的适应度评价,并没有在 yu ce.m 中继续做残差补偿或二次预测。
因此当前程序更准确的结构是:
二维 权重共同决定搜索目标 → 最终只取第一维 权重建立输出模型
而不是:
两层 GM 结果叠加后共同形成最终预测。
10. 当前程序最后会输出什么?
主程序完成迭代后,会得到三类结果。
第一类是粒子群搜索结果:
zbest:当前全局最优的二维背景值权重;
abs(fitnesszbest):当前自定义目标函数 J 的最优值;
abs(yy):各代全局最优目标值,用于观察迭代过程。
第二类是最终 GM(1,1) 参数:
B:由最终第一维 权重生成的参数矩阵;
A = U:即当前求得的 (a, u)ᵀ。
第三类是序列对比:原始序列 x;同长度拟合序列 xx;两条序列的曲线对比。
需要特别注意:y uce.m 的循环仍然只生成与原始 10 点序列等长的 xx,没有继续计算第 11、12……个未来时刻。
所以按当前源码,图中标注的“预测值”本质上是:
对已有样本的 GM(1,1) 建模拟合/重构值,而不是向样本区间外继续外推的未来预测值。
11. 当前源码还有哪些必须公开的边界?
第一,随机状态没有固定
粒子初始化、初始速度以及每次速度更新都调用 rand,但脚本没有设置 rng。
因此同一 MATLAB 会话中,如果之前的随机状态不同,最终 zbest 可能不同。当前代码不应把某一次随机运行结果写成永远固定的常数。
第二,当前默认序列全部为负值
标准 GM(1,1) 常用于非负、小样本、趋势相对平稳的序列,并经常配合级比检验等建模条件检查。
当前 X 的 10 个点全部约为 -6.96,源码没有平移变换、正化处理或级比可行性检查。因此它更适合用于观察“背景值权重 + PSO + GM(1,1)”的算法实现,而不能直接当作已经完成全部灰色建模检验的通用预测工具。
第三,参数求解显式使用矩阵求逆
源码采用:
(BᵀB)⁻¹BᵀC
数学上是最小二乘正规方程,但在数值计算中,若矩阵病态,显式 inv 会比 MATLAB 的反斜杠求解更敏感。当前 10 点示例可以照原程序运行,但迁移到新数据时应注意数值稳定性。
12. 为什么这个改进思路仍然值得研究?
因为 GM(1,1) 的 a 和 u 虽然最终由最小二乘求得,但它们并不是脱离背景值独立存在的。
改变 m 会先改变:背景值 z(k)
然后继续改变:参数矩阵 B → 最小二乘结果 a、u → 时间响应 → 拟合序列 → 残差
所以,把固定的 m=0.5 改成数据驱动搜索,本质上是在优化 GM(1,1) 参数估计的前置条件。
粒子群的价值在于:不需要手工枚举每一组权重,也不要求目标函数具有简单解析梯度,只要能够根据候选权重计算适应度,就可以通过群体搜索寻找更合适的区域。
对这个小工程来说,真正值得学习的不是“PSO 一定能让所有 GM(1,1) 大幅提精度”,而是这条建模思路:
把原本固定的经验参数暴露出来 → 定义可计算目标 → 用优化算法自动搜索 → 再回到原模型完成参数估计。
13. 哪些参数最值得修改?
当前程序里真正会改变搜索行为的主要是下面几项。
参数 | 当前值 | 为什么值得改 | 调整后的主要影响 |
|---|---|---|---|
maxgen | 30 | 决定粒子群搜索轮数 | 增大可获得更多搜索机会,但计算次数增加 |
sizepop | 20 | 决定每代候选解数量 | 增大可提高群体多样性,但每代适应度计算更多 |
c1、c2 | 1.49445、1.49445 | 决定个体经验和群体经验对速度更新的影响 | 改动会改变搜索步幅、聚集速度与振荡特性 |
Vmin、Vmax | -0.25、0.25 | 限制单次速度幅度 | 范围过小搜索慢,过大则更容易撞到位置边界 |
popmin、popmax | 0、1 | 定义两个背景值权重的搜索范围 | 直接决定 m₁、m₂ 可以探索的区域 |
如果要换自己的数据,最先修改的是 main.m 中的 X,但 X 属于输入数据,不是粒子群算法参数。
14. 怎么运行?
直接运行:main,当前源码只使用 MATLAB 基础矩阵运算、随机数和绘图函数,没有看到必须依赖额外 Toolbox 的调用。
如果需要做可重复实验,可以在粒子初始化之前自行固定随机种子,例如增加 rng(0);但这属于复现实验时的改动,原始源码本身没有固定随机种子。
还要注意:当前 yu ce.m 输出的是已有样本区间内的同长度拟合结果。如果需要真正预测未来第 n+1 个点,还需要在时间响应序列上继续向后生成,并单独增加预测误差验证逻辑。
15. 一句话看懂这个项目
这是一个PSO + GM(1,1) 灰色模型实验程序:默认输入 10 个约为 -6.96 的短序列样本,先通过一次累加建立 GM(1,1),再把传统固定背景值权重扩展为两个 0~1 的搜索变量,用 20 个二维粒子迭代 30 代,根据两层灰色模型误差构造的自定义目标寻找最优权重;背景权重改变后,程序仍用最小二乘计算发展系数 a 和灰色作用量 u,并最终只取zbest(1)对原始序列进行同长度拟合与曲线对比。需要注意,zbest(2)没有进入最终残差补偿、默认结果受随机状态影响、当前“预测值”不是未来外推值,而且源码没有给出标准精度指标或优化前后统一对照,因此它更适合用于学习和实验“PSO 如何优化 GM(1,1) 背景值参数”这条完整实现链。


