仿真技能那么多,学不过来怎么办?
很多刚入行的仿真工程师都会问:
我应该先学 Fluent,还是先学 COMSOL?
要不要学 Abaqus、Python、AI、FNO?
这个问题我很理解,因为我自己也是这样走过来的。
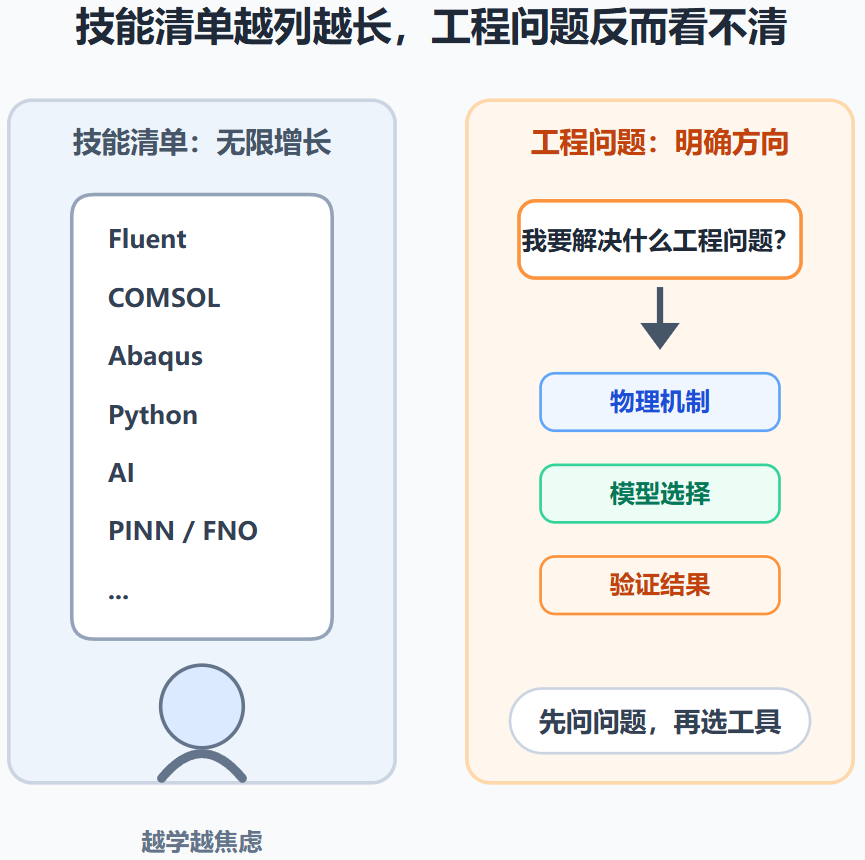
刚开始接触仿真时,CAE 很容易被看成一张永远学不完的技能清单:Fluent、COMSOL、Abaqus、CFD、FEM、热、电化学、Python、AI、优化……越列越多,越看越焦虑。
但现在回头看,问题可能不在于我们不够努力,而在于一开始就把学习路径想错了。
很多年轻工程师一上来就问:
我应该先学哪个软件?
但更重要的问题其实是:
我到底想解决什么工程问题?
这两个问题的顺序一旦反了,后面的学习状态会完全不同。
一、技能清单是无限的
如果从“我要学哪些软件”出发,这条路没有尽头。
今天觉得 Fluent 很重要,明天发现 COMSOL 也重要;后天项目里出现 Abaqus,再过一阵子又听说 AI surrogate model、PINN、FNO。
每多接触一个方向,就会多出一堆新名词。学习路线如果变成:
技能 → 技能 → 技能 → 技能
人一定会焦虑,因为这个清单本来就是无限的。
更重要的是,即使你学过很多软件,也不一定能解决真实工程问题。
你可能知道按钮在哪里,也能跑几个示例,但真实项目来了,仍然可能不知道:这个问题该不该简化?需要 2D 还是 3D?哪些物理必须保留?边界条件怎么定?结果怎么验证?仿真到底能不能指导设计?
这就是“会软件”和“会解决问题”的区别。
软件当然重要,但软件不应该是学习的起点。真正的起点应该是问题。
二、我做电池时,不是为了学 COMSOL 而学 COMSOL
我最早做电池仿真时,表面上是在学 COMSOL、电化学模块和多物理场耦合。
但真正驱动我学习的,并不是:
我要成为 COMSOL 专家。
而是一个更具体的问题:
一个电芯设计出来以后,它的性能会怎么样?容量、倍率、温度、安全性、寿命,会受到哪些因素影响?
为了回答这个问题,我才一步步发现自己缺什么。
想预测充放电性能,就必须理解电化学过程;发现倍率升高会带来温升,就必须理解热传导;发现材料膨胀和应力会影响寿命,又要理解力学和失效;如果优化设计太慢,就会去学 Python、surrogate model、Bayesian optimization。
所以这条路线不是随机的。它不是:
COMSOL → Python → AI → Optimization
而是:
我要预测电芯性能
↓
发现需要电化学、热、力学和优化
↓
于是学习对应工具
这就是问题牵引式学习。
表面上,我学了很多不同的东西,但它们都被同一个工程问题串起来了:
如何在电芯真正制造出来之前,预测它的表现,并帮助设计更好的方案?
所以我后来越来越觉得,真正重要的不是“我学过 COMSOL”,而是我完整经历过一次:
定义问题 → 拆解物理机制 → 建立模型 → 计算验证 → 指导设计
这个闭环,比某一个软件本身更重要。
三、后来做工艺过程仿真,我发现底层逻辑还是没有变
后来我开始接触工艺过程相关的仿真,尤其是狭缝涂布这一类问题。
这时候,研究对象和之前做电池性能仿真不太一样了。
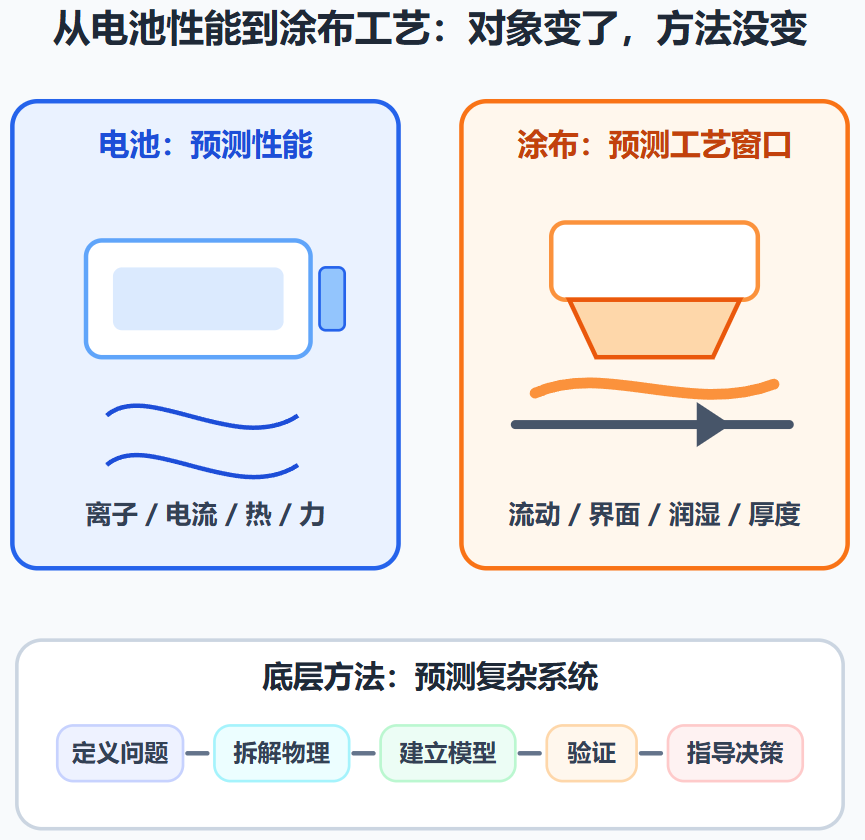
以前我更多关注电芯内部:离子怎么传输,电流怎么分布,热怎么产生和传导,材料怎么膨胀。
而在涂布过程里,我开始关注:涂布液怎么流动,自由液面怎么变化,coating bead 是否稳定,黏度、表面张力、涂布速度和间隙如何影响涂布质量。
也就是说,问题的表现形式变了。
以前我更关心的是:
一个电芯设计出来以后,性能会怎么样?
现在我更关心的是:
一个涂布工艺参数组合下,过程是否稳定,结果是否可控?
表面上看,前者像是产品性能预测,后者像是工艺过程预测。但往深一层看,它们都在回答同一类问题:
在真实制造或大量实验之前,能不能用物理、数学和计算方法,提 前预测一个复杂系统的行为?
刚开始做涂布过程仿真时,也会遇到很多新问题:Fluent VOF 怎么设置,mesh 怎么画,time step 怎么选,surface tension 和 contact angle 怎么设,自由液面为什么不稳定。
如果从软件角度看,这些问题很碎。但如果从问题角度看,主线很清楚:
我真正想解决的,不是“怎么把 Fluent 学会”,而是如何预测涂布过程是否稳定,如何找到稳定的 process window,如何减少大量实验试错。
我需要学 CFD,是因为涂布过程涉及流体流动;需要学 VOF,是因为自由液面很关键;需要理解表面张力、接触角和 capillary number,是因为它们会影响 coating window;可能还需要 DOE 或 surrogate model,是因为单靠 CFD 扫参数成本太高。
这时,Fluent、网格、VOF 都变成了手段。
真正的问题是:
在不用大量实验的情况下,怎样更快找到稳定的涂布工艺窗口?
电池里,我是在预测离子、电流、热、力如何演化。涂布里,我是在预测流体、界面、润湿、厚度如何演化。
研究对象变了,模拟的过程变了,但底层方法没有变。
还是同一条路线:
未知工程问题
↓
拆成物理问题
↓
建立数学模型
↓
计算与验证
↓
指导设计或工艺调整
所以我想跟年轻仿真工程师分享的一点是:不要只看自己现在用哪个软件、做哪个模块、模拟哪种对象。更重要的是,你有没有在积累同一种底层能力:预测复杂工程系统,并减少试错。
四、真正可迁移的是解决问题的闭环
很多年轻工程师会担心:我之前做电池,现在做涂布过程仿真,是不是一切都要重学?我以前做结构,现在做 CFD,是不是之前积累都没用了?我做传统 CAE,现在接触 AI simulation,是不是从零开始?
我的体会是:不一定。
如果你过去只是记住了一些软件操作,那换一个问题确实会痛苦。因为新软件界面、模块、设置和术语都不同。
但如果你过去完整经历过一个复杂问题的解决过程,很多底层能力是可以迁移的。
比如你已经习惯先问:主导物理机制是什么?边界条件是什么?材料参数从哪里来?哪些假设可以接受?如何验证模型?结果怎样转化成设计建议?
这些问题在不同类型的工程问题里都会出现。
具体知识会变,但提问方式、拆解方式和验证意识是通用的。
所以,如果要把我这些年的体会压缩成一句话,我会说:
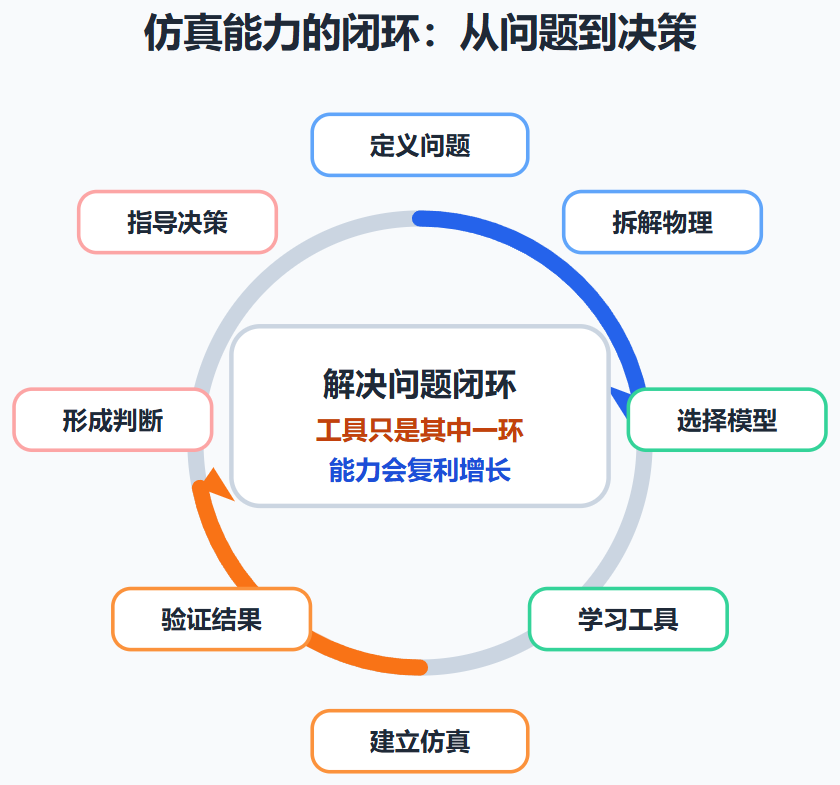
真正可迁移的,不是你学过多少软件,而是你有没有完整经历过“定义问题 → 学习工具 → 建立模型 → 解决问题”的闭环。
这个闭环大概是:
定义问题
↓
拆解物理机制
↓
选择合适模型
↓
学习必要工具
↓
建立仿真
↓
验证结果
↓
形成工程判断
↓
指导下一步设计、实验或工艺调整
这个闭环走得越完整,你的能力越扎实。
如果你只学软件,但没有走完闭环,你可能会停留在执行层。别人给你几何,你会建模;别人告诉你边界条件,你会设置;别人让你出报告,你会画云图。
但当问题变得模糊时,你就会不知道怎么下手。
相反,如果你完整走过一个闭环,即使换一个软件、换一种模拟对象、换一类工程问题,你也知道该怎么开始。
这时候,软件只是你手里的工具。工具换了,你仍然知道要往哪里走。
五、给年轻仿真工程师的几个问题
如果你正在学习 CAE,或者正在从一个方向转到另一个方向,我建议你先不要急着问:
我到底要不要把某个软件学完?
可以先问自己几个问题:
第一,我现在最想解决的工程问题是什么?是结构强度、热管理、电池性能、涂布稳定性,还是 process window?
第二,这个问题背后的主导物理是什么?是流体、热、力、电化学、界面,还是多物理场耦合?
第三,为了解决它,我现在最缺哪块知识?是 governing equation、边界条件、材料参数、网格、求解器、实验验证,还是数据分析?
第四,哪个工具最适合当前阶段?可能是 Fluent,可能是 COMSOL,可能是 Abaqus,可能是 Python,也可能根本不需要复杂仿真,先做 an alytical scaling 或 DOE 就够了。
第五,解决完这个问题后,我能沉淀什么方法?比如如何判断模型复杂度,如何做网格无关性检查,如何验证仿真趋势,如何把仿真结果转化为实验建议。
这些沉淀,才会成为你的长期资产。
六、结语:先找到问题,工具自然会排队
CAE 的世界会越来越复杂。软件会越来越多,AI 工具会越来越强,自动化程度会越来越高。
如果一直用技能清单定义自己,人会越来越焦虑。因为清单永远补不完。
但如果你用问题定义自己,情况就会不同。
你不再只是:
我会 Fluent。
我会 COMSOL。
我会 Abaqus。
我会 Python。
而是:
我能把一个复杂工程问题拆成物理问题,选择合适工具建立模型,通过验证判断结果可信度,并帮助团队减少试错、优化设计。
这个定义更长期,也更稳定。
工具会变,软件会换,AI 会自动化很多步骤。
但工程世界始终需要有人回答:这个系统会怎样表现?风险在哪里?哪个方案更可能成功?怎样用更少实验、更低成本、更快速度接近正确答案?
这才是仿真工程师真正的价值。
所以,我给年轻仿真工程师的建议是:
不要一上来就问:我应该先学什么软件?
先问:我到底想解决什么问题?
当问题足够清楚,下一步该学什么,往往也就清楚了。