
5张图搞懂所有神经网络
上一期介绍了AI+CAE的几个基本概念之后,不禁又产生了疑问。究竟PINN和现在常说的神经网络有什么关系呢?总是听说卷积神经网络,DNN,GNN等专业名词,那到底他们具体是什么,有什么区别,在CAE领域,又有着哪些应用呢?今天依旧让AI小助手和实习生小王一起帮忙写了这篇文章,先对常用的神经网络做一下总结,建立起基本概念~
先把结论撂这儿:常用的神经网络,就5种基本架构——DNN、CNN、RNN、GNN、Transformer。搞懂这5个,神经网络世界的骨架你就拎清了。
但动手之前,得先纠正一个特别常见的误会。
一个容易搞混的区分:架构,还是训练方式?
很多人把上篇讲的PINN当成了"第六种网络"。其实不是。这里有两个层面的东西,得先拆开:
打个不太严谨的比方:架构是"房子盖成什么样"(平房还是小楼),PINN是"装修要不要按抗震规范来"。同一栋房子,可以装修也可以不装修——所以DNN能加PINN变成DNN-PINN,CNN也能加。PINN管的是"怎么训练",不是"网络长什么样"。把这层拆开,我们就专心看5种架构。
先用一张表认个脸熟
具体使用什么样的神经网络架构,和具体的数据形式有关,上面的表尝试做了一个简单的总结,下面我们结合动图,进一步理解。
1. DNN —— 万金油
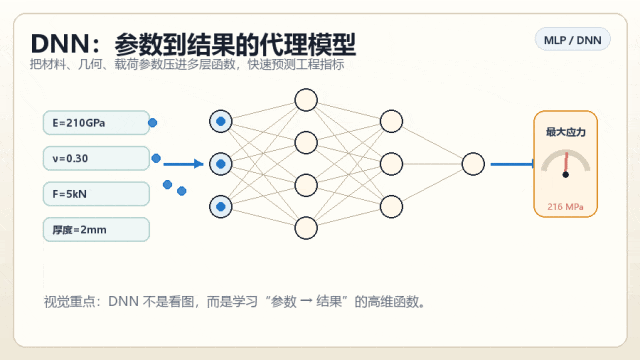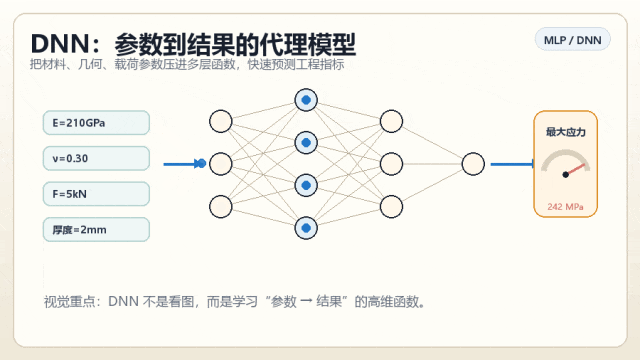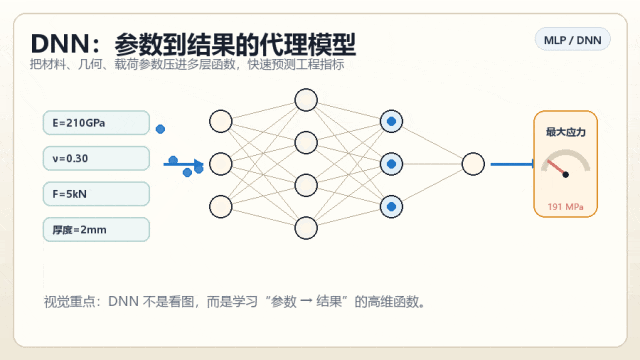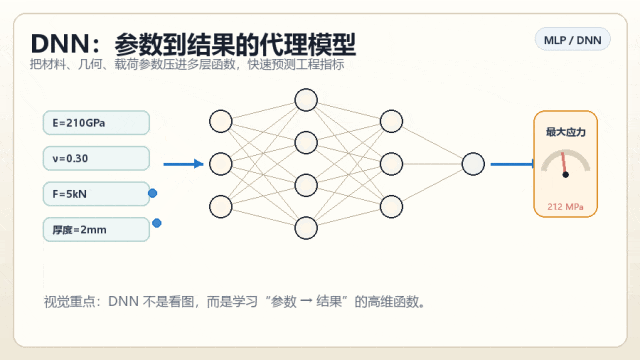
DNN:参数进、预测出的全连接代理模型
学名叫深度神经网络,也常被叫成多层感知机(MLP)、全连接网络。
顺嘴说一句:严格讲,"深度神经网络"其实是个统称,后面要聊的CNN、RNN也都算深度神经网络。只是工程圈习惯把最基础的那种全连接结构叫"DNN",方便跟另外四种并排着说,本文也随大流。
它干的活很直白:你给一组参数(例如:材料弹性模量、泊松比、载荷大小),它吐一个结果(比如屈服强度)。与浅层神经网络对比,深度神经网络中间有多个隐藏层,每层神经元两两全连着——"深度"和"全连接"就是这么来的。通俗点,像条流水线:原料进来,每道工序提一点特征往下传,最后出成品,100层就是100道工序。
CAE里它可以被用于代理模型。例如,拿100组仿真数据(参数→最大应力)喂一个DNN,之后来个新参数它秒出预测,不用再吭哧吭哧跑一遍Abaqus。结构件轻量化时尤其香:上千个壁厚、筋位的组合,挨个跑仿真要一周,用DNN代理筛一遍,几分钟就圈出可行域。当然,在实际应用中,有时候仿真模型千差万别,很难有足够的数据用于DNN模型训练,因此,在实际仿真工作中应用代理模型,关键还是需要找到适用的情形。
“
一句话:DNN不挑食,给它参数它就敢预测。
2. CNN —— 看图高手
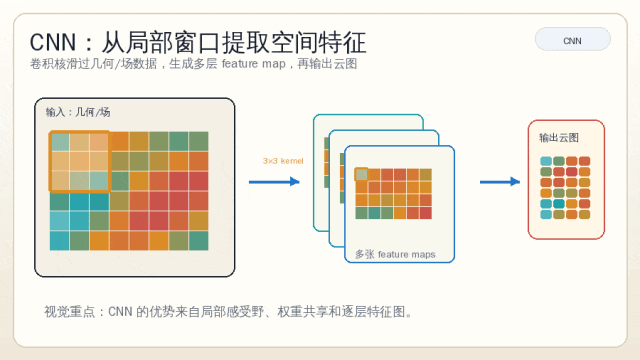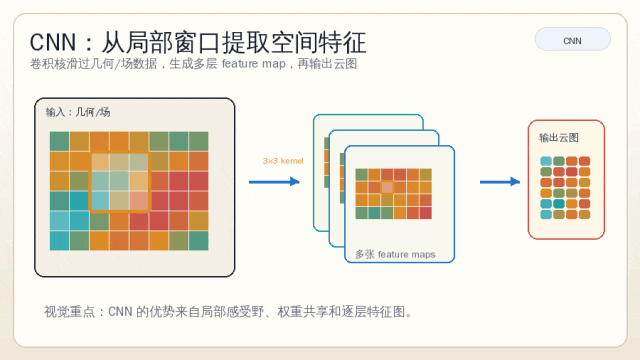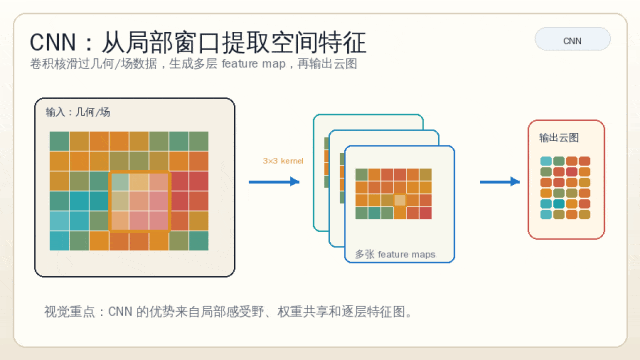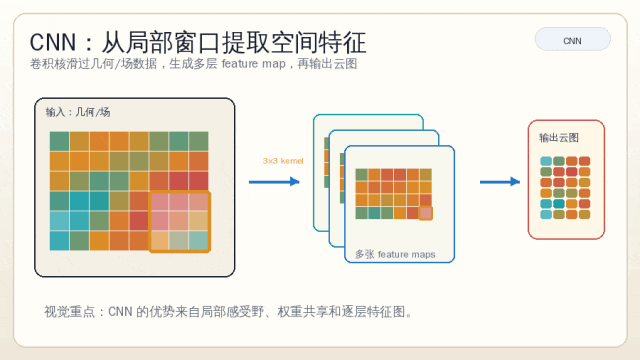
CNN:卷积核滑窗提取局部特征
卷积神经网络(Convolutional Neural Network)。LeCun早在1989年就用它识别手写邮编,算是奠基;2012年AlexNet在ImageNet大赛上一鸣惊人,深度学习这把火才真正烧起来。
它专攻图像和空间场。DNN会把整张图拉成一长条,空间关系全丢了;CNN不这么干,它拿一个叫卷积核的小窗口在图上滑,一块一块看局部特征——边缘、纹理、形状。有点像扫雷:小窗口逐行扫过去,扫完一遍,哪儿有什么局部规律心里就有数了。
放到CAE里,它能直接把"几何 / 载荷"映射成"应力云图"。2025年MDPI的Energies上就有篇文章,拿CNN给核燃料棒做代理模型,单次有限元分析从几秒压到秒级——推理的时候连网格都不用划,喂张几何图,应力分布就出来了。
“
一句话:CNN把"看云图"这件事,从"算出来"变成了"认出来"。
3. RNN —— 时间旅行者
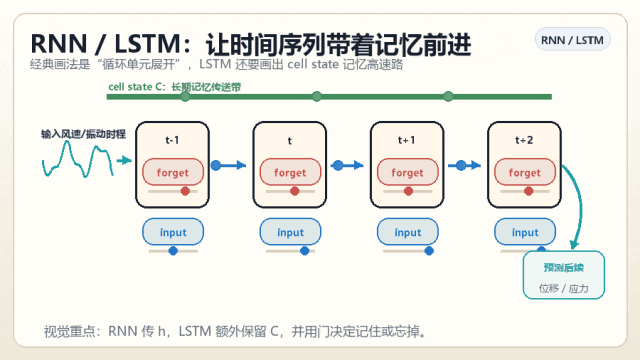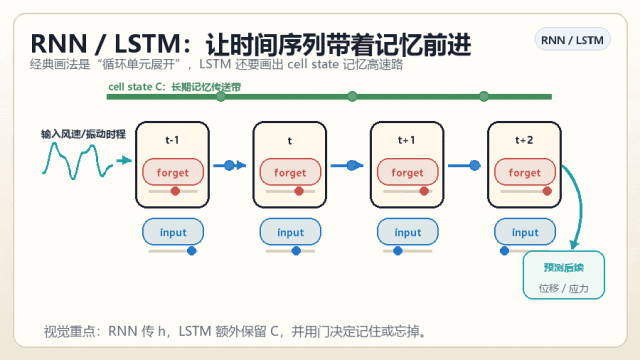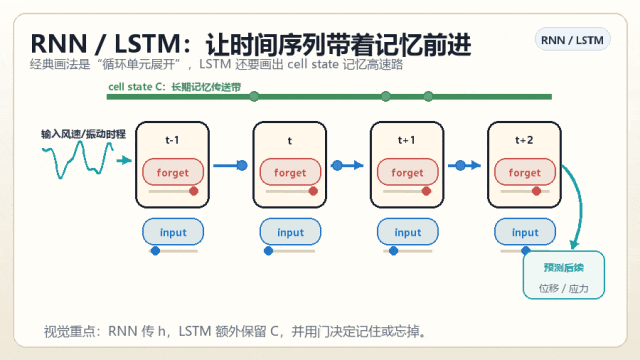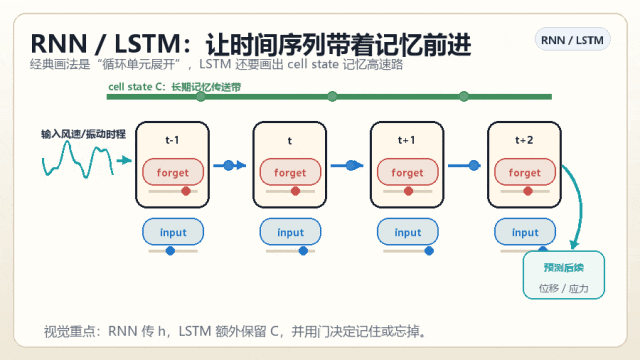
RNN:隐藏状态绕回来,给网络一段记忆
循环神经网络(Recurrent Neural Network)。 它最重要的两个变体你大概率听过:LSTM(长短期记忆,Hochreiter 和 Schmidhuber 1997 年提出)和 GRU(门控循环单元,Cho 等人 2014 年提出)。这俩都是来解决原始 RNN"记不住太久以前的事"(也就是梯度消失/梯度爆炸)这个老毛病的。
它跟前面两种最本质的区别,在"方向"上。DNN、CNN 都是信息一条道往前走,走完拉倒——这叫前馈。RNN 多了一条往回的线:上一步算出来的状态会绕回来,当下一步的输入。这条"反馈回路",就是它"有记忆"的来源。所以它处理的是有先后顺序的东西——时间序列、自然语言、音频。
LSTM 和 GRU 怎么选?LSTM 有三个门(遗忘、输入、输出),记忆管得精细;GRU 只有两个门(重置、更新),结构更简单、参数更少、训得更快。经验上数据多、任务复杂偏 LSTM,数据少、图省事偏 GRU——不过实测下来,俩人水平往往差不多。比喻的话像多米诺骨牌,每块倒的方式受前面所有骨牌的影响,但越远的影响越弱:原始 RNN 是普通骨牌,推远了前头的力量就衰没了;LSTM 学会了"啥时候记、啥时候忘",能把关键信息一路传到底;GRU 是它的轻量版,记性差不多、身板更轻。
在更广为人知的领域,LSTM 同样是时序建模的经典选择。比如语音识别(ASR)——Google 在 2015 年将其手机端语音识别引擎从传统 GMM-HMM 切换到基于 LSTM 的模型后,识别错误率下降了近 49%。它的工作方式很直觉:语音信号本质上就是一段时间序列,LSTM 逐帧"听"进去,同时用记忆门记住前面已经听到的音素和上下文,最终拼出你说的那句话。类似地,在语音合成(TTS)领域,早期的 Tacotron 模型也大量使用 LSTM 来把文本序列映射成语音频谱——这跟 CAE 里"用历史输入推未来输出"的思路本质上是一样的。
CAE 里它是瞬态仿真的好手。比如用 LSTM 预测风载下结构的动力响应——给前几秒的风速时程,它接着往下推位移和应力;地震工程里也很火,输入地震波,多层堆叠的 LSTM(Stacked LSTM)直接吐出结构的非线性时程响应。
“
一句话:别的网络看一张快照,RNN看一整段录像。
4. GNN —— 网格原生玩家
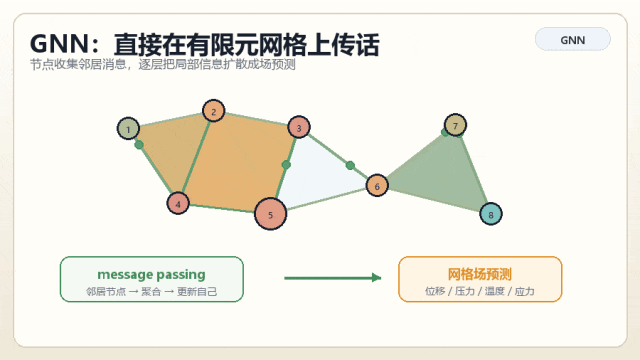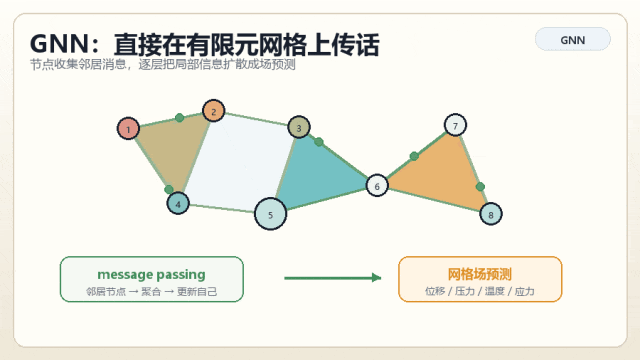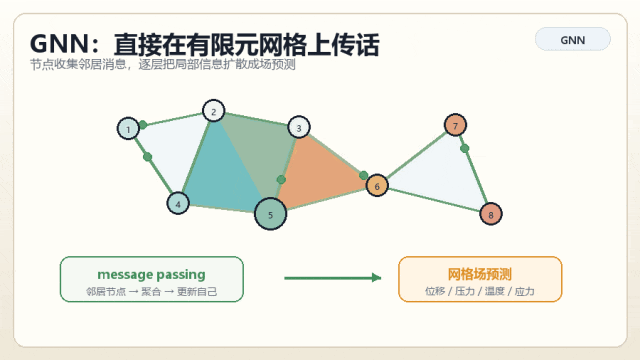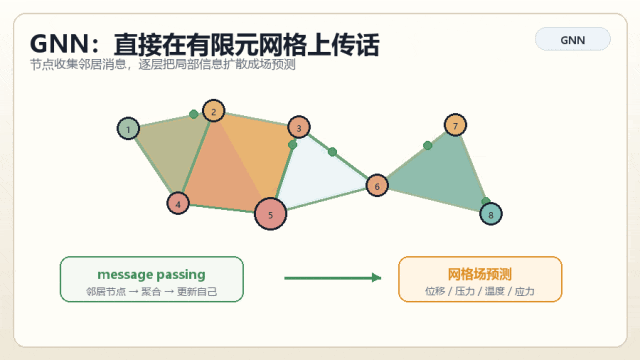
GNN:每个节点听一圈邻居再更新自己
图神经网络(Graph Neural Network)。框架是Scarselli在2009年搭的,这几年GCN、GAT这些变体集中爆发。
它直接在图上推理。图就是节点加边,边代表关系。说到这儿CAE工程师应该一激灵——有限元网格,本身不就是个图吗?每个节点是网格上的一个点(包含物理变量),每条边连着相邻节点。GNN简直是为这种数据量身做的。它干活的方式像传话:每个节点听一圈邻居说的话,综合一下,更新自己。
好处是它直接在网格上预测,不用先把结果画成图片再喂。CNN得走"画成图"这一步,GNN省了。DeepMind的MeshGraphNets就是直接在网格图上预测气动、结构场,是这条路线的标杆;2025年的Multi-Grid GNN更进一步,在三维非结构化网格上预测流场。Altair physicsAI主打的"几何深度学习",底层也有GNN的影子。
“
一句话:CNN得把网格翻译成图片,GNN直接拿网格当母语。
5. Transformer —— 新霸主
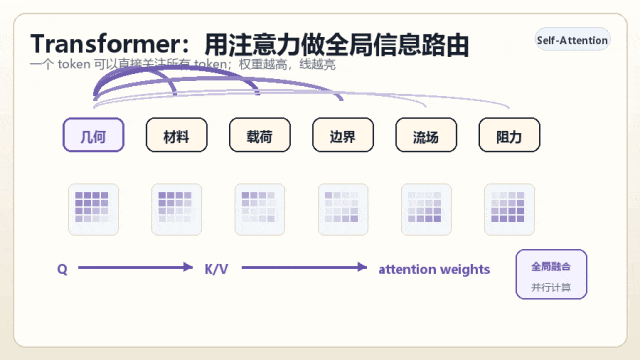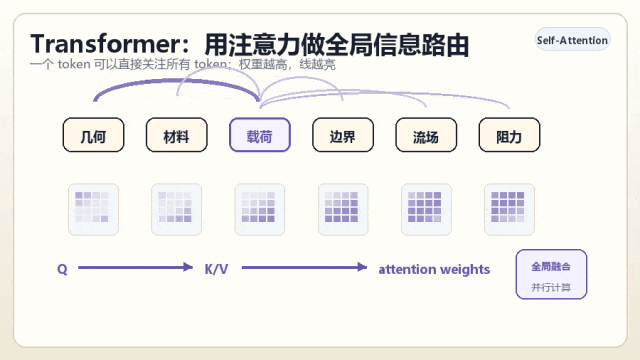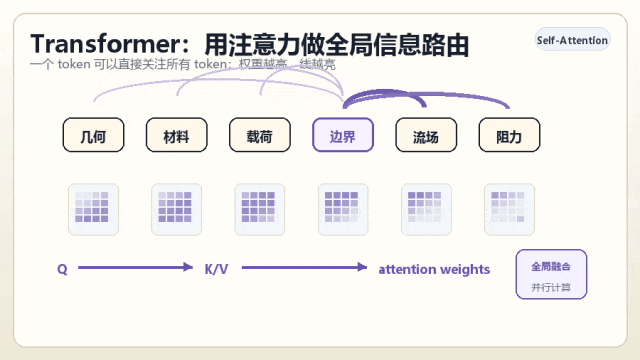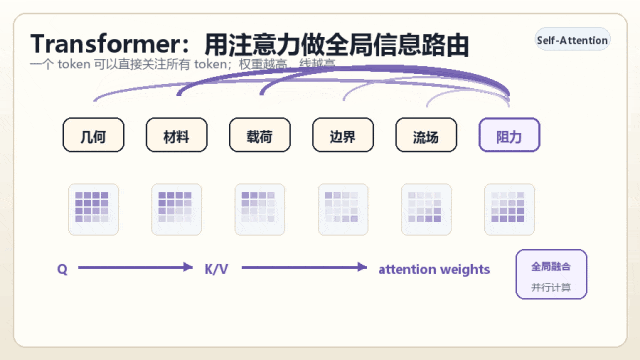
Transformer:自注意力让每个元素直接看到所有元素
Transformer,Vaswani等人2017年提出的。ChatGPT里那个"T"就是它(Generative Pre-trained Transformer)。核心是自注意力机制(Self-Attention)——一句话里每个词,都能直接"看"到所有其他词。
打个比方:RNN像传纸条,一个挨一个传,每人只跟前后两位搭得上话;Transformer像把所有人请到一张圆桌,谁都能直接听见谁发言,自己挑该关注谁。
它进CAE,走的是大模型这条路。Transolver把Transformer搬到工业级几何上做CFD——输入三维车身或翼型,秒出流场;NVIDIA 2025 年发布的 Apollo 物理基础模型,融合了神经算子、Transformer 和扩散模型等多种架构,并注入了领域物理知识。还有Text-to-CAE,让你用大白话跑仿真,底下也是它。
“
一句话:Transformer的本事,是让每个零件都能跟全局对上话。
绕回来:PINN到底站在哪?
到这儿你应该全明白了。
PINN不是第六种架构,它是一种训练方式——在损失函数里塞进物理方程的残差,逼着网络的输出既要拟合数据、又得守物理规矩。最早是Raissi等人2019年系统提出的,当时用的骨干,就是个普普通通的DNN。
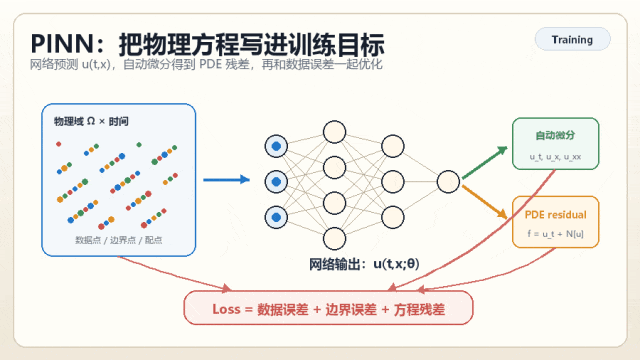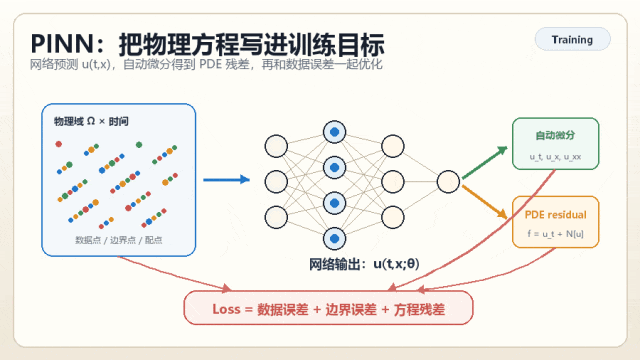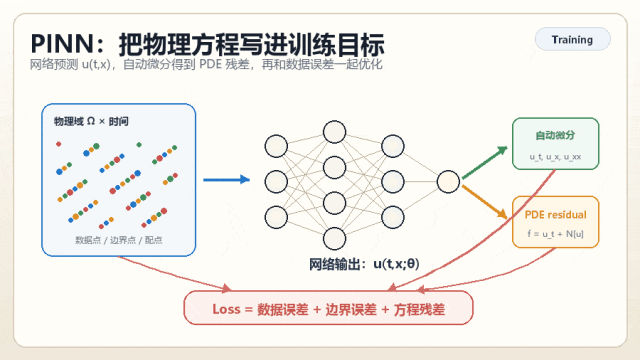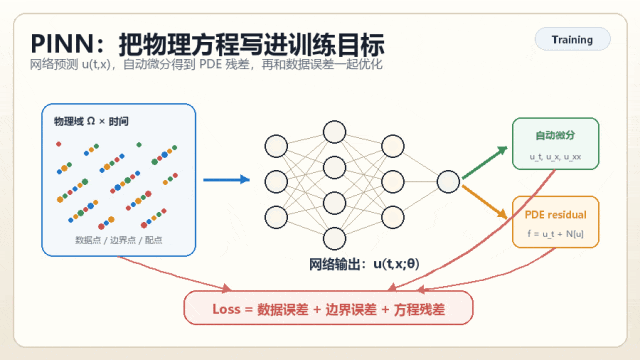
PINN:把物理方程残差塞进损失函数
后来大家发现,数据类型不一样,拿来做PINN的骨架也该换:
说到底就一句:选哪种架构,看你的数据长什么样;要不要加PINN,看你需不需要物理约束。
那到底怎么挑?
一组参数→DNN,图像和场→CNN,时间序列→RNN,网格和图→GNN,要抓全局关系→Transformer。需要守物理规矩,就在上面任意一种上加PINN。
最后留个尾巴:其实还有一大类没讲——生成式模型(GAN、扩散模型、VAE)。它们干的是"无中生有",从噪声里造出新数据,Stable Diffusion、Sora都是这一脉。那是另一个故事,以后单开一篇聊。
参考文献
[1] I. Goodfellow, Y. Bengio, A. Courville, Deep Learning, MIT Press, 2016
[2] Y. LeCun et al., "Backpropagation Applied to Handwritten Zip Code Recognition," Neural Computation, 1989
[3] A. Krizhevsky et al., "ImageNet Classification with Deep CNNs" (AlexNet), NeurIPS, 2012
[4] "AI-Powered CNN Surrogate Modeling for High-Speed FEA in NPPs Fuel Performance," Energies, 2025
[5] S. Hochreiter, J. Schmidhuber, "Long Short-Term Memory," Neural Computation, 1997
[6] K. Cho et al., "Learning Phrase Representations using RNN Encoder-Decoder" (GRU), EMNLP, 2014
[7] F. Scarselli et al., "The Graph Neural Network Model," IEEE TNN, 2009
[8] T. Pfaff et al., "Learning Mesh-Based Simulation with Graph Networks" (MeshGraphNets), ICLR, 2021
[9] "Multi-grid Graph Neural Networks with Self-Attention for Computational Mechanics," Physics of Fluids, 2025
[10] A. Vaswani et al., "Attention Is All You Need," NeurIPS, 2017
[11] H. Wu et al., "Transolver: A Fast Transformer Solver for PDEs on General Geometries," ICML, 2024
[12] M. Raissi et al., "Physics-informed neural networks," J. Computational Physics, 2019
[13] H. Gao et al., "PhyGeoNet: Physics-informed geometry-adaptive CNNs," J. Computational Physics, 2021
[14] H. Gao et al., "Physics-informed graph neural Galerkin networks," CMAME, 2022


