
龙格库塔Pinn方法求解方程,pytorch框架(四)
ODE数值方法的演进路程
已知方程一阶导数公式和初始值,求方程的解
显式欧拉法
从当前点 出发,沿着当前的切线方向走一小步 ,就到达了下一点,该方法简单容易,但是精度较低,数值解容易爆炸。
隐式欧拉
用下一步的斜率来当作当前的切线方向,方程的右端包含待求解的 ,因此称为隐式欧拉,比较稳定,数值解不容易爆炸,但是计算量显著增加。
改进欧拉法
先用显式欧拉法计算一步
然后用两端的斜率均值作为当前切线方向
基于上述计算方法,因此该方法也叫预测-矫正法。精度高,且是显式的计算相对方便。
梯形法则和中点公式
显式龙格库塔方法
在 内取点 个点构成 级RK(龙格库塔)格式(精度阶数和级数并不总是相等),此时
当 的值由 对应点的斜率加权平均得到时,该公式称为显式RK法,当取 时,选取适当点的位置,比较典型的例子就是改进欧拉方法。
半隐式龙格库塔方法
当 的值由 对应点的斜率加权平均得到时,该公式称为半隐式RK法。比较典型的例子就是梯形法则。
隐式龙格库塔方法
当 的值由 对应点的斜率加权平均得到时,该公式称为半隐式RK法。 记导数为 满足
其中 称为待定常数,则
为一个单步的 级Rk方法, 也为常数。 通常情况下,我们通过一个系数表(Butcher tableau)来表示一个RK方法,一般记为如下形式
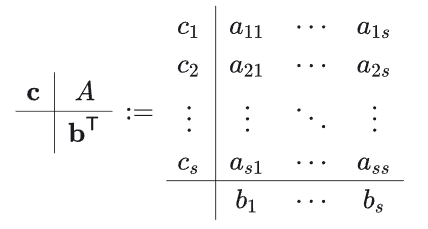
基于系数表,当 为严格下三角是,称该方法为显式的,当 为下三角时称为半隐式,当A不是上述情况时称为隐式。
显式欧拉,隐式欧拉,改进欧拉,梯形公式,中点公式的Butcher tableau如下所示 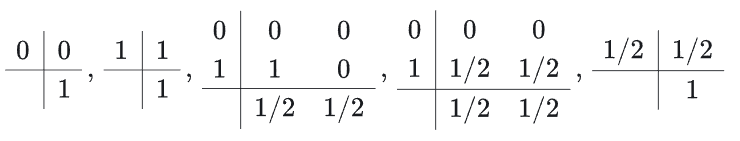
龙格库塔的Pinn方法应用
正问题
将 级龙格库塔方法的一般形式应用如下方程
得到
将公式移项,记作
此时可知
用神经网络预测以下结果
将预测的结果带入到移项后的公式计算得到
即可以对比误差获得损失函数。
    def fwd_gradients(self, U, x, dummy):
        # 第一次求导:U对x
        grad = torch.autograd.grad(U, x,
                                       grad_outputs=dummy,
                                       create_graph=True,
                                       retain_graph=True)[0]

        # 第二次求导:结果对dummy
        dummy_grad = torch.ones_like(grad)
        grad_U_x = torch.autograd.grad(grad, dummy,
                                    grad_outputs=dummy_grad,
                                    create_graph=True,
                                    retain_graph=True)[0]

        return grad_U_x
在具体实践中为了避免多次的反向传播,通常采用哑变量求导的方式,第一次求导获得 ,第二次再对 求导获得 。
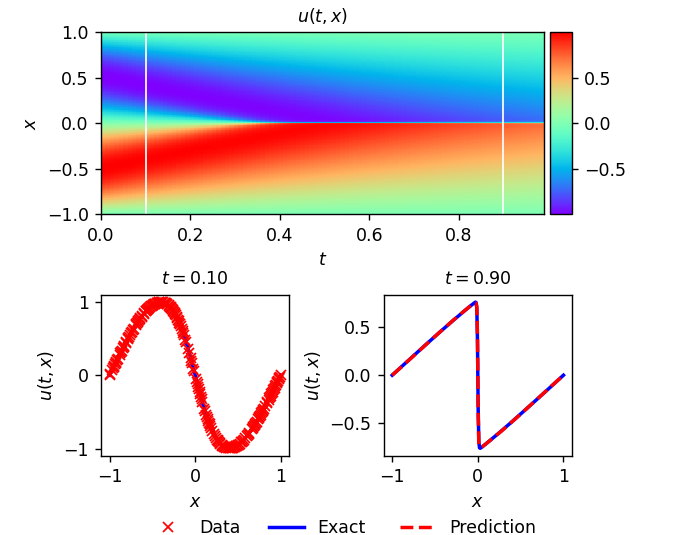
反问题
前面与正问题类似,不同的是将公式移项后,记作
此时
同样的用神经网络预测以下结果
带入移项后的公式获得如下结果
对比精确值,即可获得损失函数。
q = int(np.ceil(0.5 * np.log(np.finfo(float).eps) / np.log(dt)))
这里的公式是 , 代表机器误差,反问题中要使理论误差接近机器误差,由于机器精度的限制,无论使用多高阶的方法,结果精度无法超过机器精度 龙格库塔方法的理论误差为 ,其中 代表预测步长, 代表方法级次,在正问题中采用的方法理论误差远小于机器误差。
登录后免费查看全文
著作权归作者所有,欢迎分享,未经许可,不得转载
首次发布时间:2026-01-08
最近编辑:9月前

博士
签名征集中

还没有评论
相关推荐
最新文章
热门文章
