首页/文章/ 详情

带BGA的高速板,还真是有难度

10月前浏览140
今天给大家分享一下什么是BGA?BGA PCB设计及布线方法。

一、什么是BGA扇出?

在 PCB 布局设计中,特别是BGA(球栅阵列),PCB扇出、焊盘和过孔尤为重要。扇出是从器件焊盘到相邻过孔的走线,如图下图所示。

过孔是 PCB 中各层之间的电气连接,用于连接输入和输出、电源和接地轨道。
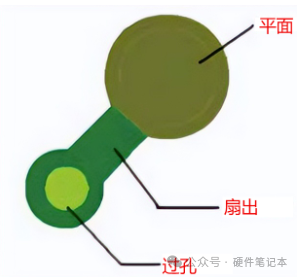
BGA扇出


通常,每个焊盘有一个过孔。PCB 焊盘是设备焊球放置并焊接到的地方。使用细间距 BGA 进行 PCB 设计的重要和困难方面之一是 BGA 焊盘和扇出的布局。
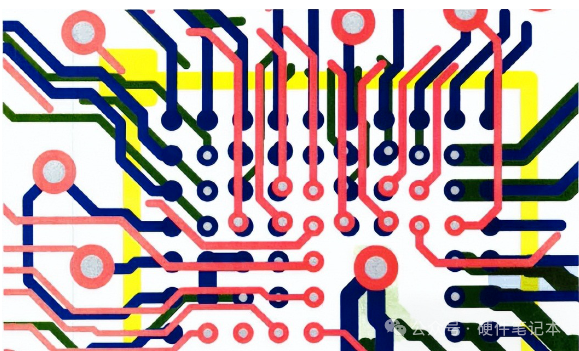
BGA焊盘


二、BGA焊盘和封装

BGA 封装通常围绕插入器构建:一个小型印刷电路板,用作实际芯片和安装它的电路板之间的接口。芯片通过引线键合到中介层并覆盖有保护性环氧树脂。

内插器将信号从芯片边缘路由到底部的焊盘阵列,焊盘上附着小焊球。然后将完成的 BGA 封装放在印刷电路板上并加热,焊球熔化并在电路板和内插器之间建立连接。

下面为:典型BGA 封装的内部结构
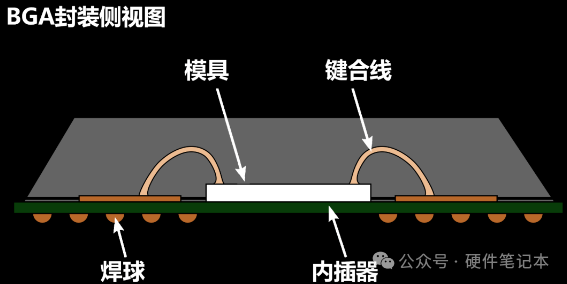
典型 BGA 封装的内部结构(侧视图)

不同的 BGA 类型:经典 BGA(272 引脚,1.27 毫米间距)、芯片级封装(49 引脚,0.65 毫米间距)和晶圆级芯片级封装(20 引脚,0.4 毫米间距)。

不同 BGA 类型封装的营销名称种类繁多,基本上没有标准化。
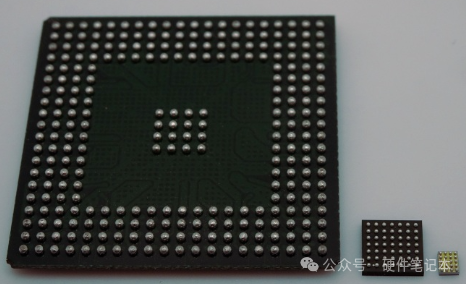
BGA封装


这里举一个例子:CP161 绘制正确的占位面积的。可以在datasheet上找到,有推荐的焊盘图案,指定NSMD型焊盘的焊盘直径为0.15 毫米。
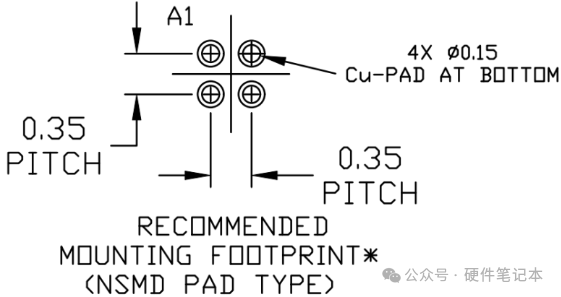
NCP161 的 PCB 封装,如数据表中所建议


NSMD 指的是未被阻焊层部分覆盖的焊盘。另一种选择是阻焊层定义的焊盘,其中阻焊层确实覆盖了部分焊盘。虽然这两种类型都有其应用,

但制造商的 BGA 芯片数据表中通常推荐使用 NSMD 类型,因为它可以提供更稳固的焊接连接,焊球可以抓住焊盘的侧面和顶部。

下面为:阻焊层定义(左)和非阻焊层定义的 BGA 焊盘(右)的区别
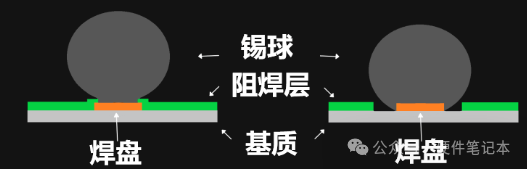
阻焊层定义(左)和非阻焊层定义的 BGA 焊盘(右)的区别
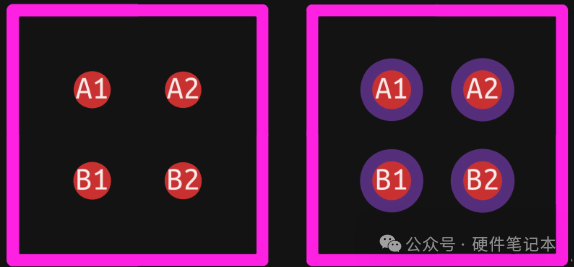
带有阻焊层定义焊盘(左)和非阻焊层定义焊盘(右)的四引脚 BGA 封装


三、BGA PCB设计

对于 NSMD 版本,阻焊层开口应略大于铜焊盘;在这种情况下,我们在 0.15 毫米焊盘上使用了 0.25 毫米开口,这意味着阻焊层开口在焊盘两侧仅延伸 0.05 毫米。这个时候应该与PCB制造商核实阻焊层对准是否能按照这个标准执行。

典型值为 2 密耳(0.05 毫米),这意味着在最坏的情况下,阻焊层将刚好接触到焊盘的边缘,如果制造商无法提供更精确的对准,可能需要稍微扩大焊盘开口。但焊盘之间剩余的阻焊仍应满足最小焊层条规则。

BGA焊盘编号不是按顺序编号,而是按行-列格式编号,行从上到下依次标记为 A、B、C 等,而列从左到右编号。左上角的引脚 A1 通常由芯片顶部的一些标记指示,可以正确定位部件。

当你组装PCB时,特别是手动组装,就是在丝印层上标明封装轮廓。由于在放置芯片时看不到焊球和焊盘,因此丝印是判断芯片是否正确放置的唯一方法,记得要画一些指示器来指出哪个引脚是A1。

下面为:四引脚 BGA 封装的完整 PCB 封装。
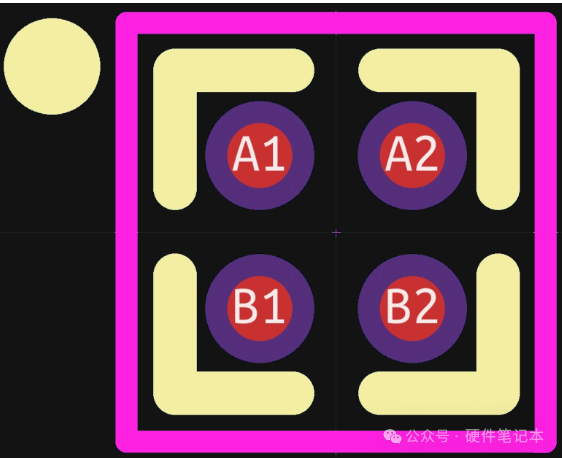
四引脚 BGA 封装的完整 PCB 封装

只需四个焊盘,就可以轻松地将稳压器芯片连接到电路的其余部分。虽然为输入、输出和接地连接绘制几个大电源层并将它们与焊盘重叠可能看起来很好,但通常最好先在每个焊盘上绘制一条细迹线,然后将该迹线连接到任何更大的结构。

其原因是可焊性,当焊球熔化时,就可能会黏附到铜上,也就是说焊盘与之相连接的走线。因此,芯片在焊接过程中会在走线方向受到轻微拉力。使连接径向对称应该抵消每个焊球施加的力并确保更可预测的焊接过程。
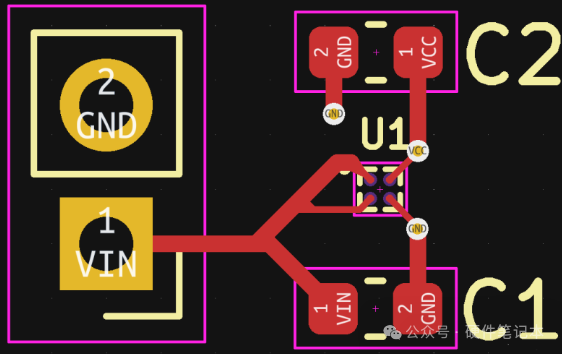
DO 的完整布局,以及周围的组件

VCC 和 GND 都下降到内层的电源层。请注意,即使与 0603 大小的电容相比,该芯片也非常小。


四、BGA间距及其对扇出的影响
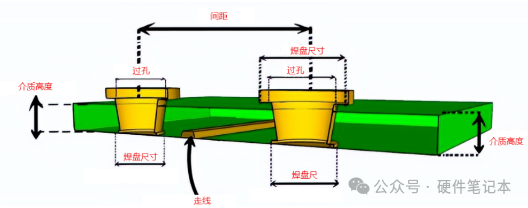
BGA间距

BGA间距:定义为从中心到中心测量的两个相邻焊球之间的距离。随着引脚数量的增加,元件的间距会减小。这种间距的减小使扇出变得复杂。因此,应该添加更多的内部层来布线引脚,这反过来又会增加PCB 制造的成本。

由于这些原因,决定所需的层数是一个比较困难的工作。有一个经验公式可以用来决定层数:

层数=BGA芯片信号总数/(4面x每面BGA走线信号)

下面为:通过BGA引脚布线图
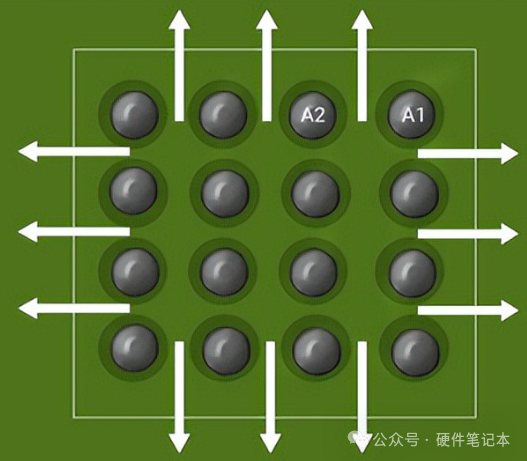
通过BGA引脚布线


五、BGA布线:狗骨式布局

当我们放置带有 7×7 焊接网格的微控制器时,就更加困难了。将走线布线到所有 49 个焊盘并不是那么简单,先从最简单的部分开始:外部引脚,可以使用水平和垂直走线简单地将它们向外布线。
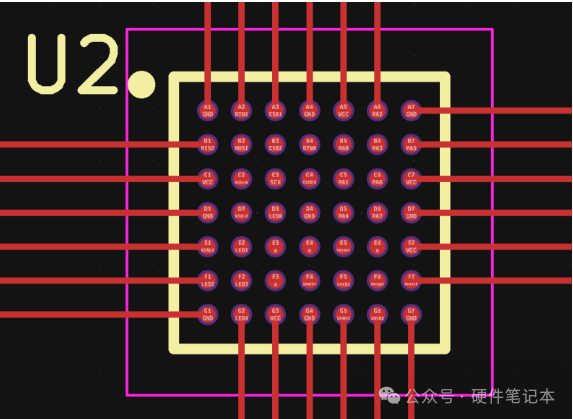
BGA布线:狗骨式布局

第二层引脚可以通过外焊盘之间的轨道进行布线。遵守PCB 设计规则:

最小走线宽度和间隙不应超过 c = (pd)/3,其中 p 是焊盘间距,d 是焊盘直径。

对于此示例,间距为 0.65 毫米,直径为 0.35 毫米,最小间隙和轨道宽度降至 0.1 毫米,比较紧凑,有一些制造商是这样的。
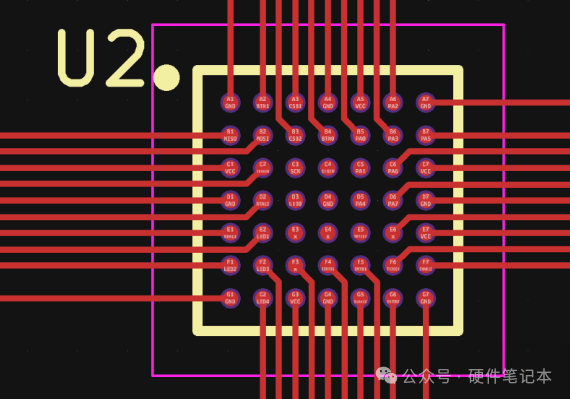
BGA布线:狗骨式布局

第三层向内,通过过孔来输出信号。最常见的做法是在每四个焊盘的中间放置一个过孔,并从其中一个焊盘向其布线对角线迹线。

这里要确保有足够的空间来放置过孔。如果焊盘间距为p,那么两个焊盘中心点之间的对角线距离为p√2。焊盘内边缘之间的距离为 p√2 – d,其中 d 是焊盘直径。
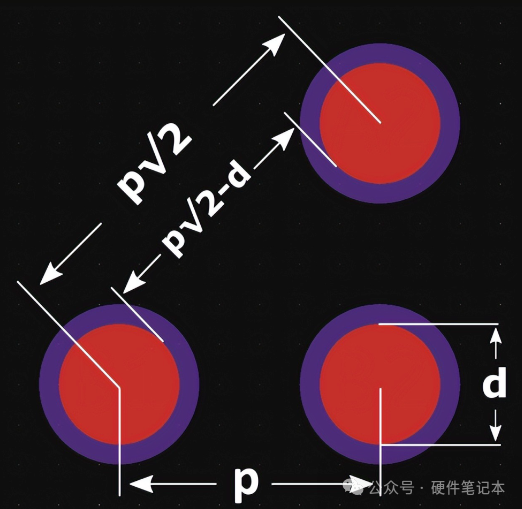
焊盘间距

对于 ATmega164,p = 0.65 mm 和 d = 0.35 mm,这意味着焊盘之间有 0.57 mm 的空间。我们需要在焊盘和通孔之间留出至少 0.1 毫米的间隙,通过将通孔稍微靠近它所连接的焊盘来获得一点空隙。

放置过孔后,我们最终得到如下所示的布局。这是dog-bone 布局样式有点像卡通骨头。在这个简单的例子中,我们只有九个狗骨和足够的空间来路由底层的信号。如果我们有一个 8×8 的球包,那么我们就会有 16 个狗骨头,底层会和顶层一样拥挤。
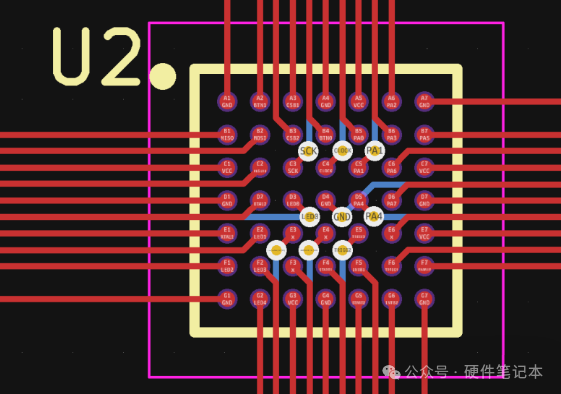
BGA布线:狗骨式布局

狗骨布局样式可以扩展到任何 BGA 尺寸。但随着焊盘数量的增加,路由所有信号所需的层数也会增加。7×7 或 8×8 BGA 只需两个信号层即可布线,但 9×9 或 10×10 芯片至少需要三个。一般来说,每增加两排焊盘就需要一个新的布线层。实际上,许多信号将是电源和接地引脚,可以直接连接到内部电源层,不需要进一步布线。可能还有未使用的引脚,这提供了更多的布线空间。

重要的是要确保 BGA 芯片下的所有过孔都被遮盖或覆盖在阻焊层中。如果不是,那么熔化的焊球可能会流到通孔和预期的焊盘上,导致未对准和短路。这里必须要与制造沟通,是否支持帐篷过孔。


六、BGA布线:盘中孔布局

BGA 布线的另一种布局方式是盘中孔。这通常用于无法在四个焊盘之间安装过孔的极细间距 BGA。

基本思路很简单:在每个内部焊盘内部放置一个过孔,并将信号从下层向外布线。

这里的问题是不能简单地将普通过孔放置在BGA焊盘中,因为融化的焊料会通过毛细管作用被吸入过孔内,导致连接不可靠。因此需要填充通孔并在顶部涂上金属覆盖物,确保平坦、可焊接的表面。官方术语是 IPC-4761 类型 VII,填充和封盖孔。

通孔需要足够小以适合 BGA 焊盘内部,并且通常最终会成为微孔,用激光钻孔。还可以通过使用盲孔来简化布线,盲孔不会一直穿过电路板,而是你想让它停留在哪就停留在哪一层。

不过盲孔一般比较贵,如果你的设计使用最小的VII 型微孔和最紧密的间隙。

下面是一个示例布局,显示了应用于 TDC7201 的焊盘内通孔技术,虽然我们通常不需要在这样一个简单的 25 引脚设备上使用这个技术,不过这只是一个案例。
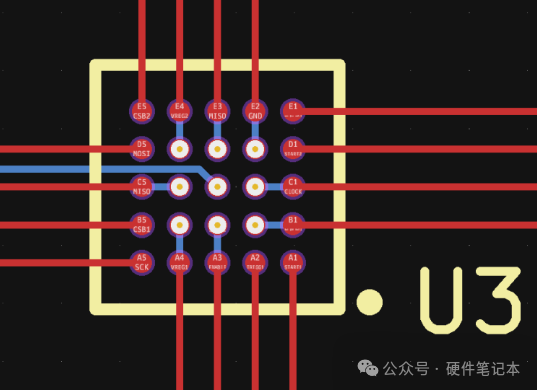
应用于 TDC7201 的焊盘内通孔技术


七、案例介绍:BGA布线中的焊盘中的过孔

1、BGA布线中盘中孔
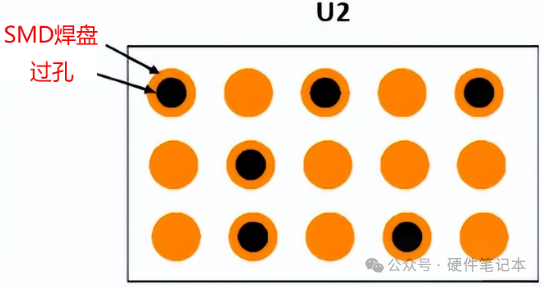
盘中孔

盘中孔有助于布线细间距 BCA 组件,在组件铜平台中放置过孔称为焊盘中过孔。这种技术提供了更多空间来布线而不会出现设计规则检查(DRC)错误在 BGA 扇出中,过孔以一定角度放置在焊盘中以最大化空间。大多数情况下使用偏移焊盘。


2、BGA布线使用偏置焊盘

下面是放置在焊盘边界附近的盘中孔。
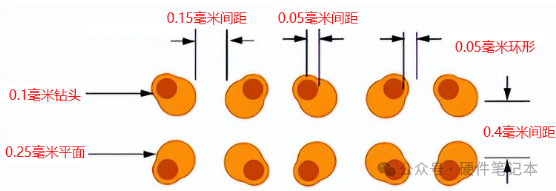
BGA布线使用偏置焊盘


3、位于中心的焊盘
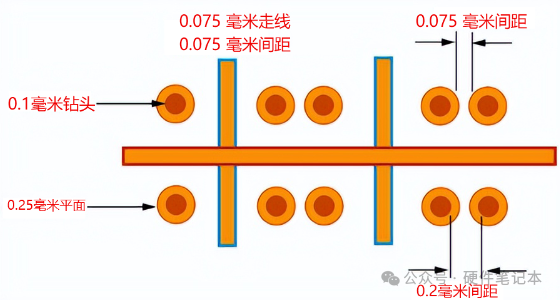
位于中心的焊盘

与焊盘中心的微孔相比,使用偏移孔增加了可用于布线的空间,如上图所示引脚之间的路由走线可以不同方式通过紧密间隔的引脚进行布线。  
 

声明:


声明:文章整理于网络。本号对所有原创、转载文章的陈述与观点均保持中立,推送文章仅供读者学习和交流。文章、图片等版权归原作者享有,如有侵权,联系删除。    


来源:硬件笔记本
电源电路电子芯片焊接控制电气
著作权归作者所有,欢迎分享,未经许可,不得转载
首次发布时间:2025-11-26
最近编辑:10月前
硬件笔记本
本科 一点一滴,厚积薄发。
获赞 159粉丝 54文章 1128课程 0
点赞
收藏
作者推荐

有点意思!不用菜单点菜?让AI来猜猜你吃的是啥

❝ 不用菜单点菜,拍个照,AI就能告诉你菜名——这听起来有点像科幻电影里的场景?但现在,我们手头一台巴掌大的边缘计算盒子就能做到。这一切是怎么实现的?靠的就是它肚子里那颗名为RK3576的强力芯片。这家伙自带独立的NPU(神经网络处理单元),相当于给设备装了一个专为AI设计的“大脑”,让它不用依赖云端,自己就能在本地飞快地完成识别任务。本文将分享我们如何在一台米尔MYD-LR3576边缘计算盒子上,从零开始部署这套菜品识别应用的真实过程。看完你就会明白,强大的AI能力,是如何被浓缩在这个小盒子里的。实机演示本地部署,实时推理。在这段实机视频中,MYD-LR3576正同步运行YOLOv11s(目标检测)与PPLCNetV2(特征提取)模型。其性能核心在于:两个模型的NPU推理时间均被压缩至惊人的20ms/帧,为高性能边缘AI应用提供了坚实底座。❝ 本文以米尔电子的MYD-LR3576边缘计算盒子为例,讲解如何在Android平台部署yolo11s、PPLCNETV2模型实现实时菜品识别。为开发者与研究者提供一份兼具实践参考与技术洞察的模型端到端的部署指南。 1. 基本介绍1.1 边缘计算盒米尔MYD-LR3576-B边缘计算盒是一款基于瑞芯微RK3576处理器设计的高性能嵌入式AI设备。 该处理器集成八核CPU架构(4×Cortex-A72 + 4×Cortex-A53)与算力达6 TOPS的NPU(2核心),具备强大的边缘端AI推理能力。 产品标配8GB LPDDR4X内存与64GB eMMC存储,支持双千兆网口、WiFi 6、多路USB 3.0及4K显示输出,提供完整的Debian/Linux软件开发环境。 凭借其高性能NPU与丰富接口,该设备可高效支撑计算机视觉、智能分析等边缘AI场景,为菜品识别、工业质检等应用提供稳定可靠的硬件平台。1.2 RKNN-Toolkit2 SDK要将YOLOv11s、PPLCNetV2等主流AI模型高效地部署在MYD-LR3576-B这样的边缘设备上,并充分发挥其NPU的算力,离不开一个关键的软件工具链——RKNN-Toolkit2。这是由瑞芯微官方提供的核心SDK,专为其RK系列芯片的NPU(神经网络处理单元)设计。GitHub仓库: https://github.com/airockchip/rknn-toolkit21.2.1 RKNN-Toolkit2 是什么?RKNN-Toolkit2是一个功能完整的模型转换、推理和性能评估工具包。它的核心作用在于充当一个“翻译官”和“优化器”,将开发者们在主流深度学习框架(如PyTorch, TensorFlow, ONNX等)上训练好的模型,转换成可以在瑞芯微NPU上高效运行的专用格式——RKNN模型。1.2.2 核心功能与工作流程该工具链为AI模型在边缘端的部署提供了全流程支持:1. 模型转换支持多框架输入: 可直接加载PyTorch(.pt)、TensorFlow(.pb)、ONNX(.onnx)等格式的模型。量化优化: 支持将FP32模型量化为INT8或INT16精度,在保证精度的同时,大幅减小模型体积、提升推理速度、降低功耗。这正是实现20ms超快推理的关键步骤之一。模型优化: 工具会自动对模型图结构进行编译和优化,使其适配RKNPU的硬件架构,提取最大性能。2. 仿真推理与精度分析在模型部署到物理设备(如MYD-LR3576-B)之前,可以在PC上进行仿真推理,验证模型转换后的正确性和精度,极大方便了前期的调试工作。3. 性能评估提供模型性能分析工具,可以评估模型在NPU上的理论推理时间和内存占用,帮助开发者进行模型选型和优化。4. 跨平台部署支持除了Python环境下的开发工具,RKNN-Toolkit2还提供了C/C++版本的运行时库(RKNN API)。这使得开发者可以轻松地将优化后的RKNN模型集成到最终的生产环境中,无论是Linux、Android还是Debian系统(正如MYD-LR3576-B所搭载的),都能实现高效、低延迟的推理。1.2.3 与MYD-LR3576的完美协同在本文的菜品识别Demo中,正是利用了RKNN-Toolkit2的强大能力:步骤一: 在PC端将预训练好的YOLOv11s(目标检测)和PPLCNetV2(图像分类)模型通过该工具链转换为.rknn格式文件。步骤二: 将转换好的RKNN模型文件与调用RKNN Runtime的应用程序一同部署到MYD-LR3576边缘计算盒上。步骤三: 应用程序通过RKNN Runtime API加载模型,调用NPU执行计算,最终实现了双模型协同、单次推理均仅20ms的卓越性能。总结而言,RKNN-Toolkit2是释放MYD-LR3576-B内部6 TOPS NPU潜力的钥匙。 它大大降低了开发者将AI模型部署到瑞芯微边缘计算平台的技术门槛和开发周期,使得构建像实时菜品识别这样的高性能AI应用变得简单而高效。1.3 RKNN Model ZooRKNN Model Zoo 是一个专为瑞芯微NPU打造的 “模型商店” 或 “开箱即用模型库” 。该项目收集了大量经典的、高性能的深度学习模型,并已经过预转换和调优,直接提供了现成的 RKNN格式模型文件,同时附带了完整的示例代码。Github地址:https://github.com/airockchip/rknn_model_zooRKNN Model Zoo优点:开箱即用的体验: 开发者无需从头开始进行模型训练和复杂的转换调试,可以直接下载所需的RKNN模型文件,利用提供的示例代码在MYD-LR3576等设备上快速运行起来,立即看到效果,极大地缩短了概念验证(PoC)的周期。官方性能保证: 仓库中的模型都提供了详细的性能基准数据,包括在特定RK芯片上的推理速度和精度。这为开发者选型提供了权威参考,确保模型在目标设备上能够达到预期的性能。最佳实践范例: 每个模型都附带完整的C++和Python示例代码,清晰地展示了如何加载RKNN模型、进行数据预处理、执行推理以及解析输出结果。这对于学习如何在自己的应用程序中集成和调用RKNN模型而言,是极具价值的学习资料。2. 搭建环境2.1 刷入Android系统米尔的MYD-LR3576边缘盒子默认是Linux系统,在我们的场景中,需要先刷机为Android系统。2.1.1 获取资料登录米尔开发者中心(https://dev.myir.cn/auth/login.html),在开发者平台注册绑定产品信息,在包装盒侧面会有一个产品型号系列号,可通过微 信扫码绑定。 绑定成功后,依次点击我的产品->软件资料->Android14操作系统: 然后复 制提取码后点击“阿里云盘”字样即可打开米尔提供的所有相关资料文件。如:01-Docs(ZH)/MYD-LR3576-GK Android 软件开发指南-V1.0.pdf02-Images/myir-image-lr3576-android14.zip03-Tools 是我们需要的文件,分别是软件开发指南、安卓系统镜像文件以及工具,下载上述文件。2.1.2 镜像烧录在软件开发指南中的第四章有详细的镜像编译步骤,开发者可以根据情况自行编译镜像,方便进行自定义。本文直接使用了资料中已经编译好的Android镜像进行烧录。1. 安装驱动驱动安装工具压缩包位于 03-Tools/DriverAssitant 目录下,解压运行 DriverAssitant工具,出现以下界面,首先点击卸载驱动,然后点击驱动安装: 2. 烧录镜像到EMMCRKDevTool是瑞芯微提供的适用于 RK 系列芯片的 windows 下的便捷开发工具,为开发人员提供了固件烧录/镜像烧录|设备擦除|设备切换/固件解包等功能。首先登陆边缘盒子,使用Type-C线将边缘盒子的DEBUG(电源接口旁写着Type-C字样)口连接到windows电脑;然后打开设备管理器,配置COM口参数:波特率:115200数据位:8停止位:1校验位:无流控:无打开串口终端软件填入上述参数,然后给盒子上电,即可进入系统;进入系统后在终端输入reboot loader即可进入loader模式;打开工具文件夹下的RKDevTool(没有解压请解压),双击RKDevTool.exe,会看到提示:发现一个LOADER设备;此时点击升级固件->固件,选择刚刚下载的Android镜像文件(刚下载的为zip文件,解压出里面的镜像文件),然后点击升级按钮并等待完成: 此时已经完成Android系统的烧录。2.2 准备RKNN-Toolkit2环境❝ 注意:这里的操作是在另外一台电脑上操作,并且已经配置了python环境或Conda环境。为模型转换、量化以及测试提供基础环境。1. 可以直接通过网络安装:pip install rknn-toolkit2 -i https://pypi.org/simple# 如果已安装 RKNN-Toolkit2,可通过以下命令升级 RKNN-Toolkit2pip install rknn-toolkit2 -i https://pypi.org/simple --upgrade 2. 通过本地 wheel 包安装首先克隆RKNN-Toolkit2项目文件:git clone https://github.com/airockchip/rknn-toolkit2.git -d 1 或者手动下载下面涉及到的文件。然后进入项目根目录后:# 请根据不同的 python 版本及处理器架构,选择不同的 requirements 文件:# 其中 cpxx 是 python 版本号pip install -r packages/arm64/arm64_requirements_cpxx.txt# 安装 RKNN-Toolkit2# 请根据不同的 python 版本及处理器架构,选择不同的 wheel 安装包文件:# 其中 x.x.x 是 RKNN-Toolkit2 版本号,cpxx 是 python 版本号pip install packages/arm64/rknn_toolkit2-2.3.2-cp310-cp310-manylinux_2_17_aarch64.manylinux2014_aarch64.whl 3. 模型转换rknn_model_zoo中包含了很多官方已经适配的模型,包括模型训练以及模型转换脚本。3.1 yolo11模型转换rknn_model_zoo中已经包含了yolo全系列模型,因此yolo11模型的转换非常简单,我们直接将训练好的模型(通常是.pt格式)先转为onnx格式。该转换过程通常建议在与训练模型相同的环境中进行,如何进行yolo11的模型训练不是本文重点,可参考: https://github.com/airockchip/ultralytics_yolo11 进行训练。 转换命令:# 调整 ./ultralytics/cfg/default.yaml 中 model 文件路径,默认为 yolo11n.pt# 在 ultralytics_yolo11 的项目根目录执行export PYTHONPATH=./python ./ultralytics/engine/exporter.py 执行完毕后,会生成 ONNX 模型。假如原始模型为 yolo11s.pt,则生成 yolo11s.onnx 模型。 然后进入rknn_model_zoo项目根目录,再依次进入examples/yolo11/python路径下,有一个python转换脚本:convert.py,可通过python convert.py 查看脚本帮助文档:python convert.py Usage: python3 convert.py onnx_model_path [platform] [dtype(optional)] [output_rknn_path(optional)] platform choose from [rk3562, rk3566, rk3568, rk3576, rk3588, rv1126b, rv1109, rv1126, rk1808] dtype choose from [i8, fp] for [rk3562, rk3566, rk3568, rk3576, rk3588, rv1126b] dtype choose from [u8, fp] for [rv1109, rv1126, rk1808] 根据文档可知,脚本的第一个参数是要被转换的onnx模型路径,第二个参数是平台,即SOC型号,第三个参数是量化相关,我们的平台是rk3576,如果量化则选i8,不量化则选fp。我们这里选择量化:❝ ⚠️ 选择量化需要准备校准数据,读取的数据路径在脚本中已经固定为../../../datasets/COCO/coco_subset_20.txt,这里需要修改为我们自己的数据,数量建议至少20张。python convert.py onnx模型路径/yolo11s.onnx rk3576 i8 转换成功后可看到: 脚本默认将转换后的模型存储在../model中。3.2 PPLCNETV2模型转换PPLCNETV2网络是Paddle提供的,因此需要使用paddle2onnx工具,先将paddle格式转为onnx格式:paddle2onnx \ --model_dir models/ \ --model_filename inference.pdmodel \ --params_filename inference.pdiparams \ --save_file paddle_feature_one_batch.onnx \ --opset_version 11 \ -isd "{'x':[ 1, 3, 320, 320 ]}" 由于RKNN官方没有PPLCNET模型的Demo,因此我们需要自己根据模型转换的API文档编写rknn模型的转换脚本,可复 制一份Yolo11的转换脚本进行修改,重点修改模型的输入输出形状、归一化参数等。然后参考yolo11的转换命令进行转换。4. 菜品识别案例 本章将详细介绍基于米尔MYD-LR3576边缘计算盒开发的菜品识别安卓Demo应用。该案例完整展示了从特征库构建到实时识别的全流程,充分体现了设备在端侧AI应用中的实用性与高性能。4.1 特征注册特征注册是构建可扩展菜品识别系统的关键第一步,其目的是为系统创建一个本地的、可定制的菜品特征库。操作流程: 用户在Demo界面点击“特征注册”按钮后选择一个事先准备好的文件夹。该文件夹内部包含多个子文件夹,每个子文件夹代表一道唯一的菜品,并以菜品名称命名(例如:“红烧肉”、“清蒸鲈鱼”)。子文件夹内则包含该菜品从不同角度、在不同光照条件下拍摄的若干张图片。技术实现: Demo应用会遍历整个文件夹结构。对于每一张图片,系统会调用内置的PPLCNetV2特征提取模型进行特征提取。该模型会将输入的菜品图片转换成一个高维、紧凑的特征向量(也就是老生常谈的特征嵌入)。最后,系统将每道菜所有图片的特征向量与其名称关联起来,使用向量数据库存储于设备本地,形成一个结构化且高效查询的特征数据库。该设计的优势在于:用户无需重新训练庞大的深度学习模型,仅需提供数十张示例图片,即可快速、灵活地扩充或修改系统所能识别的菜品库,极大地提升了应用的实用性和适应性。4.2 菜品识别Demo提供了三种识别模式,以适应不同场景下的需求:4.2.1 拍照识别用户可以直接调用设备摄像头,现场对菜品进行拍照。拍完后,系统立即对照片进行识别,并绘制识别结果。4.2.2 本地图片识别用户可以从手机相册中选择已有的菜品图片进行识别。4.2.3 实时视频流识别Demo启动设备摄像头并开启实时预览,视频流中的每一帧都会被送入识别流水线。系统能够连续、不间断地进行识别,并将结果实时覆盖显示在视频画面上,提供流畅的“所见即所识”体验。4.3 识别流水线与性能表现无论采用哪种识别模式,其核心的识别流水线是相同的,并且都得益于MYD-LR3576强大的NPU算力:1. 目标检测: 当一张图片或视频帧输入后,首先由 YOLOv11s模型进行推理。它的任务是精准定位图片中菜品所在的位置,并输出其边界框,为后续处理划定了关键区域。2. 特征提取: 系统将YOLOv11s检测出的菜品区域裁剪出来,并送入 PPLCNetV2特征提取模型中,生成该区域的特征向量。3. 特征比对: 最后,系统将这个新生成的特征向量与特征注册阶段建立的数据库中的所有已知特征向量进行相似度计算(通常使用余弦相似度)。找出相似度最高的已知菜品,并将其名称作为识别结果输出。性能亮点: 在MYD-LR3576上,经过RKNN-Toolkit2优化后,YOLOv11s和PPLCNetV2这两个模型在NPU上的单次推理时间均稳定在20ms左右,这确保了即使在最耗费资源的实时视频流模式下,系统也能保持较流畅的识别帧率。4.4 准确率评估功能为了量化识别系统的可靠性,Demo还内置了准确率评估功能。用户可以选择一个包含已标注图片的测试集,系统会自动运行批量识别,并将识别结果与真实标签进行比对,最终生成一份包含准确率等关键指标的评估报告,为模型优化和特征库完善提供了数据依据。4.5 案例总结该菜品识别Demo仅实现了基础功能,且没有做针对性优化,如所有操作都是同步进行,即摄像头数据获取或读取本地图像->格式转换->色彩空间转换->预处理->模型推理->结果后处理这一整套流程都是同步进行,且模型推理时仅使用了一个NPU核心(共两个),如果使用NPU进行图像处理并配合图像队列异步处理以及充分利用NPU核心,其性能可以达到15-20帧。即便Demo没有针对优化,RK3576的性能同样足够支撑端侧复杂AI流水线的能力。从高效的特征注册到实时的多模型推理,其强劲的NPU算力是实现所有功能流畅运行的基石,为智慧餐饮等领域提供了可靠的硬件解决方案。来源:硬件笔记本

未登录
还没有评论
课程
培训
服务
行家
VIP会员 学习计划 福利任务
下载APP
联系我们
帮助与反馈