首页/文章/ 详情

别再无脑撒积分点了!八叉树 + S BFEM,把疲劳仿真从 15 天干到 8.8 天
11分钟前浏览0
仿真案例拆解 · CMAME 2026

一次晶体塑性仿真跑 15 天?他们砍到 8.8 天,还把代码开源了

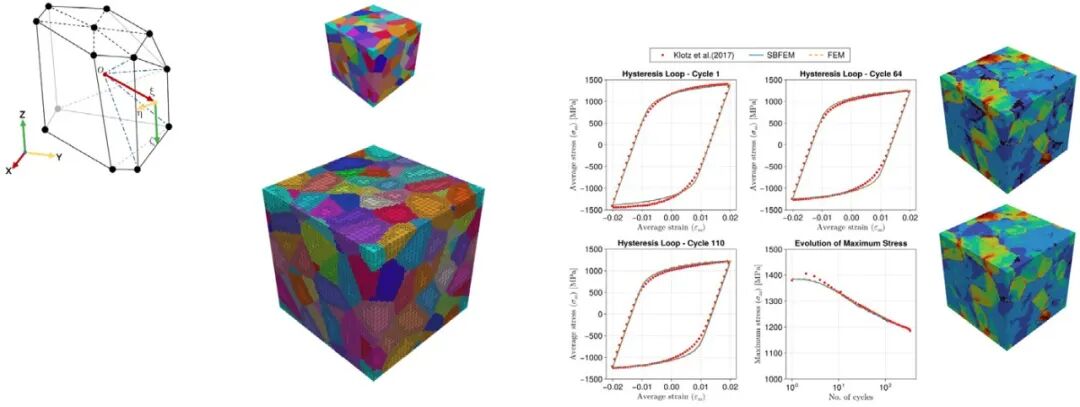
论文图形摘要

做晶体塑性(CP)仿真的兄弟,都体会过那种绝望:

一个 100 晶粒的多晶 RVE,64³ 体积网格——26 万个单元、209 万个积分点。每个积分点挂一套 12 滑移系的粘塑性本构,内层还要套牛顿迭代。疲劳工况一上来就是 115 个循环。

双路 Xeon、40 核全开,一跑——15.4 天。

论文里的原话数字:368.76 小时。

而这篇 CMAME 新论文给了一个"邪修"解法:不魔改求解器、不上超算,把比例边界有限元(S BFEM)+ 八叉树网格塞进 ABAQUS,用 UELMAT 用户子程序实现晶体塑性。结果就三行:

▸ 计算时间 368.76 h → 212.21 h,直降 42.45%
▸ 单元数 262,144 → 98,001,砍掉 62.6%
▸ 材料点 2,097,152 → 98,001,砍掉 95.3%

精度方面:应力场、滞后环、循环软化,全部和 FEM + 实验数据对得上。

最关键的一句:代码开源了,连论文里所有算例的 inp 文件都给了。

一、先讲痛点:CP 仿真的"两难"

现在做多晶晶体塑性,主流就两条路,各有各的难受:

路线    
优点    
硬伤    
FEM(Abaqus/UMAT 那套)    
几何灵活、边界条件随便加,自由表面、裂纹都能碰    
慢:每单元 8 个积分点,每个点都要算一遍本构    
FFT 频谱法    
快,效率天花板    
只吃规则 voxel 网格,锁死周期边界;强应变局部化易翻车    
本文:S BFEM + 八叉树几何灵活 + 只在边界算本构
新方法,生态还在早期    

论文要补的就是这个空档:有没有一种方法,既有 FEM 的几何自由,又有 FFT 的算力账单?

二、S BFEM + 八叉树:偷懒的艺术
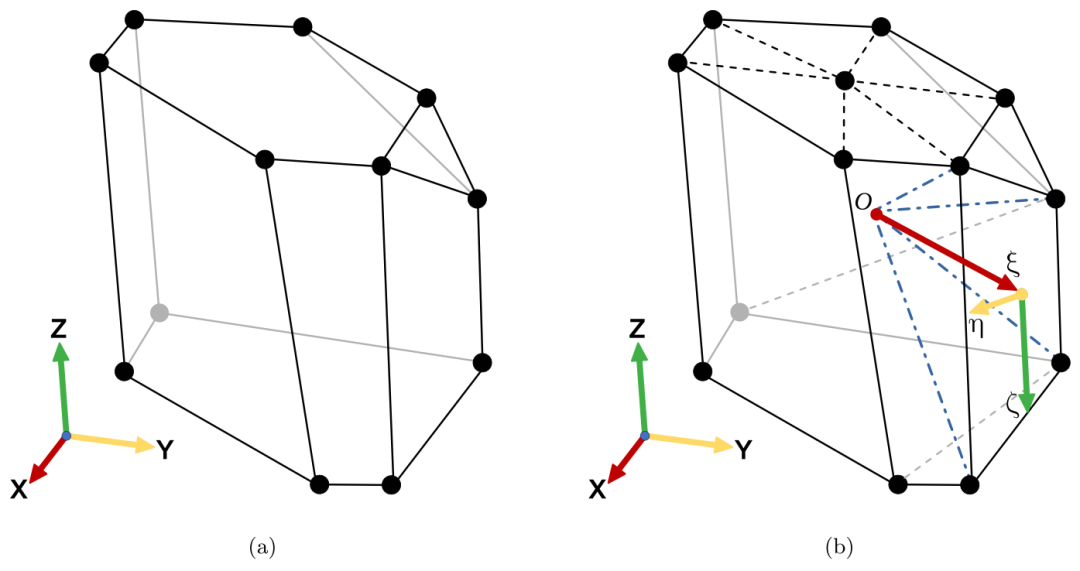
SBFE多面体单元示意

比例边界有限元(S BFEM)是个半解析方法,它最"骚"的一点:只在单元边界上剖分面网格,单元内部沿"缩放中心"径向解析。

后果有两个:

① 任意多面体都能当一个单元用(只要满足星凸条件)——不再受六面体/四面体拓扑约束;
② 本构只在边界节点上算一次——没有"一个单元 8 个积分点"这回事,这就是 95% 材料点砍量的来源。

这对八叉树(octree)网格简直是天作之合:
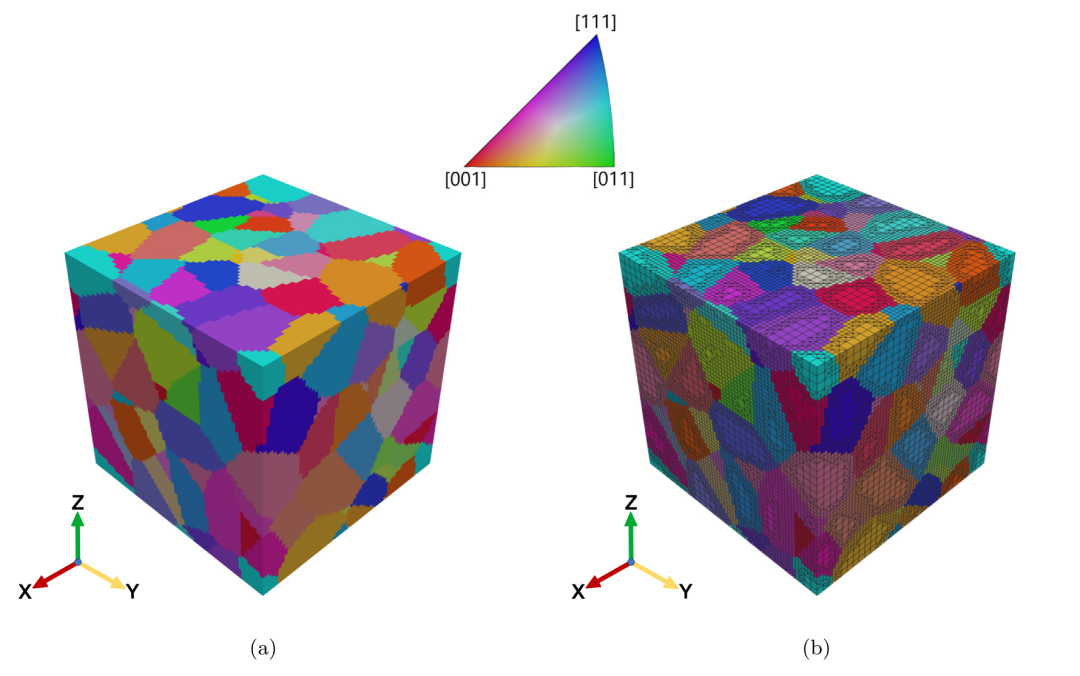
多晶RVE与八叉树网格

八叉树网格可以直接从 3D 显微组织图像生成——Dream3D、Neper 吐出来的 voxel 数据直接转网格,不用人工划分。晶界处应力梯度大,局部加密;晶粒内部变形平缓,保持粗网格。

代价是八叉树会产生"悬节点"(hanging nodes)——传统 FEM 处理悬节点得加各种约束方程,S BFEM 天然兼容:面网格剖分直接把 6 种悬节点构型全吃掉。

三、ABAQUS 落地:UELMAT,不是 UEL

二开党重点看这段,实现细节都在这了:

▸ UEXTERNALDB:预处理入口——读八叉树网格、逐单元识别 octree 构型;
▸ UELMAT:单元力和本构更新的主战场。作者特意选 UELMAT 而不是传统 UEL,因为它能通过 MATERIAL_LIB_MECH 调用 ABAQUS 内置材料库;
▸ 预计算榨干八叉树的几何相似性:全部 4096 种平衡八叉树构型的矩阵一次性算好存表,运行时直接缩放复用。本算例实际出现 808 种构型,预计算总共只花 42.93 秒、190 MB 内存;
▸ 后处理:ParaView + Julia 脚本生成可视化文件;
▸ 支持 ABAQUS 原生并行(算例直接跑满 40 核)。

一句话总结:规则的网格结构 = 可预计算、可复用的算力。这是整篇文章提速的底层逻辑。

四、验证:从单元级到疲劳,一层层过

第 1 关:基准测试

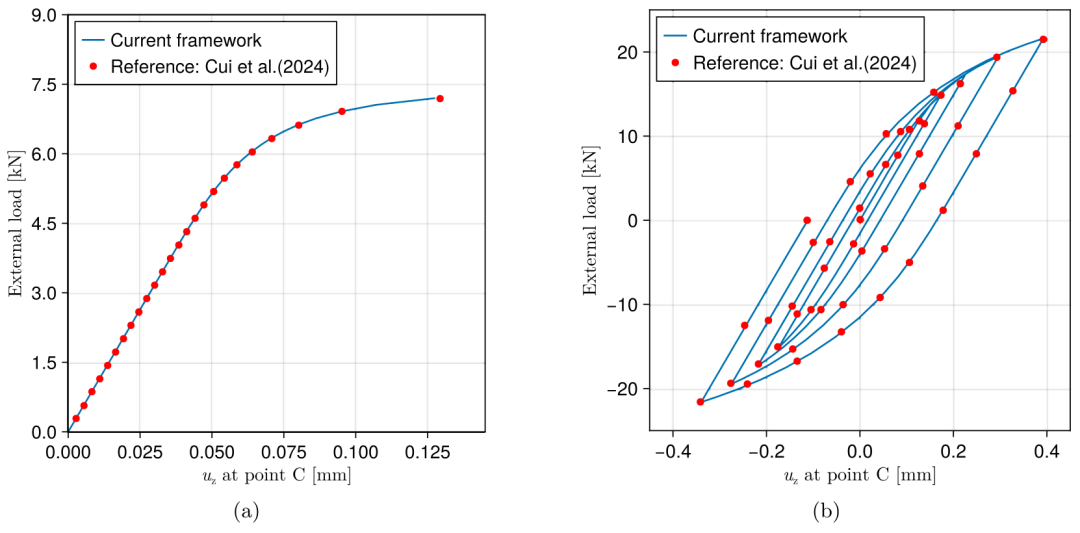
17 节点多面体单元过 patch test;Cook's membrane 单调 + 循环加载,载荷–位移曲线与文献基准(Cui et al. 2024)几乎重合。
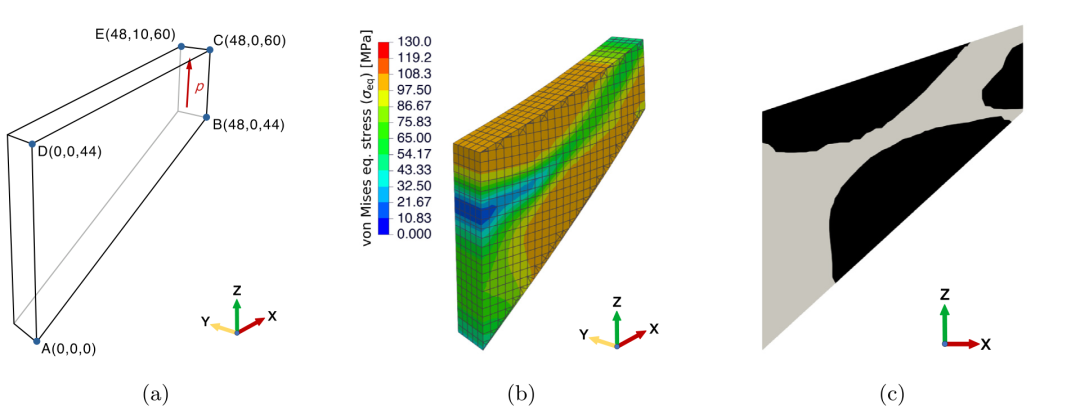
Cook's membrane 云图
Cook's membrane 验证曲线

第 2 关:单晶三取向

SS317L(FCC,12 个 {111}⟨110⟩ 滑移系),沿 ⟨100⟩、⟨110⟩、⟨111⟩ 三个取向做单轴拉伸:

▸ 激活滑移系数目分别为 8 / 4 / 6,与理论预测完全一致;
▸ FEM 与 S BFEM 的应力–应变曲线基本重叠。
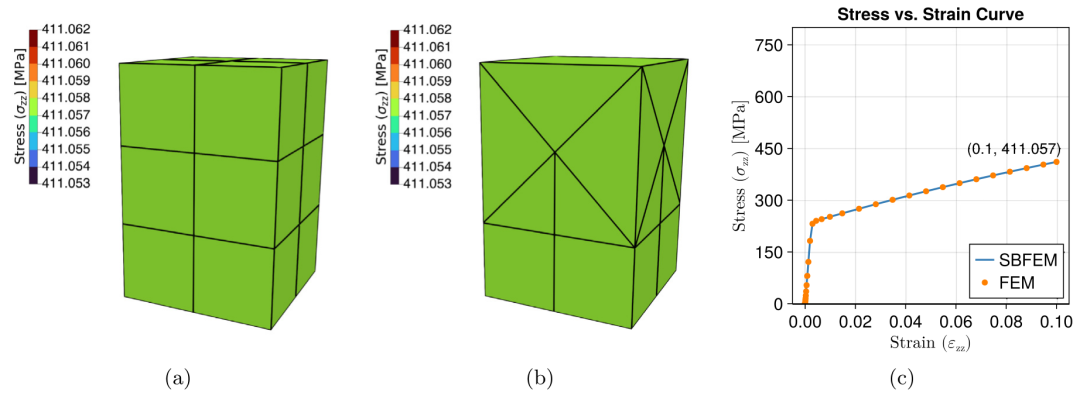
单晶三取向验证

第 3 关:多晶 RVE 单调拉伸

100 晶粒随机织构,周期边界条件,10% 拉伸应变:
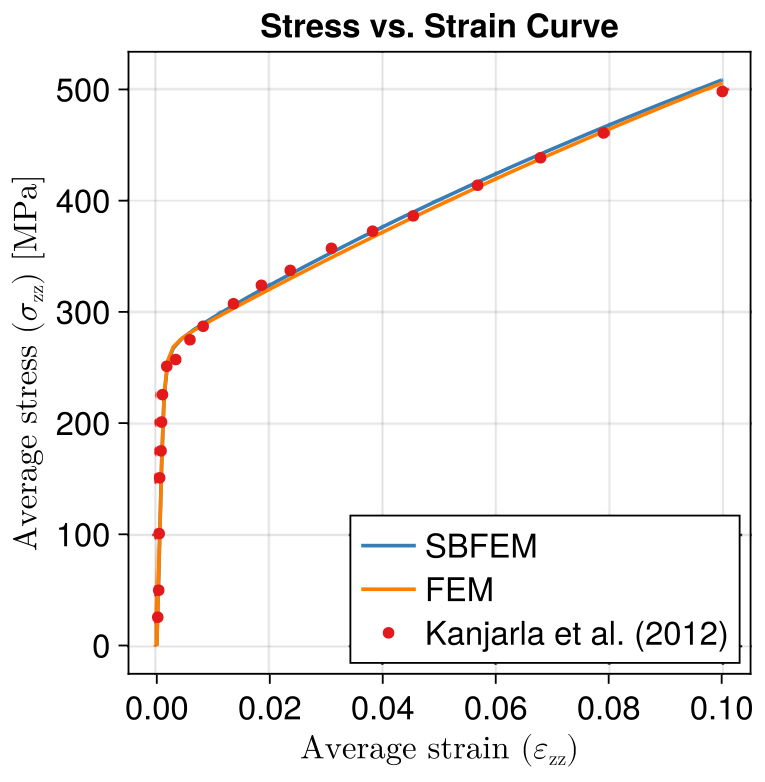
多晶宏观应力应变曲线
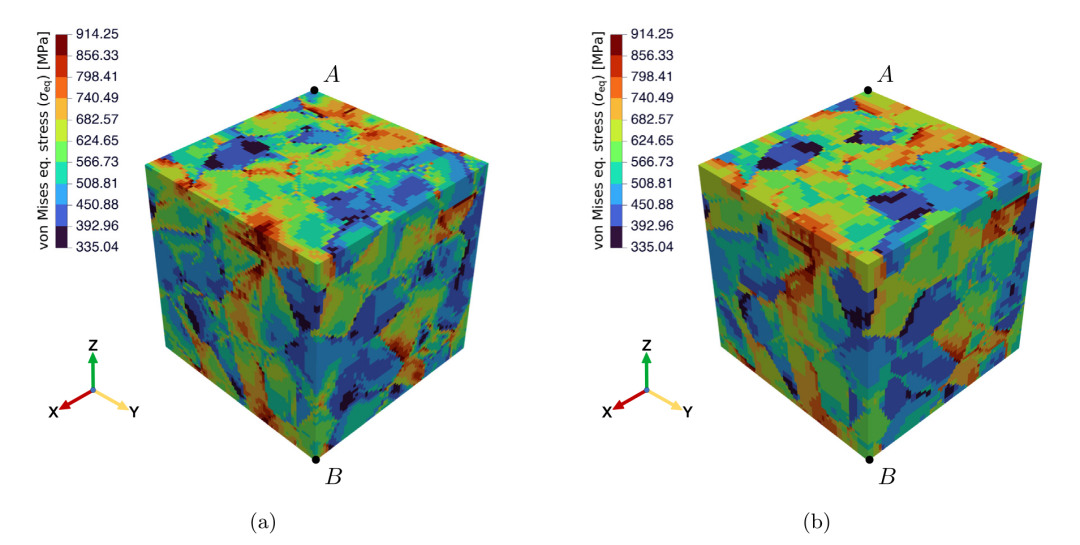
多晶von Mises应力场对比

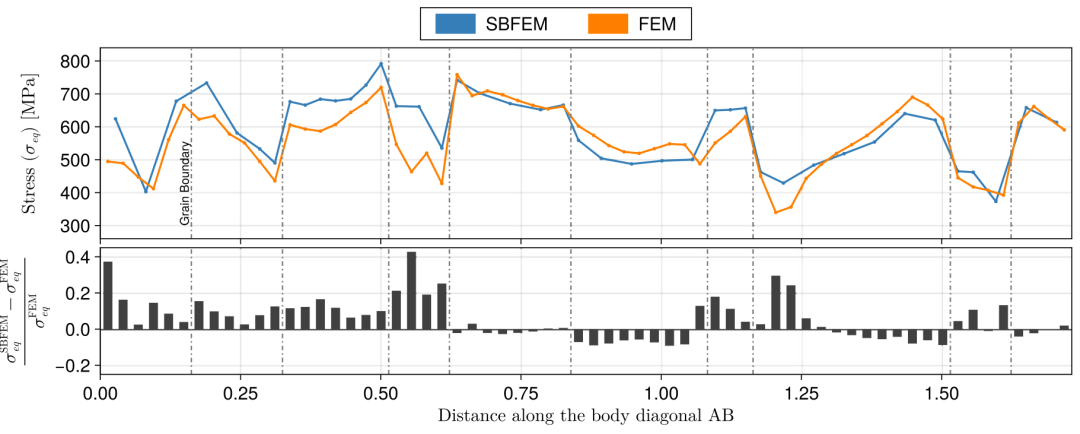
体对角线逐点抽应力对比,趋势吻合——局部有些波动,原因后面细说。

体对角线应力对比

五、重头戏:IN718 疲劳,115 个循环

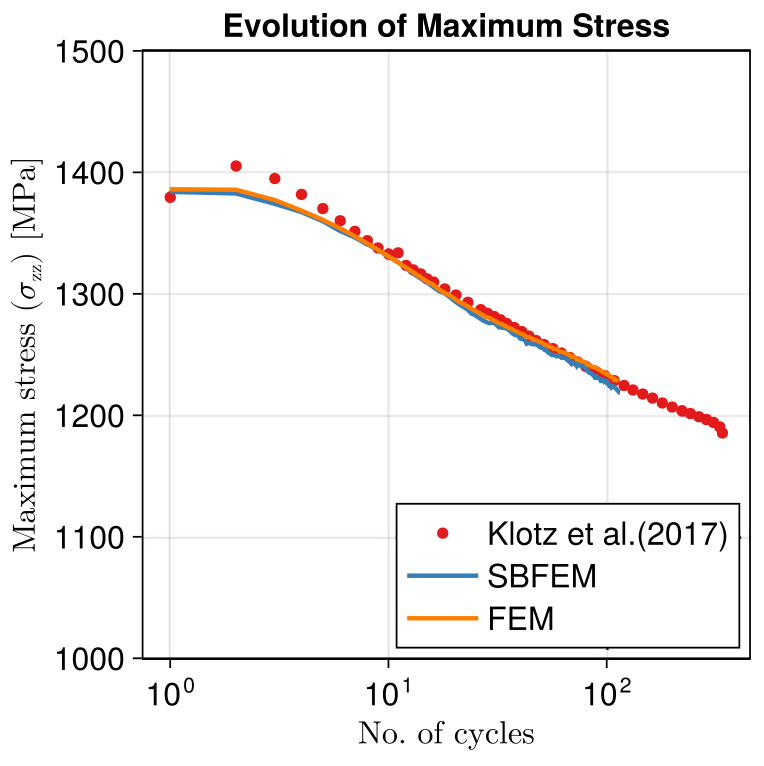
材料换成 IN718 镍基高温合金——航发涡轮、燃气轮机的常客。FCC 奥氏体基体,两个标志性行为:Bauschinger 效应(压缩屈服低于拉伸)和循环软化(应力幅随循环递减)。

本构用 Cruzado 循环晶体塑性模型(各向同性软化 + 随动硬化,Ohno–Wang 背应力),实验数据来自 Klotz et al.

⚙️ 工况:应变幅 2%,R = −1,三角波,115 个循环,周期边界条件
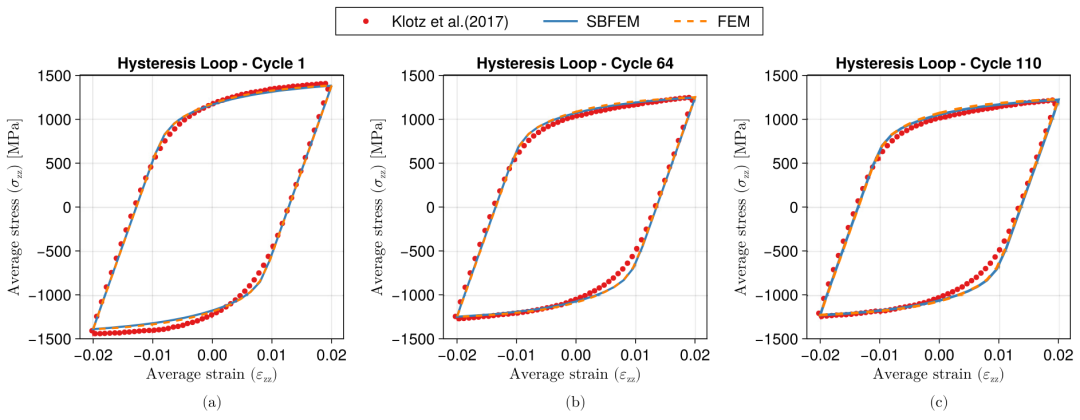
滞后环对比
循环软化曲线

对疲劳仿真来说,最值钱的是下面这张图:第 110 圈完全卸载后的残余应力场。损伤就萌生在这些应力集中 hotspots,S BFEM 把热点的位置和强度抓得和 FEM 一样准。
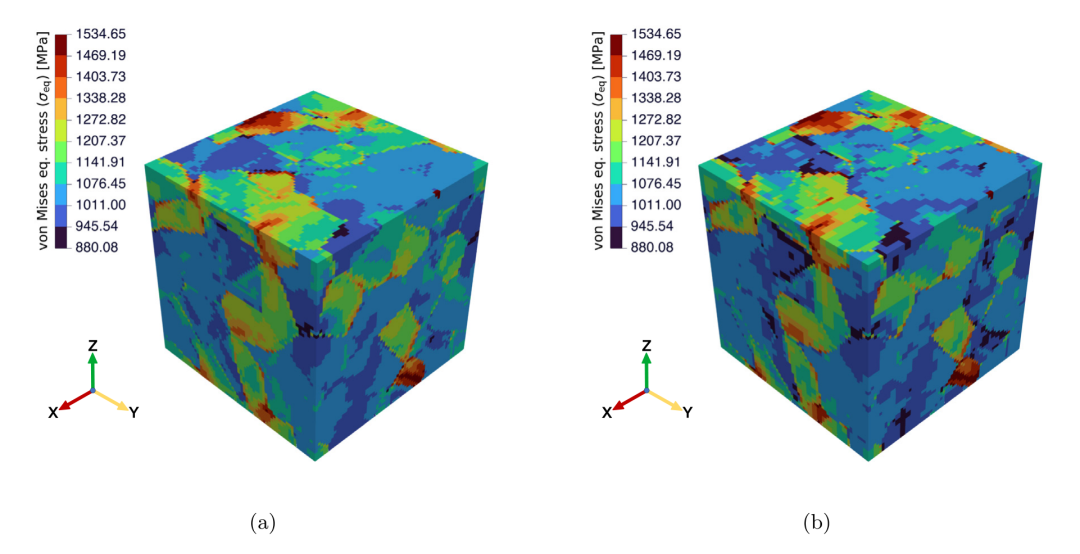
残余应力场

六、性能账本,一笔一笔算给你看

(IN718 疲劳算例,双路 Xeon Gold 6248,40 核 2.5 GHz,192 GB 内存)

指标    
FEM    
S BFEM    
变化    
节点数    
274,625    
179,934    
↓ 34.5%    
单元数    
262,144    
98,001    
↓ 62.6%    
材料点数    
2,097,152    
98,001    
↓ 95.3%    
总计算时间    
368.76 h(15.4 天)    
212.21 h(8.8 天)    
↓ 42.45%
NR 迭代总次数    
31,087    
32,246    
↑ 3.7%    
Cutback 增量    
236    
593    
↑ 151%    
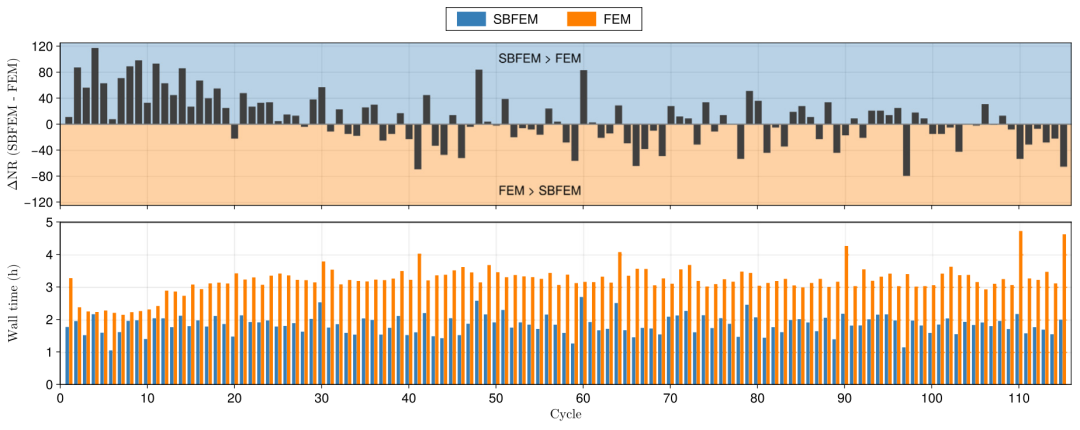
逐循环耗时对比

注意一个反直觉的细节:S BFEM 的非线性迭代反而更多(cutback 多了 151%),但它赢在单次迭代便宜——自由度少 35%、材料点少 95%。总账下来,42.45% 提速。

逐循环看墙钟时间(下图),S BFEM 每一圈都稳定低于 FEM,不是靠某一圈运气好。

七、别吹过头:适用边界

说实话环节。这方法不是银弹,三个坑要知道:

① 均匀应变假设:本构更新只用增量应变的空间平均值,局部塑性应变会略低估——强应变局部化区域(比如晶界附近)的局部应力有偏差。宏观响应没问题,逐点精度别指望追平细网格 FEM;

② 分辨率受最小八叉树单元限制,晶界过渡带抓得没有细网格 FEM 细;

③ 规模越小越不划算:S BFEM 单元边界节点多,小模型优势不明显——规模越大,省得越多。

另外它目前内置的是 Voce 硬化 + Cruzado 循环模型,但框架本身本构无关——换模型只需要替换本构更新模块,S BFEM 骨架不用动。作者下一站:相场断裂。

八、动手党福利:仓库怎么用

🔗 GitHub:github.com/nsundar/cp-s bfem

▸ ABAQUS 用户子程序全套(UELMAT + UEXTERNALDB)
▸ 论文所有算例的 inp 输入文件(可完整复现)
▸ Julia 后处理脚本(输出 ParaView 可视化文件)
▸ 用户手册:环境搭建、运行、复现全流程

ABAQUS 2023 验证通过。二开党可以直接把 CP 本构换成自己的模型,骨架代码一行不用改。

最后

这篇论文真正的价值,其实不是那 42%。

是这句话:结构化网格的"规则性"本身,就是可以预计算、可以复用的算力。

S BFEM 是 Wolf 和 Song 上世纪九十年代为无 界域动力分析搞的"老古董",沉寂了二十多年——2026 年,靠"八叉树 + 晶体塑性"这个组合在 CMAME 翻红了。

方法不问出处,用对了地方,老古董也能发顶刊。


来源:有限元先生
Abaqus疲劳断裂非线性UM裂纹理论材料ParaView
著作权归作者所有,欢迎分享,未经许可,不得转载
首次发布时间:2026-11-17
最近编辑:11分钟前
有限元先生
博士 我们穷极一生,究竟在追寻什么?
获赞 46粉丝 48文章 128课程 0
点赞
收藏
作者推荐

从PPO到Agentic RL:2026大模型强化学习算法路线梳理

2022 年 ChatGPT 上线之后,强化学习就从一个小众领域,变成了夹在"聪明的基础模型"和"有用的产品"之间的那一层。到了 2026 年,训练大模型要回答的问题早就不是"要不要用 RL",而是——用哪一种 RL?基于什么奖励信号?配多大的算力预算?这篇文章我们结合强化学习的算法发展路径,把当前流行的 RL 算法一次讲清。同时整理了 22 篇强化学习必读论文 + 374 篇顶会强化学习前沿论文。一、三大基石所有新算法都是它们的"后代"PPOProximal Policy Optimization|OpenAI,2017 · 核心标签:经典基石 / 稳定性优先 / 显存开销大PPO 的核心是一个"裁剪"机制:严格限制新旧策略的差异,每次更新只迈一小步。就像教 AI 骑自行车——不许它因为一次摔倒就推翻全部经验,只允许微调,靠"小步快跑"累积稳定进步。✅ 优势 训练稳健、不易崩、可控可复现❌ 短板 策略网络 + 价值网络双份开销,千亿模型时代显存吃不消现状:没死,但已不再是默认选项。多模态、具身智能和生产级对齐仍是首选。DPODirect Preference Optimization|Stanford,2023 · 核心标签:颠覆性简化 / 离线对齐 / 单卡友好DPO 做了一次漂亮的"减法":绕过奖励模型,直接拿"好答案 vs 坏答案"的对比数据做监督学习。训练流程和 SFT 一样简单,跑起来像微调,成本只有 PPO 的 1/2~1/4。✅ 优势 轻量、稳定、无奖励黑客风险❌ 短板 不探索——正确答案不在数据里,它就学不会现状:中小模型对齐的事实标准。2026 年的 InSPO、TI-DPO、RAPPO 都是它的精细化后代。GRPOGroup Relative Policy Optimization|DeepSeek,2024 · 核心标签:DeepSeek-R1 同款 / 去 Critic / RLVR 标配GRPO 把 PPO 最贵的"裁判"(Critic 价值网络)直接砍掉:同一个问题采样一组答案,组内互相比——好的加分、差的扣分,像一场没有标准答案的"小组互评"。✅ 优势 显存省一半,天然契合"可验证奖励"❌ 短板 采样趋同时学习信号消失;token 级噪声在长序列中不断累积现状:DeepSeek-R1、Qwen、OLMo……2025-2026 年几乎所有开源推理模型背后都是它或它的变体。但 vanilla GRPO 是脆弱的。二、GRPO:最卷的战场2025-2026 年,算法是商品,稳定化才是真功夫DAPO字节 Seed · 核心标签:GRPO++ 事实标准 / 工业级四件套:Clip-Higher(防熵崩溃)+ 动态采样(跳过全对/全错的无效题)+ Token 级损失(消除长度偏差)+ 超长样本惩罚。Qwen2.5-32B 在 AIME 拿到 50 分,训练步数只要 DeepSeek-R1 的一半,且全开源。长推理训练,从它抄作业就对了。GSPO阿里 Qwen · 核心标签:Qwen3 同款 / 序列级优化 / MoE 友好GSPO 认为好文章看的是整体而非单个字:把重要性比值从 token 级提升到整段序列级,彻底消除长序列的噪声累积,MoE 模型还不用再打 Routing Replay 补丁。训 MoE 大模型,目前最稳的选择。GMPOMicrosoft Research · 核心标签:换种平均就稳了用 token 比值的几何平均替代算术平均,天然抑制异常 token 的影响(数学上可证 |J_GMPO| ≤ |J_GRPO|)。GMPO-7B 数学 Pass@1 直接 +4.1 个点。GFPOMicrosoft Research · 核心标签:治"话痨"专病RL 训练会让模型越说越长但不见得更准。GFPO 多采样再按"最短回答 / token 效率"过滤,只训最优子集——长度压缩 70-85%,精度不掉。VAPO / CISPO / BAPO字节 Seed / MiniMax / FudanVAPO:把价值模型请回来做精细信用分配,长 CoT 任务上打脸"无 Critic 万能论";CISPO:只裁剪权重不裁剪 token,保住"wait、recheck"这类低概率反思词,比 DAPO 快 2 倍;BAPO:离线 / 异步场景的自适应平衡器,防止模型学历史失败案例学到"摆烂"。三、2026 主战场:Agentic RL从"会聊天"到"会做事"单轮做题的红利吃完后,所有人的火力都转向了多轮工具调用、长程规划的 Agent RL。这里有三个新问题:奖励更稀疏、信用更难分配、rollout 更烧钱。ARPOAgentic RL 开山作关键洞察:Agent 在工具调用返回的那一刻,token 熵会骤增——那是决策分叉点。ARPO 只在这些"卡脖子"步骤分支采样、重点探索,token 消耗大降、任务成功率大升。Tree-GRPOICLR 2026把树搜索搬进 Agent RL:共享前缀让同样 token 预算下 rollout 数量翻倍,树结构还天然免费送出步级过程监督信号。11 个数据集全面碾压链式方法。GiGPO / CW-GRPO / AT-GRPOALFWorld / ACL 2026 / ICLR 2026GiGPO:组中组,轨迹级 + 步级两层优势,ALFWorld +12%;CW-GRPO:用 LLM Judge 给每轮检索打"贡献分"重缩放优势,搜索 Agent 提升显著;AT-GRPO:多智能体系统专用,按角色 / 轮次分组,长程规划从 14% 干到 96%+。另外,Critic 回归可能是 2026 最值得玩味的一条线:智谱 GLM-5 从 GRPO 起步,GLM-5.2 在长程 Agent 阶段明确放弃组相对优化、改回基于 Critic 的方法。原因在于:当一条几十步的 Agent 轨迹被压缩成数量不等、长短各异的子轨迹,GRPO"组内可比"的假设就崩了——同一 prompt 的 rollout 根本没法公平对比。只有 Critic 能对单条轨迹做 token 级优势估计。加上 GCPO(几何子空间约束)等 2026 新工作的出现,一个清晰的判断是:"GRPO 家族 + 可验证奖励"的共识,正在长程 Agentic 场景松动。2026 年的 RL 版图,正在裂变成"短推理用 GRPO 系、长 Agent 回 Critic 系"的双轨制。五、一张表选型场景 首选算法 小模型 / 单卡对齐 DPO 数学代码推理(稠密模型) GRPO → DAPO MoE 大模型长序列 GSPO 模型话痨、输出冗长 GFPO / Dr.GRPO 要保留反思探索能力 CISPO 多轮工具调用 Agent ARPO / Tree-GRPO 多智能体协作系统 AT-GRPO 长程 Agent、轨迹压缩 回归 Critic(VAPO / GLM-5.2) 来源:有限元先生

未登录
还没有评论
课程
培训
服务
行家
VIP会员 学习计划 福利任务
下载APP
联系我们
帮助与反馈