
2-63 杂波、漏检和目标出生同时存在时,怎样跟踪数量不断变化的多个目标?
MATLAB GM-PHD + 线性 CV 模型多目标跟踪仿真程序
一句话介绍: 这套 MATLAB 程序在 100 个离散时刻内构造 5 个具有不同出生、消失和衍生关系的运动目标,再加入高斯量测噪声、漏检和泊松杂波,通过 Gaussian Mixture PHD(GM-PHD)完成多目标状态预测、量测更新、高斯分量修剪合并和目标提取,最终对比真实航迹、估计航迹、目标数以及 OSPA 集 合距离。
先看它解决什么问题
单目标跟踪通常可以把问题理解成:
一个目标 → 一组量测 → 预测下一时刻位置 → 用新量测修正
但多目标场景会复杂很多。
当前程序同时设置了:
已存在目标;后续新出现的目标;中途消失的目标;
从已有目标附近衍生出来的新目标;没有对应真实目标的随机杂波;
有一定概率漏掉的真实目标量测。
因此程序面对的并不是简单的“从一堆点里画轨迹”,而是两个问题同时变化:
目标在哪里?以及:现在究竟有几个目标?
当前工程给出的完整处理链可以概括为:
构造 5 个真实目标 → 生成含漏检和杂波的二维量测 → GM-PHD 预测 → GM-PHD 量测更新 → 高斯分量修剪与合并 → 提取目标状态和目标数量 → 使用集 合距离评价结果
这也是 GM-PHD 在这套程序里的核心价值:它不是预先假定目标数量固定,而是用随机有限集强度同时描述多个可能目标。
1. 当前工程里真正有哪些程序?
项目编号为 63,主工程目录为 GM-PHD。
运行它以后,其余函数会按照主流程自动调用。
工程中比较关键的文件如下:
文件 | 当前程序中的作用 |
|---|---|
GMPHD.m | 主入口,设置模型、参数、运行 GM-PHD 并绘制结果 |
TARGET_FORM.m | 构造 5 个目标的真实运动轨迹和存在区间 |
MEASUREMENT.m | 根据检测概率生成目标量测,并叠加泊松杂波 |
PREDIC.m、PREDIC_S.m | 完成新生、衍生和存活高斯分量预测 |
UPDATA_PHD.m | 根据当前量测更新 GM-PHD 高斯分量 |
PRUN_MERG.m | 修剪低权值分量并合并相近高斯分量 |
PHD_ESTIMATE.m | 根据分量权值提取目标状态 |
OSPA.m、Normp.m、Hungary.m | 构造集 合距离并通过匈牙利算法完成最优分配 |
1.fig~4.fig | 工程保存的一次历史仿真结果 |
TryAssign.m、ZeroCover.m、ZeroNumber.m、IsInMatrix.m 是匈牙利分配算法使用的辅助函数。
工程中虽然还存在 WDISTANCE.m 和 predic_n.m,但从当前 GMPHD.m 的实际调用链来看,它们并没有参与这次 GM-PHD 主仿真。
这里还有一个重要特点:当前程序不需要读取外部目标数据。
真实航迹、随机量测、杂波和漏检全部由程序内部直接生成,因此它本质上是一套完整的多目标跟踪算法仿真实验。
2. 这 5 个目标是怎样出现和消失的?
仿真总长度为:N = 100
采样/状态推进间隔:T = 1 s
程序定义的目标存在区间并不相同。
目标 | 存在时刻 | 初始位置 | 速度特点 |
|---|---|---|---|
目标 1 | 1~60 | x=-40,y=50 | x 正向运动,y 负向运动 |
目标 2 | 21~80 | x=40,y=20 | x、y 均负向运动 |
目标 3 | 31~100 | x=50,y=-50 | x 负向、y 正向运动 |
目标 4 | 41~100 | x=-60,y=-40 | x、y 均正向运动 |
目标 5 | 51~80 | 由目标 2 附近衍生 | x 基本保持不变,y 负向运动 |
因此真实目标数量会按照时间发生明显变化:
1 → 2 → 3 → 4 → 5 → 4 → 2
具体来说:
1~20 时刻:1 个目标;
21~30 时刻:2 个目标;
31~40 时刻:3 个目标;
41~50 时刻:4 个目标;
51~60 时刻:5 个目标;
61~80 时刻:4 个目标;
81~100 时刻:2 个目标。
目标 5 是这个案例中比较特殊的一部分。
在目标 2 运动到第 50 个时刻附近时,程序建立一个新的衍生状态,并从第 51 个时刻开始形成目标 5 的真实轨迹。
这让当前案例不仅验证普通的“目标出生和消失”,还包含了:
已有目标附近出现新目标的情况。
3. 每个目标为什么采用线性 CV 模型?
当前状态向量为:
xₖ = [pₓ, vₓ, pᵧ, vᵧ]ᵀ
也就是同时保存:
X 方向位置;X 方向速度;
Y 方向位置;Y 方向速度。
程序使用标准的二维恒速 CV 模型。
简单理解,在一个采样周期内:
新位置 = 原位置 + 时间间隔 × 原速度
而速度保持不变。
对应关系为:
pₓ,k = pₓ,k₋₁ + T·vₓ,k₋₁
pᵧ,k = pᵧ,k₋₁ + T·vᵧ,k₋₁
当前:T = 1 s
所以每经过一个仿真时刻,位置按照当前速度向前推进一次。
程序还设置:q = 0.01
作为滤波器预测协方差中的过程噪声尺度。
需要注意的是,TARGET_FORM.m 中给真实目标轨迹加入过程随机噪声的代码目前被注释掉了。
也就是说:
当前真实航迹本身按照确定性的 CV 模型运行,而 q 主要作用于 GM-PHD 内部的状态不确定度预测。
因此这套实验更适合观察:
量测噪声、漏检、杂波以及目标数变化
对 GM-PHD 跟踪过程的影响,而不是研究真实目标自身的强随机机动。
4. 程序怎样把真实目标变成“杂乱的观测点”?
观测模型只读取目标的位置,不直接测量速度。
因此:
zₖ = Hxₖ + νₖ
这里的 H 会从四维状态中提取:
X 位置 + Y 位置
量测噪声标准差设置为:rr = 0.2
所以量测协方差为:R = 0.04I
但真正让观测画面变复杂的,还有两个机制。
首先是漏检。当前检测概率:p_d = 0.99
每个真实目标在当前时刻并不是百分之百产生量测,而是通过随机数决定是否被检测到。
其次是杂波。
程序在:[-70,70] × [-70,70]的二维区域内均匀生成随机杂波,每个时刻的杂波数量服从泊松分布:clutter ∼ Poisson(3)
也就是说,平均每个时刻会额外出现约 3 个没有对应真实目标的观测点。
于是滤波器实际接收到的是:
真实目标量测 + 高斯位置误差 + 随机漏检 + 泊松杂波
而不是干净的真实航迹。
这正是工程中“目标真实轨迹淹没在观测点中”的来源。
5. 为什么这里不能简单地把每个观测点连起来?
因为一个时刻可能同时出现多个真实量测和多个杂波点。
下一时刻又会出现另外一组点。
如果直接采用:
最近的点 → 最近的点 → 最近的点
很容易在以下情况下关联错误:
两个目标互相接近;一个目标发生漏检;杂波恰好落在真实航迹附近;
新目标突然出现;旧目标已经消失。
GM-PHD 的处理思路不同。
它不直接维护“第 1 条轨迹、第 2 条轨迹……”这样的固定目标列表,而是维护整个目标集 合的强度。
当前程序使用多个高斯分量表示这张强度分布:
v(x) = Σⱼ wⱼ·N(x; mⱼ, Pⱼ)
其中每一个高斯分量包含:
权值 w;状态均值 m;协方差 P。
这里最值得理解的是权值。
所有高斯分量权值之和,可以用来估计当前目标数量。
因此 GM-PHD 可以把:
目标状态估计和:目标数量估计
放在同一个递推框架中处理。
6. GM-PHD 的预测阶段具体做了什么?
当前 PREDIC.m 把预测强度分成三部分:
新生目标 + 存活目标 + 衍生目标
对于一个已经存在的高斯分量,PREDIC_S.m 执行:
m⁻ = Fm、P⁻ = FPFᵀ + GQGᵀ、w⁻ = p_s·w
当前目标存活概率:p_s = 0.99
所以旧目标在进入下一时刻以后,权值会先乘以 0.99。
同时,程序人为设置了 3 个新生高斯分量,对应:
目标 2 在第 21 个时刻附近出现;
目标 3 在第 31 个时刻附近出现;
目标 4 在第 41 个时刻附近出现。
它们的初始出生权值均为:0.01
程序另外定义了一组衍生目标强度:
yansheng
其均值为:[-3.5, 0, -23.5, -1.5]ᵀ
权值同样为:0.01
因此预测并不是单纯把旧目标向前推一步,而是不断向下一时刻提供:
“原来的目标可能继续存在,同时这里也可能出现一个新目标。”
这种机制正适合目标数随时间变化的问题。
7. 新量测到来以后,高斯分量怎样被修正?
预测以后,每个高斯分量都只是:
根据运动模型推测目标可能在哪里。
真正看到新量测以后,还需要继续做卡尔曼式修正。
程序先计算创新协方差:
S = R + HPHᵀ
再计算卡尔曼增益:
K = PHᵀS⁻¹
状态均值按照:
m⁺ = m + K(z - Hm)
进行修正。
协方差更新为:
P⁺ = P - KHP
与此同时,每个量测还会产生一组新的 GM-PHD 权值。
为了避免把所有量测都解释成真实目标,程序把杂波空间强度写成:κ = r / 140²
其中:r = 3
而 140² 正好对应当前 [-70,70] × [-70,70] 量测区域的面积。
因此,一个量测是否能真正形成较高目标权值,取决于:
预测分量与量测是否接近 + 原分量权值 + 检测概率 + 杂波强度
这也是 GM-PHD 能在大量观测点中逐渐突出真实目标位置的关键。
需要注意一个当前源码口径。
UPDATA_PHD.m 虽然计算了创新协方差 S,但量测似然 e 的归一化和指数项实际使用的是 R,而不是常见 GM-PHD/Kalman 推导中的 S。
因此:
当前工程结果应按现有源码实现理解;如果目标是严格复现标准 GM-PHD 数学公式,建议优先核对UPDATA_PHD.m中这一处量测似然计算。
8. 为什么更新后必须继续修剪和合并?
GM-PHD 有一个很现实的问题:
每来一个量测,都可能为原来的每个高斯分量产生新的候选分量。
如果一直保留,分量数量会快速增长。
因此 PRUN_MERG.m 做两件事。
第一步是修剪。
当前修剪门限:T_prun = 1×10⁻⁵
权值低于这个门限的高斯分量直接舍弃。
它们通常代表:当前数据已经很不支持的目标假设。
第二步是合并。
程序寻找当前权值最大的分量,然后计算其他分量与它之间的协方差加权距离。
当前合并门限:U_merg = 5
距离足够小的分量会被归为一组,再按照权值重新计算:
合并后的总权值;加权均值;加权协方差。
因此整个过程可以理解为:
大量候选假设 → 删除几乎不可能的假设 → 把描述同一目标的相近分量合并
程序还设置:J_max = 100作为高斯分量数上限。
需要注意,如果实际分量数超过 100,当前源码对应分支并不是常见的“保留权值最高的前 100 项”,而是复 制最大权值分量。因此默认实验可以保持当前设置,但如果为了高杂波实验大幅降低 J_max,建议先修正这一分支。
9. 程序最后怎样判断“现在有几个目标”?
目标数量估计来自一个非常直接的关系:
N̂ₖ ≈ Σⱼ wⱼ
也就是把当前 GM-PHD 中所有高斯分量权值相加。
GMPHD.m 保存这个结果后,在绘图阶段使用 round 得到整数目标数,与真实目标数量进行比较。
目标状态提取则由:PHD_ESTIMATE.m完成。
当前状态提取门限为:w > 0.5
只有权值超过 0.5 的高斯分量才会被当成一个可信目标。
如果某个分量权值大于 1,程序还会按照:round(w)重复输出该分量均值。
于是从 GM-PHD 强度到最终轨迹的过程就是:
连续强度分布 → 选择高权值高斯分量 → 输出离散目标状态
这一步把概率意义上的 PHD 结果重新变成了可以画在 X-Y 平面上的目标位置。
10. OSPA 在当前程序中怎样评价多目标结果?
多目标跟踪的误差不能只比较一条轨迹。
因为真实集 合和估计集 合可能连目标数量都不一样。
当前程序使用:OSPA.m
配合:Normp.m + Hungary.m
计算集 合误差。
默认参数为:c_ospa = 10、p_ospa = 2
程序先建立真实目标和估计目标之间的距离矩阵,再利用匈牙利算法寻找总匹配代价最小的一组对应关系。
最终距离为:d = (f / max[m,n])¹ᐟᵖ
其中 f 是最优分配后的总代价。
如果两个集 合数量不同,程序还会使用:cᵖ补足多出来的目标数量误差。
不过这里同样需要按照当前源码口径理解。
Normp.m 对真实配对计算的是状态向量前 3 个分量的 p 阶距离,即包含:
X 位置 + X 速度 + Y 位置
而没有使用第 4 个状态量 Y 速度;同时真实配对距离没有执行标准 OSPA 中常见的 min(c,d) 截断。
因此这条曲线更准确地说是:
当前工程采用匈牙利最优分配构造出的 OSPA 风格集 合距离。
它很适合比较这套程序自身不同参数下的结果,但如果要和其他论文中的严格标准 OSPA 数值直接横向对比,需要先统一评价公式。
11. 工程保存的一次仿真结果说明了什么?
工程中保存了 1.fig~4.fig。
直接读取这些 FIG 文件内部的数据后,可以确认保存内容分别为:
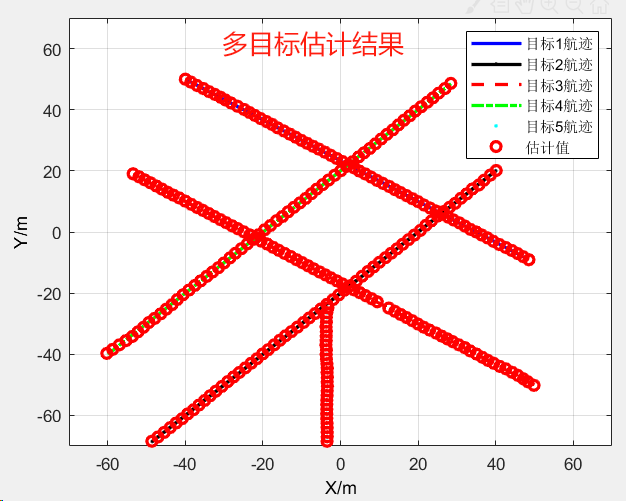
1.fig:真实目标轨迹与大量量测点;
2.fig:真实目标轨迹与 GM-PHD 位置估计;
3.fig:X、Y 两个方向随时间变化的真实值与估计值;
4.fig:真实/估计目标数量以及 OSPA 距离。
需要注意:
保存文件的编号顺序与当前GMPHD.m注释中的 Figure 编号并不完全一致,因此判断结果时应以 FIG 文件里的实际内容为准。
在这次已经保存下来的随机仿真中,真实目标在 100 个时刻累计形成:
280 个“目标-时刻”状态
目标数量估计曲线与真实值在:100 个时刻中的 99 个时刻完全一致。
唯一明显不一致出现在:第 57 个时刻
此时:真实目标数 = 5、估计目标数 = 4
OSPA 曲线也在同一时刻产生全程最明显的峰值:约 4.474
除这一时刻外,保存结果中的 OSPA 均低于 1,多数时刻大约处在 0.05~0.33 的范围。
整段保存结果的 OSPA:平均值约为 0.176;中位数约为 0.132;最大值约为 4.474。
这说明当前保存案例中最值得观察的不是持续性的整体失稳,而是:
当第 5 个目标存在时,第 57 个时刻发生了一次明显的目标漏估,目标数误差与集 合状态误差同时升高。
辅助元数据中把位置估计结果描述为“滤波发散”,但当前工程保存的目标数与 OSPA 数据并不支持把整个 100 时刻过程概括成持续发散,因此这里仍以实际保存结果为准。
另外,当前版本 GMPHD.m 末尾还会生成一张:
真实目标个数 / 被检测目标量测个数 / 含杂波总量测个数的对比图。
不过工程只保存了 1.fig~4.fig,没有对应的历史 5.fig,所以这部分可以运行时观察,但不把它当成已有固定结果。
12. 为什么这套程序适合做 GM-PHD 多目标跟踪实验?
它最适合的不是直接拿去做工业在线部署,而是以下几类任务。
GM-PHD 算法教学与流程验证
从真实轨迹、量测生成,到预测、更新、修剪、合并、状态提取和集 合距离评价,整个链路都直接写在 MATLAB 源码中。
因此非常适合顺着程序理解:
GM-PHD 到底是怎样一步一步工作的。
目标数变化实验
当前 5 个目标并不是从头到尾同时存在,而是不断出生、消失,并包含一个衍生目标。
所以它比固定两个目标一直运动的简单案例更适合验证:
目标数量估计能力。杂波、漏检和噪声参数敏感性实验
检测概率、平均杂波数、量测噪声和过程噪声都直接暴露在主脚本中。
修改这些值以后,可以直接观察:
轨迹估计是否偏离;目标数估计是否出现漏估或虚警;OSPA 是否升高;高斯分量数量是否明显增加。
多目标滤波算法二次开发基线
当前程序使用线性 CV + 线性位置量测,模型关系比较清楚。
因此很适合先把基本 GM-PHD 跑通,再继续尝试:
更强机动模型;非线性状态模型;非线性观测;不同出生强度;不同修剪合并策略;更严格的标准 OSPA 评价。
但按当前工程能力,它仍然是一套:
离线 MATLAB 算法仿真程序,而不是已经完成传感器接口、实时数据接入和工程部署的多目标跟踪系统。
13. 哪些参数最值得修改?
当前源码里真正值得做实验的主要是下面这些参数。
参数 | 当前值 | 为什么值得改 | 调整后的主要影响 |
|---|---|---|---|
q | 0.01 | 控制预测阶段的过程不确定度 | 增大后预测更“宽”,对机动可能更宽容,但也可能增加不确定分量 |
rr | 0.2 | 决定量测噪声和 R | 增大后量测更分散,跟踪难度提高 |
ps / pd | 0.99 / 0.99 | 分别控制目标存活和检测可信度 | 降低 pd 会增加漏检,降低 ps 会让旧目标权值衰减更快 |
r | 3 | 控制泊松杂波平均数量 | 增大后每帧虚假观测更多,高斯分量和关联歧义都会增加 |
T_prun | 1×10⁻⁵ | 决定多小的高斯权值被删除 | 调高可减少分量数量,但过高可能删掉刚出生或较弱目标 |
U_merg | 5 | 决定多近的高斯分量会合并 | 调大后合并更积极,过大可能把邻近目标错误地合到一起 |
如果主要目的是观察算法对杂波和漏检的反应,优先修改:
pd+r+rr
如果主要目的是研究 GM-PHD 自身的分量管理,则重点观察:
T_prun+U_merg
当前 J_max=100 对默认案例属于保护上限;在修正超过上限时的处理逻辑之前,不建议为了实验随意把它调得很小。
14. 怎么运行这套程序?
将 GM-PHD 文件夹中的所有 .m 文件保持在同一 MATLAB 工作目录,或者把该目录加入 MATLAB Path。
运行以后会自动完成:
建立目标 → 生成随机量测 → GM-PHD 递推 → 修剪合并 → 状态提取 → OSPA 计算 → 绘制结果
工程中的 WDISTANCE.m 虽然调用了 linprog,但它没有进入当前 GMPHD.m 主执行链,因此正常运行这次 GM-PHD 仿真并不需要为了它额外执行 Wasserstein 距离计算。
15. 一句话看懂这个项目
这是一个 MATLAB GM-PHD 多目标跟踪仿真程序:它在 100 个、间隔 1 s 的离散时刻内构造 5 个采用二维线性 CV 模型的目标,其中目标会在不同时间出生、消失并包含一个衍生目标;程序以 0.99 检测概率生成带 0.2 标准差高斯噪声的位置量测,并在 [-70,70]² 区域叠加平均每时刻 3 个的泊松杂波,再通过 GM-PHD 的新生/存活/衍生预测、量测更新、1×10⁻⁵ 权值修剪、5 阈值合并和 0.5 权值目标提取同时估计目标状态与目标数量。工程保存的一次仿真中,100 个时刻有 99 个时刻的目标数估计与真实值一致,第 57 个时刻由真实 5 个目标漏估为 4 个,同时集 合距离出现约 4.474 的最大峰值;因此这套程序最适合用于 GM-PHD 原理学习、目标出生/消失实验以及杂波、漏检和滤波参数敏感性验证。


