
首页/文章/ 详情

信号世界模型 | 面向循环平稳振动测量中有限标签故障诊断的潜在动力学自监督框架
1天前浏览6
    故障标签稀缺,是机械智能诊断走向实际应用时经常遇到的难题。本期推荐论文:A latent-dynamics self-supervised framework for limited-label fault diagnosis in cyclostationary vibration measurements,提出信号世界模型(SWM),从无标签振动信号中学习潜在状态之间的演化关系,再利用少量标注样本完成故障诊断。研究将非重叠感受野设计与预测式自监督学习相结合,在多级离心泵和CWRU轴承数据上展现了较好的标签利用效率。对于世界模型与机械故障诊断交叉研究,这篇论文提供了一个具体而有启发的切入点,也为振动信号表征学习带来了新的探索思路。

    论文基本信息

    论文题目:  
    A latent-dynamics self-supervised framework for limited-label fault diagnosis in cyclostationary vibration measurements  
    论文日期:  
    2026年6月2日(online)  
    发表期刊:  
    Array 30 (2026), 100962  
    论文链接:  
    https://doi.org/10.1016/j.array.2026.100962  
    作者:  
    Diego Cabreraᵃ˒*,Mauricio Villacísᵇ˒ᶜ,Fernando Sanchoᶜ,René-Vinicio Sánchezᵇ,Weihua Liᵃ  
    作者单位:  
    ᵃ School of Mechanical and Automotive Engineering, South China University of Technology, Guangzhou, 510640, Guangdong, China.  
    ᵇ GIDTEC, Universidad Politécnica Salesiana, Cuenca, 010105, Azuay, Ecuador.  
    ᶜ Department of Computer Science and Artificial Intelligence, University of Seville, Seville, 41012, Andalusia, Spain.  

    目录

    摘要

    1. 引言

    2. 方法

       2.1. 信号世界模型架构

       2.2. 循环平稳信号与转移规律建模

       2.3. 信号世界模型学习

       2.3.1. 具有状态空间表征的教师—学生范式

       2.3.2. 定义掩码并收集隐藏状态

       2.3.3. 收集预测器的部分状态

       2.3.4. 预测器模型

       2.3.5. 训练目标

       2.4. 面向故障诊断的信号世界模型微调

    3. 实验设置

       3.1. 离心泵案例研究

       3.1.1. 信号采集

       3.1.2. 训练配置

       3.1.3. 数据集准备

       3.2. CWRU轴承案例研究

       3.2.1. 信号采集

       3.2.2. 训练配置

       3.2.3. 数据集准备

       3.3. 硬件与实现细节

       3.4. 架构与训练参数

       3.5. 预训练流程

       3.6. 微调流程

       3.7. 与其他自监督学习方法的比较

    4. 结果

       4.1. 原始表征与所学表征的循环平稳结构

       4.2. 故障诊断性能

       4.3. 与其他自监督学习方法的比较

       4.4. 消融研究

    5. 结论

    小编能力有限,如有翻译不恰之处,请多多指正~

    摘要

    循环平稳信号反映了旋转机械的运行动态,然而,其周期性与随机性相结合的结构以及故障标签的稀缺,阻碍了面向实际状态监测的稳健表征学习。本文提出信号世界模型(Signal-World-Model),这是一个自监督框架,通过将振动分析表述为潜在状态转移问题,为其提供切实可行的解决方案。该架构将卷积编码器、非重叠感受野策略和预测Transformer相结合,在不显式重建信号的情况下推断底层系统动力学。通过教师—学生—预测器范式进行预训练后,模型利用轻量级分类器,仅需极少量标注数据即可适配故障诊断任务。在多级离心泵以及凯斯西储大学轴承案例上的实验验证表明,与具有代表性的对比学习方法、重建方法以及标准联合嵌入预测架构方法相比,该方法取得了一致的性能提升,为严重数据受限条件下的机械监测提供了一条有效途径。

    关键词: 振动测量;循环平稳信号;故障诊断;自监督学习;状态监测;有限标注数据。

    1. 引言

    循环平稳性(Cyclostationarity)是许多物理系统,尤其是工业机械的一项基本特性。在这些系统中,重复冲击、调制激励以及结构周期性会产生统计特性随时间周期性变化的信号[1,2]。这些过程并不具有经典意义上的平稳性,而是在统计矩上表现出周期性;由于运行波动,其周期长度往往未知或随时间变化[3]。这种随机性使常规信号分析显得不足,凸显了对能够捕捉潜在动力学及其时间演化的模型的需求。

    在旋转机械中,循环平稳信号源于机械运行的周期性,例如轴旋转、齿轮啮合周期以及轴承元件通过过程。这些过程会产生以与转速相关的基本周期重复出现的幅值和频率调制。与统计特性保持不变的平稳信号不同,循环平稳信号的一阶和二阶统计量呈现周期性变化,因此,对假定统计行为固定不变的常规分析方法而言,它们尤其具有挑战性。

    在实践中,这一特性在多级离心泵以及基于齿轮和轴承的传动系统等机械中尤为明显,其振动行为可能受到机械磨损、负载变化和非线性耦合的影响[4–6]。开发能够准确表征这些底层过程的模型,对于获得稳健的信号表征至关重要,尤其是在数据稀缺时,从而使故障诊断框架更贴近实际。

    长期以来,人们采用了多种方法分析机械信号,包括傅里叶分析和经验模态分解等经典技术[7]、支持向量机和随机森林等传统机器学习算法[7],以及卷积神经网络和自编码器等现代深度学习方法[8,9]。此外,为应对数据稀缺和域偏移相关挑战,迁移学习策略也得到了广泛研究。近期研究提出了处理含噪样本的通用域适应方法[10]、用于变工况小样本故障诊断的元迁移学习方法[11]、用于新生故障检测的对抗框架[12],以及在测试样本有限条件下用于齿轮箱和轴承故障诊断的增强迁移学习技术[13,14]。尽管这些方法显著改善了模型适应性,但仍存在一些局限,例如依赖源域与目标域之间的相似性,以及在域差异较大时可能出现性能下降。这些局限凸显了对能够直接从工业信号时间结构中学习预测性表征的自监督框架的需求。

    近期自监督学习(SSL)研究利用基于重建的方法[15–18]、对比学习[19,20]以及融合领域信息的方法[8,21],在数据受限场景中展现了巨大潜力。然而,这些方法隐含地假设平稳性,未能充分利用真实工业信号固有的循环平稳特征[9,22,23]。此外,将SSL有效应用于振动数据仍存在尚未解决的重大挑战。由于信号固有的随机性和不确定性,精确重建具有挑战性,基于重建的方法往往因此失效。相比之下,对比方法则因表征空间的高维性而难以构造有意义的负样本[24]。为全面应对这些局限,本文应用SSL,重点通过预测性表征任务对循环平稳信号进行建模。

    近期,证据深度学习和开放集半监督框架等创新方法[25,26],通过显式建模不确定性,并在不依赖传统置信度度量的情况下区分已知与未知故障状态,应对了第一个问题,但仍采用基于对比的方法。与此同时,联合嵌入预测架构(Joint-Embedding Predictive Architectures,JEPA)[27,28]已发展为直接重建或对比比较的可行替代方案。这种方法有效应对了传统SSL技术的局限;然而,正如我们的实验所示,将其直接应用于循环平稳信号会得到较差结果。

    受上述认识启发,我们提出信号世界模型(SWM),专门用于从原始循环平稳信号中提取潜在状态空间表征。与隐含地假定信号结构固定的常规SSL方法不同,我们的方法建立在以下观察之上:机械振动信号表现出由底层物理周期性支配的结构化变异[5]。在多级离心泵等复杂机械中,由于转速波动、负载变化,或阀门引起的水力瞬变及流固相互作用,这些周期性往往会变得不规则或发生畸变[4,6,21]。我们的模型不依赖手工特征或固定周期分段,而是直接从数据中学习这些潜在模式,利用预测机制推断系统内部状态如何演化。这一视角将信号建模本身视为核心挑战,而不是通向分类的一个中间步骤:即学习复杂、含噪且时变的过程如何在多个时间尺度上编码结构[15,22]。

    SWM这一术语采用对世界模型的广义解释,即对一个部分可观测动力系统进行建模,该系统的状态自主演化,或随外部动作及运行工况而演化。这里的世界就是物理机械本身:旋转部件、水力或轴承相互作用、负载工况和健康状态共同定义了一个无法通过单次测量直接观测到的潜在机械状态。因此,循环平稳振动过程是这一状态通过传感器信号表现出的可观测形式。由于机械的演化产生了信号的周期性—随机性结构,因此可以利用该结构推断潜在状态及其时间演化。从这一角度看,学习状态转移规律有利于故障诊断,因为它估计的是机械状态随时间变化的轨迹,而不是仅偏向健康标签的单个特征向量。该状态轨迹捕捉运行动态、周期调制和退化效应如何共同演化,为后续诊断分类器提供更丰富的表征,并减少微调所需的标注数据量。

    本工作的主要贡献概括如下:

    • 提出一种自监督框架,即信号世界模型(SWM),专门用于从循环平稳振动信号中学习预测性潜在状态空间表征,重点捕捉底层时间动力学。
    • 提出一种预测学习策略,通过对连续信号片段之间的潜在转移进行建模,捕捉多尺度时间依赖,从而能够在周期不规则或畸变的情况下提取动力学结构。
    • 设计一种面向振动故障诊断的SSL架构,将非重叠感受野编码器与掩码预测Transformer相结合,以处理真实机械信号的随机性和准周期性。
    • 提出一种数据高效的微调流程,展示如何仅用少量标注数据,将SWM学习到的表征适配于故障分类。
    • 在两个互补案例上进行验证:多种排出压力下的多级离心泵,以及凯斯西储大学(CWRU)轴承基准;采用互不重叠的评估协议,评估有限标签条件下表征的稳健性。

    2. 方法

    信号世界模型(SWM)是一种自监督学习框架,旨在从循环平稳时间序列数据中提取与健康相关的动态表征,直接连接原始振动信号特征与准确故障诊断的要求。其核心原则是学习支配机械演化的内部状态转移映射,从而即使在标注数据有限时也能实现稳健分类。模型由两个主要阶段构成:采用教师—学生架构进行表征学习的预训练阶段,以及将学习到的特征适配于故障诊断任务的微调阶段。

    将自监督学习方法应用于工业信号分析,以应对数据稀缺问题,存在固有局限。这些局限源于其偏向在受限带宽内提取特征,以及信号表征本身固有的不确定性。例如,基于Transformer的自然语言处理模型依赖词元化过程,将词语映射到表征空间中,再通过位置编码对其语义关系进行编码。这一特性无法直接迁移到信号领域。此外,大语言模型(LLM)的训练假定存在有限的词元字典,其概率在有界表征空间中进行估计。

    相比之下,机械振动信号处于一个本质上随机且无限的表征空间。机械部件的每一种健康状态都会引起具有特征性的变化,这些变化跨越短、中或长持续时间,以近似规则的间隔重复出现,但幅值不同。

    由多级离心泵或滚动轴承等旋转机械产生的随机过程    ,若其低阶统计矩随时间周期性变化,则被归类为广义循环平稳过程。

    这种周期变化在物理上由机械事件的重复引起,例如叶轮叶片通过和轴承滚子通过,其基本周期    与转速相关。

    形式上,若    的均值满足    ,则该过程具有一阶循环平稳性。此外,若其时变自相关函数    关于    以相同基本周期    变化,则该过程具有二阶循环平稳性,其中    表示时滞。这种周期性使    可展开为:


    其中,    表示依赖于时滞    的循环自相关函数,    表示循环频率(    的谐波)。这一表达准确捕捉了信号二阶统计量中的周期结构,这一特征被广泛用于分析旋转机械中的振荡过程和近似循环平稳过程[3]。

    尽管振动信号具有循环平稳性,但使参数和自相关趋于稳定的统计周期持续时间仍然未知。因此,标准的基于Transformer的词元化方法不足以处理这类输入,而且由于存在显著不确定性,直接在原始信号表征空间中进行自监督学习也并不合适。

    为应对这些挑战,我们提出了一个专门捕捉低频和高频特征的表征模型(第2.1节)、在不同于原始输入信号的变换表征空间中学习该模型的方法(第2.3节),以及仅需极少样本即可用于诊断任务的微调方法(第2.4节)。
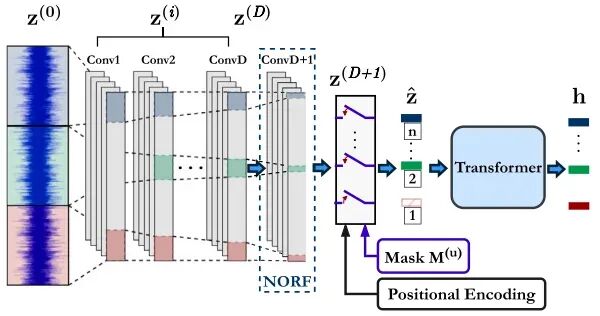
    图1. SWM架构。

    2.1. 信号世界模型架构

    如图1所示,SWM架构包含三个主要模块:编码器(    )、预测器(    )以及微调时使用的轻量级诊断器。该架构专门通过聚焦循环状态转移建模,处理工业信号的时变统计特性。编码器    是一种专门设计的卷积神经网络(CNN),结合了非重叠感受野(Non-Overlapping Receptive Field,NORF)策略。NORF机制将连续信号    划分为一系列非冗余潜在状态    。这种非冗余状态序列对故障诊断至关重要,因为它简化了后续Transformer层的任务。模型必须捕捉定义机械动态健康状态的长程依赖,而不是对高度相关的局部特征进行建模。

    2.2. 循环平稳信号与转移规律建模

    如第1节所述,旋转机械会产生广义循环平稳信号。这种非平稳性给诊断带来了重大挑战,因为常规特征提取方法往往无法分离与健康相关的调制成分。SWM通过学习系统的动态状态转移规律    来解决这一问题,该规律描述潜在状态    如何演化。故障会直接改变这一转移规律,例如在信号的二阶统计量中引入新的周期性或混沌变化。因此,准确预测这一转移规律,可作为异常检测、故障诊断及其他预测与健康管理(PHM)任务的有效代理任务。SWM利用联合嵌入预测架构(JEPA)的原理,通过根据过去的潜在状态预测未来的潜在状态,学习这一动力学。

    前    层采用小卷积核的一维卷积,且步长严格小于卷积核长度。这一选择确保了充分的重叠,避免系统遗漏可能在输入信号    中发生位置偏移的短时模式。通过堆叠多个层,逐步增大感受野,以捕捉中等持续时间的模式。

    令    ,并令    为第    个卷积层的输出,其长度为    、特征维度为    :


    其中,    为激活函数,    为卷积核长度,    为卷积核中各位置    的可训练权重,    为偏置项,    为步长,    为填充量,输出长度由下式确定:


    截至第    层的(累积)感受野为:


    其中,    表示截至第    层的累积步长。

    经过    个卷积层后,模型输出    。这些中间卷积特征的感受野被有意设计为相互重叠,因为这种重叠使编码器能够捕捉可能在输入窗口内发生位置偏移的短时事件。然而,掩码预测任务所使用的最终潜在状态不得共享信号支撑范围。为此,我们提出非重叠感受野(NORF)策略,加入一个额外的状态构造层,其    。该层的步长设置为


    两个连续的最终潜在状态在原始输入坐标中相隔    个采样点。强制满足    ,可防止相邻最终状态共享信号支撑范围;向上取整运算给出满足这一非重叠条件的最小步长,同时尽可能保留更多潜在状态。

    从理论角度看,采用非重叠感受野与本文使用的预测状态空间框架相一致。如第2.3节所述,模型假定未来状态    通过可学习的转移映射    从当前状态    演化而来。这一类马尔可夫假设要求每个状态    编码系统在给定索引    处的一次独立观测。如果允许感受野重叠,则输入信号中的同一局部模式会出现在多个连续嵌入中,即    、    和    ,产生冗余依赖,阻碍清晰状态转移的学习,并引入虚假的时间相关性。

    除这种冗余外,重叠感受野还会在掩码预测目标中引入信息泄漏。当某个片段被遮挡时,其部分原始信号仍可能出现在相邻未遮挡片段的感受野内,使模型能够轻易重建目标,而非学习转移规律    。这会通过允许捷径解而削弱预测目标,并违反每个潜在状态应表示一次独立时间观测的假设。通过NORF策略强制感受野互不重叠,可防止这种泄漏,并确保模型学习有意义的时间动力学,而非依赖局部插值。

    从物理角度看,NORF将每个最终潜在状态定义为对机械响应的一次独立时间观测。前部相互重叠的卷积层能够捕捉冲击、叶片通过响应或轴承相关脉冲等短时事件,而不受其在输入窗口中相位的影响。随后,NORF层将这些编码后的局部模式组织为信号支撑范围彼此不同的潜在状态。

    因此,采用NORF策略后的CNN输出为    ,其中    为非重叠感受野的数量。该层在位置    处的向量计算为


    其中,    ,    。

    为保留位置信息,将正弦—余弦位置编码    加入每个    :


    其中


    式中,    ,    表示将各对元素按顺序拼接。

    如果需要在训练时省略特定片段,可以将掩码    应用于    ,如下所示:


    随后,将得到的序列    输入Transformer,以捕捉这些非重叠片段之间的低频模式:


    其中,每个Transformer模块均包含自注意力层和前馈层。

    SWM生成的潜在状态序列    并非一种抽象表征,而是编码了从振动信号中提取的、与健康相关的时间结构。机械退化表现为周期性、幅值调制、转移稳定性以及短期、中期和长期动力学之间耦合关系的变化。由于这些影响会改变系统底层的状态转移行为,所学习的状态可作为紧凑且具有判别力的描述符,用于识别故障状态。这在第2.1节学习的表征与第2.4节使用的诊断机制之间建立了直接联系,从而将SWM整合到整体故障诊断流程中。

    2.3. 信号世界模型学习

    SWM的预训练目标是学习一种表征    ,使得能够根据机械当前状态准确推断其未来状态。这通过预测损失实现。在该阶段,教师网络(    )为未遮挡的未来信号提供稳定的目标表征,而学生网络(    )必须仅根据可用的掩码上下文预测这些目标。预测损失函数表述为    ,其中    是来自学生的输入,    是来自教师的目标。该目标迫使编码器    内化表征机械运行状态的长程循环依赖。

    SWM定义了一个函数:


    其中,    为掩码中1的数量。我们使用联合信号与状态嵌入以及状态预测,对SWM进行SSL,而不使用健康状态信息。实质上,预训练架构包括:

    1. 学生模型      ,即使用非平凡掩码的SWM。NORF策略避免了卷积感受野之间的平凡重叠。同时,掩码从非重叠感受野中生成部分状态序列。
    2. 教师模型      ,其包含一个使用全一掩码的SWM副本。它处理整个输入信号,不省略任何片段,从而生成完整状态序列。掩码选择被隐藏的状态,并在学生模型中过滤相应的输入信号片段。
    3. 预测器      ,其接收学生的部分状态及掩码,以预测教师模型中的选定状态,从而对底层状态转移动力学进行建模。

    利用这三个组成部分,系统同时学习:(1)循环平稳信号的紧凑状态空间表征序列;(2)如何根据可用状态预测缺失状态,从而有效捕捉底层过程的时间转移。以下各节说明该框架的组成要素及其相互作用。

    2.3.1. 具有状态空间表征的教师—学生范式

    在潜在状态空间中工作,而非直接处理原始振动信号,有助于减轻循环平稳过程固有的高变异性。具体而言,定义潜在状态序列    。我们假定存在底层转移映射    ,使得


    转移关系    通过直接在潜在空间中对机械动力学建模,捕捉系统的潜在演化。每个状态    通过卷积编码器和NORF策略聚合短程、中程和长程时间信息。尽管转移以一阶形式书写,但潜在表征编码了多尺度上下文,因此类马尔可夫近似适用于预测性表征学习。

    遵循联合嵌入预测架构(JEPA)的原理,目标是建模潜在时间演化中的可预测成分。因此,将近似符号形式化为期望意义下的关系:


    其中,    反映编码器容量、噪声水平以及对理想循环平稳性的偏离;这一假设适用于连续非重叠片段之间的短时域转移,而这正是掩码策略所施加的预测情形。教师—学生—预测器架构通过学习支配机械系统的基本动力学,确保被隐藏的潜在状态能够被准确恢复。

    在该框架下,教师模型提供完整潜在状态序列    ,学生则根据二值掩码移除部分状态,生成子序列    。如果预测器能够根据可用状态正确重建缺失状态,则意味着所学习的表征同时捕捉了信号的局部结构及其潜在时间演进,后者近似受    支配。

    需要指出,教师—学生范式提供了一种内在机制,用于验证所学习表征的质量。由于教师接收完整、未遮挡的输入,而学生处理被遮挡的信号,因此学生只有成功推断出支配教师状态序列的潜在转移,才能最小化预测损失    。这意味着预训练目标隐式验证了知识迁移:对隐藏状态的准确预测表明,学生已经内化教师所编码的时间依赖,而非依赖局部相关或平凡捷径。教师参数的EMA更新进一步确保教师提供稳定且一致的目标,使    成为教师—学生对齐程度的有意义指标。

    2.3.2. 定义掩码并收集隐藏状态

    教师与学生模型的差别在于对    应用的掩码。教师输出定义为:


    其中,    为全一掩码。因此,教师看到整个输入,并生成完整状态序列    。

    令    ,其中    ,表示一组    个二值掩码。每个    均包含一个由    个1构成的连续块,其长度依据    的预定比例确定,起始位置随机选择。将    应用于教师输出    ,提取隐藏状态:


    即长度为    的连续块。

    2.3.3. 收集预测器的部分状态

    学生模型不得看到隐藏状态的任何直接证据。因此,取反掩码    (其中    )从输入信号中移除与这些状态对应的片段,NORF策略则阻止通过相邻感受野获取隐藏状态。学生模型按下式应用这些掩码:


    这里,维度    反映了每个隐藏片段均被完全过滤。我们将    称为掩码    对应的预测器状态。

    2.3.4. 预测器模型

    其定义为


    与教师和学生不同,其内部在    维空间中运行。因此,采用两个线性映射处理维度变化:    将预测器状态投影至    维空间,    将预测器输出投影回    维空间。

    令    为按式(6)定义的    维位置编码。对于每个    ,按下式赋值,构造单个序列    :


    其中,    将    映射至    中的对应状态位置(当    时),    为表示隐藏位置的可学习向量。因此,    将部分状态和待预测位置整合到同一个长度为    的序列中。

    随后,应用预测器Transformer:


    只有    的位置对应仍需重建的状态。为将这些输出映射回    维,定义:


    2.3.5. 训练目标

    回顾前文,    与    对应掩码    所指示的位置。因此,预测损失量化为:


    该损失函数记为    ,仅在自监督预训练阶段使用,以最小化教师与学生表征之间的预测误差。

    训练期间,该损失产生的梯度通过    和    传播。然而,教师模型的参数不直接接收梯度,而是通过学生参数的指数移动平均(EMA)更新权重。这一EMA机制确保教师持续提供稳定且有意义的状态目标,防止平凡解,并引导学生和预测器学习稳健的状态空间表征。

    尽管无法直接可视化潜在维度的状态序列,但其一致性通过掩码预测目标得到隐式验证。根据周围上下文成功重建隐藏状态,表明SWM已经内化底层循环平稳过程的时间演化,为所学习表征捕捉的是系统动力学而非片段级伪特征提供了证据。

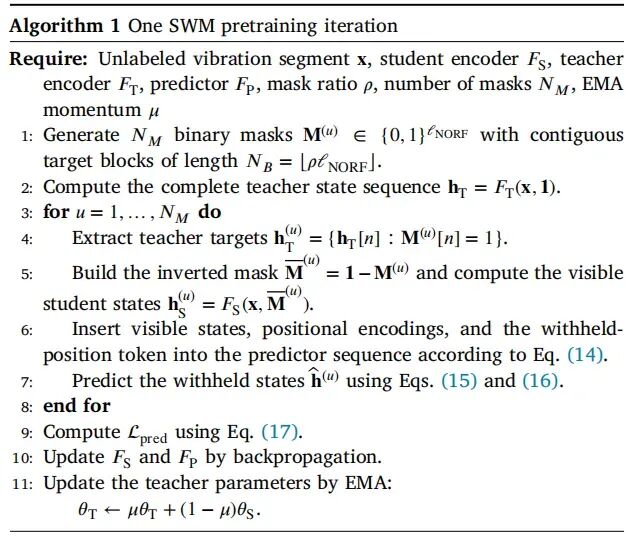
    为明确说明教师—学生—预测器流程,算法1总结了SWM的一次预训练迭代。

    算法1. SWM的一次预训练迭代
    2.4. 面向故障诊断的信号世界模型微调

    这一最终阶段将学习到的状态空间表征与最终分类决策显式联系起来,完成与故障诊断任务的整合。微调期间,冻结预训练SWM编码器(    ),并在其输出端连接一个轻量级分类头(    )。将预训练模型产生的潜在状态序列    作为分类器的高质量特征输入。随后,在有限标注数据集上训练模型,将学到的动态结构    映射到具体故障状态。分类损失(    )优化    ,以利用自监督阶段学到的稳健特征,从而即使监督信息有限也能实现高准确率。采用上述联合嵌入预测架构,在无标签循环平稳信号上对SWM预训练之后,将训练好的    作为稳健的状态空间表征提取器。教师网络与预测器网络在这一微调阶段被弃用。

    我们将微调过程表述为直接在SWM生成的状态序列上执行的分类任务。给定一个仅含有限数量标注训练样本的循环平稳信号标注数据集,该任务需要诊断每个输入信号所对应的底层健康状态。每个标注信号通过    处理后,得到一个状态序列:


    其中,全一掩码确保为整个输入提取状态。

    鉴于标注信号稀缺,分类器必须尽可能少地使用参数,以防止过拟合。因此,我们采用复杂度受限的轻量级卷积分类头。具体而言,该分类器记为    ,设计为浅层一维卷积网络,直接作用于SWM提供的多变量状态序列:


    其中,    为logits,    为待诊断的目标故障类别数。    的简单结构和有限容量确保能够从小规模标注数据集中实现有效泛化。

    为训练这一耦合系统(    和    ),首先冻结SWM参数,在预设训练轮数的预热期间仅优化    。这一预热步骤在不改变先前学到的状态表征的情况下,确保分类头稳定初始化,有利于标注数据稀缺时的收敛性和稳健性。预热阶段之后,联合微调分类器和学生模型参数。两个阶段均采用交叉熵损失,记为    。需要注意,    指自监督预训练阶段所用的预测损失,而    对应监督微调损失。

    每个训练轮次之后,使用一个小规模标注验证集评估分类性能。保留最佳模型,即获得最高验证准确率的模型,用于后续诊断评估。图2总结了预训练、微调和诊断阶段。
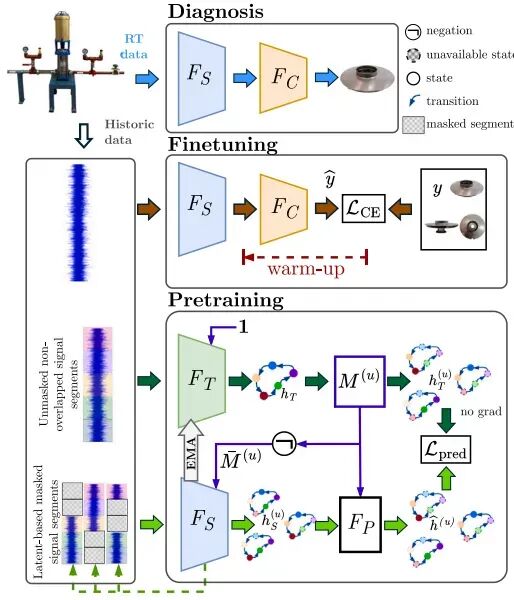
    图2. 工业机械在数据稀缺条件下的故障诊断方法流程。

    3. 实验设置

    开展两个互补案例研究,一个基于离心泵,另一个基于公开可用的CWRU轴承数据集,以评估所提出SWM表征在有限标注数据条件下的稳健性。

    3.1. 离心泵案例研究

    在第一个场景中,使用图3所示实验平台采集的数据评估所提出模型,其主要部件是一台Gulf®品牌、型号为3SV10GE4F20的十级立轴离心轴流泵。

    3.1.1. 信号采集

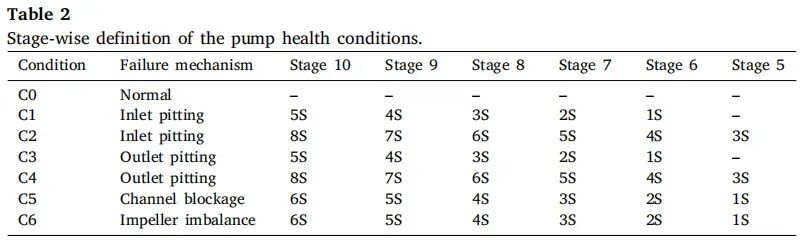
    使用安装在泵壳上的IMI Sensors 603C01加速度计采集振动信号,并通过美国国家仪器公司(NI)的NI9234 CompactDAQ采集卡,以50 kHz采样率进行数字化。测试的健康状态包括一种正常模式C0和六种故障模式C1–C6,代表多级离心泵系统中四种与叶轮相关的故障:叶片前缘(入口)点蚀、叶片后缘(出口)点蚀、叶轮流道堵塞和叶轮不平衡。泵共有10级,在选定叶轮上引入了不同严重程度的故障。

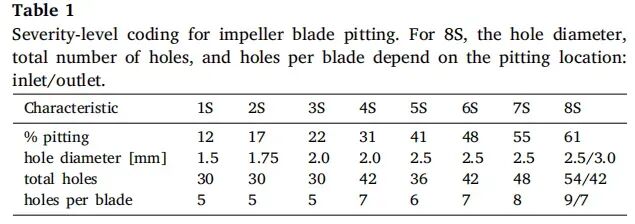
    严重程度索引S是一种简洁记号,但其物理含义取决于故障机理。对于叶轮叶片点蚀,1S–8S表示逐渐增大的点蚀严重程度,其量化结果见表1。对于叶轮流道堵塞,1S–6S表示被堵塞流道的数量。对于叶轮不平衡,1S–6S分别表示0.3、1.2、2.5、2.8、3.8和5.1的不平衡百分比,这些不平衡通过表面切削获得。

    表1. 叶轮叶片点蚀的严重程度等级编码。对于8S,孔径、总孔数以及每片叶片上的孔数取决于点蚀位置:入口/出口。
    各级故障配置汇总于表2。C0对应正常状态。C1和C3包括第10–6级的点蚀,其严重程度依次为5S–1S;C2和C4包括第10–5级的点蚀,其严重程度依次为8S–3S。C1–C2对应入口点蚀,C3–C4对应出口点蚀。C5包括第10–5级的流道堵塞,严重程度依次为6S–1S;C6包括第10–5级的叶轮不平衡,严重程度依次为6S–1S。未列为故障的所有级均保持健康状态。

    表2. 泵健康状态的逐级定义。
    所有信号均在电机旋转频率恒定为60 Hz的条件下采集,通过排出压力工况改变水力负载:5.5 bar、6.5 bar、7.5 bar、8.5 bar和9.5 bar分别记为O1–O5。在每种工况下,对每种健康状态进行10次重复测量,记为R1–R10。每次测量持续10 s,产生包含500000个采样点的振动信号。
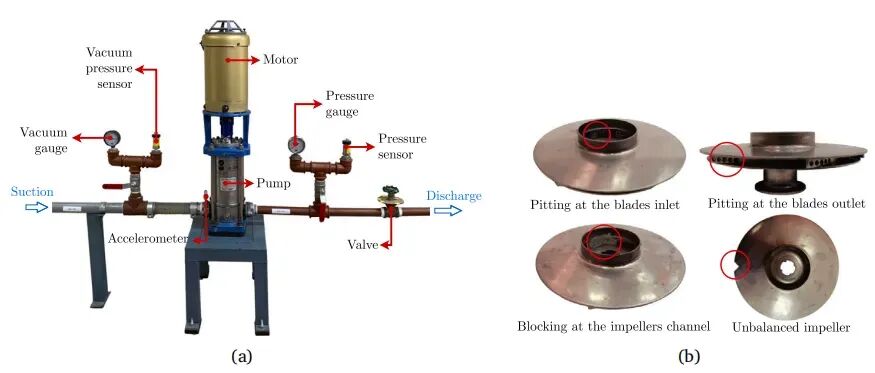
    图3. 实验平台以及在泵叶轮上引入的机械故障。

    3.1.2. 训练配置

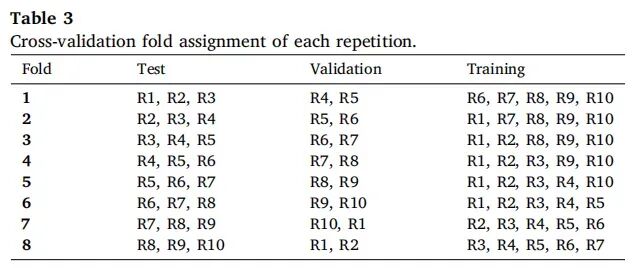
    在工业机械中,即使健康状态和受控工况相同,设备升温、环境温度变化以及部件磨合稳定等变化也会使不同重复测量之间产生信号变异,从而影响故障诊断性能。减轻这种影响的典型做法,是使用所有可用重复测量中的样本训练模型。然而,这会高估模型的稳健性,因为在真实场景中,无法获得涵盖所有可能变化的重复测量。因此,我们提出按照重复测量索引,将数据集划分为互不重叠的训练集、验证集和测试集,以评估模型对这些变化的稳健性。为此,实施了8折交叉验证方案。如表3所示,将互不重叠的重复测量分配给不同子集:5次用于训练、2次用于验证、3次用于测试。

    表3. 各次重复测量在交叉验证中的折分配。
    3.1.3. 数据集准备

    将长振动信号切分为长度固定为8192个采样点的样本。预训练采用500个采样点的步长,在一个训练折内,为每种健康状态与工况组合生成4920个无标签样本。微调时,通过改变训练步长,控制同一工况下同一健康状态的标注样本数量:500000、250000、100000和50000个采样点的步长分别产生5、10、25和50个标注样本。这些数量分别对应相应预训练样本数的0.10%、0.20%、0.51%和1.02%。验证采用100000个采样点的步长,测试采用互不重叠的8192个采样点步长。

    3.2. CWRU轴承案例研究

    第二个评估场景基于公开可用的凯斯西储大学(CWRU)轴承数据集[29]。该数据集采集自一套电机驱动试验台,配备2 HP电机、转矩传感器、测功机以及通过电火花加工引入人工故障的滚珠轴承。本研究采用四种工况,记为O1–O4,分别对应0 HP、1 HP、2 HP和3 HP的电机负载,以及1797 rpm、1772 rpm、1750 rpm和1730 rpm的标称轴转速。

    3.2.1. 信号采集

    利用安装在不同位置的加速度计测量振动信号:驱动端(DE)、风扇端(FE)和底座(BA)。本研究仅使用以48 kHz采样的DE信号,因为这些信号直接反映轴承健康状态,并且在所选故障案例中均可获得。

    数据集包含10种健康状态:正常运行(C0)以及按故障位置和缺陷直径定义的九种故障状态(C1–C9)。故障分为外圈(C1–C3)、内圈(C4–C6)和滚动体(C7–C9)故障,每组均按缺陷直径从大到小排序,依次为0.533 mm、0.356 mm和0.178 mm。这些标签与O1–O4工况组合,定义了健康状态/运行工况对,记为C-O对,并贯穿微调和评估协议使用。

    将与给定C-O对关联的每条CWRU记录划分为三个等长、互不重叠的时间分区,记为R1、R2和R3。这些分区是从同一记录中提取的互不重叠时间片段。

    3.2.2. 训练配置

    在时间分区R1–R3上采用3折评估方案。在每一折中,一个分区用于训练,一个用于验证,一个用于测试,并在各折之间轮换分配,遵循与泵案例中按重复测量互斥划分协议相同的思路。该协议保持每个C-O对内部的训练、验证和测试子集在时间上互不重叠,同时评估中仍包含所有O1–O4工况。

    3.2.3. 数据集准备

    遵循与离心泵案例相同的预处理流程,将每个时间分区切分为8192个采样点的固定长度样本。预训练采用100个采样点的步长,为一个折的训练分区中的每个C-O对最多生成1557个无标签样本。微调时,32768、16384、8192和4096个采样点的步长,分别为每个C-O对最多生成5、10、19和38个标注样本。对于最长的C-O记录,这些预算分别约为相应预训练样本数的0.32%、0.64%、1.22%和2.44%。验证采用互不重叠的8192个采样点步长,测试采用200个采样点步长进行密集评估。

    3.3. 硬件与实现细节

    为确保可复现性以及所有模型之间的公平比较,全部计算评估均在一台Linux工作站上完成,该工作站配备具有32 GB显存的NVIDIA GeForce RTX 5090 GPU,以及128 GB DDR5内存。我们在CUDA 13.0环境下使用Python 3.13.8实现SWM并评估各基线,确保所有耗时和复杂度分析的软件与硬件条件相同。

    3.4. 架构与训练参数

    所提出的SWM包括两个主要阶段:采用NORF策略提取局部特征的卷积前端,以及捕捉长程依赖的Transformer模块。

    卷积阶段由六层组成,详见表4。所有卷积层均采用ReLU激活,以及不含仿射变换的独立通道归一化。

    表4. SWM架构。
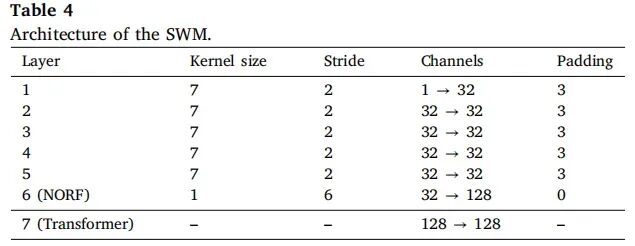
    前五层采用统一步长(    )和卷积核(    ),这是一个核心架构偏置。统一为2的步长确保时间维度逐层以2倍因子呈指数式递减。这一机制对于将长输入信号(8192个采样点)高效压缩为最终可处理的潜在状态序列至关重要,这些状态将特征空间组织成不同的层次。此外,选择大小为7的卷积核,是为确保显著重叠()。这种重叠对于捕捉高度局部化、否则可能遗漏的短时冲击模式是必要的,从而最大限度地扩展后续NORF层所需的累积感受野(最高达到    个采样点)。

    该配置使最终层之前的累积感受野达到    个采样点。总累积感受野(截至NORF输出)为    个采样点,累积步长为    。

    因此,如表4所示,NORF层步长设为    。应用NORF策略后,每个输入信号由此产生    个非重叠感受野。

    Transformer模块被视为SWM的第七层,处理加入固定正弦和余弦位置编码后的序列。它包含一个注意力头、一个编码器层、128的嵌入维度,以及具有2048个单元的前馈网络。该模块采用ReLU激活和注意力后层归一化,使模型能够在保持计算效率的同时捕捉信号中的全局依赖。

    预测器与SWM Transformer采用相同的结构配置。然而,它使用降至16的嵌入维度,以有意限制其表征容量。由于预测器无法独自承担预测任务,这一设计促使SWM学习信息更丰富、泛化性更强的表征。

    3.5. 预训练流程

    预训练使用AdamW优化器及余弦衰减学习率调度,学习率从    开始,衰减至    。采用余弦衰减调度的AdamW优化器遵循联合嵌入预测架构[28]所用的配置,从而稳定收敛并减轻早期过拟合。这里采用同一训练方案,确保训练动态平滑,并与既有JEPA实践保持一致。

    权重衰减从0.04线性增加至0.4。训练进行100轮,批大小为512。教师网络采用动量为0.9996的EMA更新。

    块长度基于    的50%预定比例,设为    。二值掩码数量    为4。

    3.6. 微调流程

    微调阶段使用轻量级卷积分类器,评估自监督预训练所学表征的质量,同时避免在有限标注数据下过拟合。

    分类器由具有两个卷积层的浅层一维卷积探针组成,输出通道数为    ,每层卷积核长度为7、步长为2。每个卷积之后接ReLU激活。与预训练配置一致,不采用批归一化。卷积堆叠之后接自适应最大池化层,用于聚合时间信息,再接一个全连接层,将提取的特征映射到故障类别。

    该分类器有意采用较低参数量,约为    数量级,以确保诊断性能主要反映所学状态空间表征的结构和质量,而非分类器容量。

    训练分两个阶段进行:前50轮仅训练分类器,冻结SWM,实际作为预热阶段。随后,解冻SWM和分类器,再联合训练50轮。所有模型均训练100轮。由于标注样本稀缺,每个阶段的轮数限制为50轮。超过这一轮数后,模型开始过拟合。

    3.7. 与其他自监督学习方法的比较

    与具有代表性的SSL基线和控制模型进行比较,涵盖基于重建的学习、联合嵌入预测学习、孪生学习、信号对比学习以及无预训练的监督学习。重建组包括卷积重建模型(R-Conv)[31]、高斯去噪模型(R-Denoise)[32]、信号掩码重建模型(R-Mask)[15]以及基于NORF的完整重建模型(NORF-Recon)。联合嵌入预测组包括源自视觉的JEPA变体(JEPA-B、JEPA-L和JEPA-H)[27]。孪生组包括SimSiam[30]和朴素孪生(Naive Siamese)基线。信号对比组包括DA-VICReg[33]和CPLI[34]。无预训练监督模型SWM-NoPre采用相同的SWM骨干,但不进行自监督预训练。

    为确保公平比较,所有模型均采用前文所述的相同数据划分和配置进行训练。所实现基线的主要特征概括如下。

    • SWM-NoPre: 从随机初始化开始,仅用标注微调数据训练相同的SWM骨干和卷积诊断探针。该控制模型在相同下游架构下量化自监督SWM预训练的贡献。
    • DA-VICReg: 受用于故障诊断的DA-VICReg[33]启发的SSL基线。它使用与SWM相同类别的一维编码器,并在振动样本上优化包含不变性、方差和协方差项的联合嵌入目标。
    • CPLI: 受CPLI[34]启发的多任务SSL基线。它仅使用原始振动输入,将对比相似性学习与通用时域变换的辅助预测以及样本内时间关系推理相结合。
    • NORF-Recon: 基于SWM卷积—NORF表征流程构建的受控重建基线。它将教师—学生潜在转移目标替换为经过信号重建训练的解码器,同时保持诊断器不变。该基线用于评估诊断增益是否主要来自预测性潜在状态学习,而非仅来自NORF状态构造。
    • R-Conv: 六层卷积编码器后接转置卷积解码器。编码器采用卷积核大小为7、步长为2的层,之后投影到潜在表征。训练期间不向输入信号添加噪声。
    • R-Denoise: 训练时向整个输入信号添加高斯噪声。测试了0.1至3.0范围内的标准差,发现0.25的重建性能最佳。评估了1–5层的解码器变体后,选择解码器架构。
    • R-Mask: 仅向输入信号的随机区段添加高斯噪声。标准差采用1.0,对四个各含1024个采样点的片段施加噪声。该配置确保输入信号约50%受到扰动,与基于JEPA方法所用的掩码比例一致。
    • SimSiam: 采用SimSiam框架,这是一种基于孪生网络的自监督学习方法,通过停止一个分支中的梯度传播防止坍塌,无需负样本对或动量编码器。我们的实现包含投影器和预测器模块,并采用已发表的振动领域配置,包括高斯噪声、幅值缩放、平移、直流偏移和      轴翻转。这些增强作为通用振动领域方案使用:高斯噪声近似传感器和环境噪声;幅值缩放近似与增益或负载相关的幅值变化;平移考虑循环事件的相位偏移;直流偏移建模传感器偏置变化;符号反转考虑加速度计极性或信号调理约定。未针对泵优化增强策略,因为这会向基线引入额外的领域专用设计。
    • Naive Siamese: SimSiam架构的一种变体,同时移除预测器模块和投影头。该基线用于检验预测器所提供的冗余削减机制以及显式投影步骤的必要性。为确保实验一致性,该模型采用文献[30]定义的相同五种数据变换。

    4. 结果

    4.1. 原始表征与所学表征的循环平稳结构

    为验证诊断实验所用信号的循环平稳结构,我们按照文献[1]的框架,分析原始振动信号包络的循环功率。根据各数据集的频率成分和采样条件选择带通范围:泵信号采用100–10000 Hz,以保留宽带机械调制并去除极低频趋势成分;CWRU采用500–12000 Hz,以突出轴承包络分析中常用的共振频带。这些带通范围定义了用于包络提取的载波频带,而循环频率轴量化所提取包络的周期调制。因此,在5至2000 Hz范围内计算原始循环功率曲线。对于泵,采用65536个采样点的片段长度,因为原始记录较长,可以获得更精细的循环频率分辨率;对于CWRU,采用8192个采样点,以便在每条较短的重复信号内保持足够片段。利用100条随机相位替代曲线和第95百分位阈值评估显著性。图4针对每种受评估状态组合,给出在所展示的5至300 Hz循环频率范围内,循环功率统计量除以相应替代阈值后超过1的信号百分比;该范围包含具有物理意义的调制频带。对预训练编码器提取的SWM潜在轨迹应用相同的超阈判据。

    原始信号分析证实,两套数据集均包含一致的循环平稳成分:86.3%的泵信号和85.0%的CWRU信号超过替代阈值。在泵原始图中,45–56 Hz和88 Hz附近出现明显超阈频带,204 Hz和269 Hz附近还存在其他分量。在CWRU数据中,主要超阈频带位于23–35 Hz、58.6 Hz、105.5 Hz和158.2 Hz附近,与轴转速相关分量及轴承调制分量一致。潜在表征图并未复现原始信号中的每一个窄带峰值,但仍保留随状态组织的结构,表明在没有显式注入循环频率特征的情况下,SWM表征将循环信息保留并重新组织为循环平稳潜在状态轨迹。特别是,泵潜在表征图突出了57 Hz附近的频带,接近预期的旋转基频分量,说明SWM能够对原始超阈图中不占主导地位的机械周期调制重新赋权。
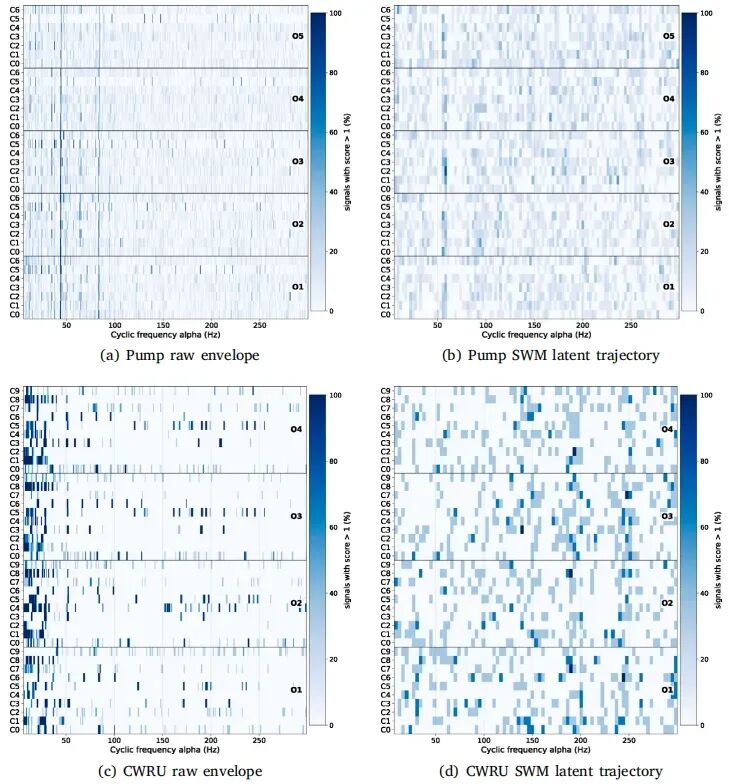
    图4. 原始包络信号与SWM潜在状态轨迹的循环平稳结构。

    图5通过展示SWM学习过程的稳定性,补充了循环平稳性分析。图5(a)表明,预测损失    在预训练期间下降,说明模型逐步学会根据可见状态序列预测被隐藏的潜在状态。图5(b)表明,各训练批内经过    归一化的潜在状态向量之间的相似度下降,并稳定在较低水平,这支持不存在表征坍塌的判断,并说明所学状态序列保持多样性。这种多样性也体现在图4的潜在表征超阈图中。
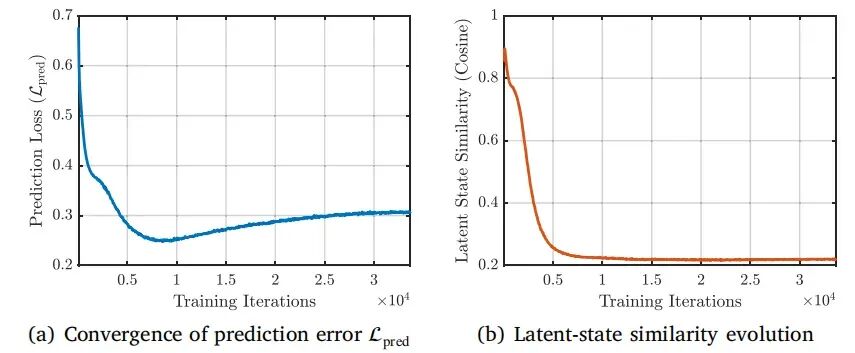
    图5. SWM训练动态。(a) 预测误差的收敛表明转移规律得到有效学习。(b) 持续保持较低的潜在状态相似度表明潜在状态之间的冗余较低。

    4.2. 故障诊断性能

    对于离心泵案例,表5给出了SWM在最大标注样本设置下的汇总混淆矩阵及各状态指标。矩阵呈现显著的对角分布,各状态F1分数介于0.957至0.999之间,宏平均精确率、召回率和F1分数均接近0.980。这证实所学状态表征能够在各折之间高度一致地区分七种泵健康状态,同时保留足够的状态级细节,以识别仍然存在的故障模式重叠。

    主要歧义是将轻度入口点蚀(C1)预测为正常(C0),这与5S–1S点蚀配置的微弱振动特征一致。第二处歧义出现在健康与不平衡的边界,C0和C6存在部分混淆,表明在某些水力负载下,不平衡会产生与健康运行相重叠的幅值调制响应。较少的C4–C6错误进一步表明,出口点蚀与不平衡相关的调制模式存在部分重叠。

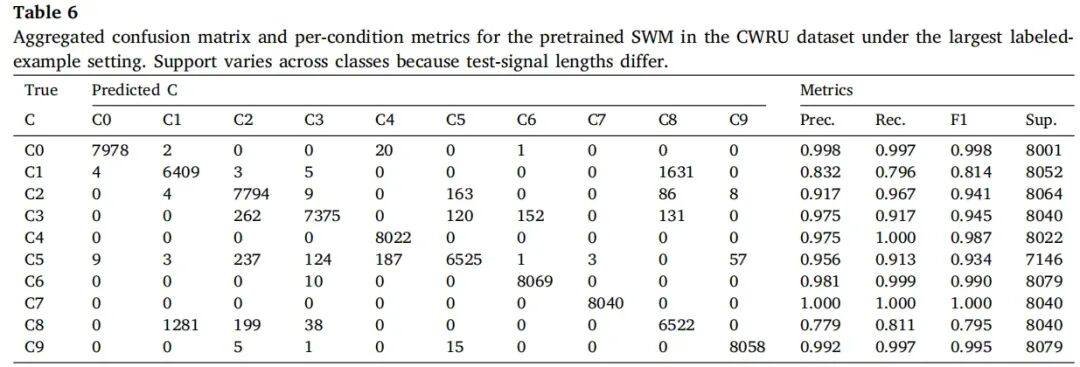
    对于CWRU数据集,表6汇总了SWM在最大标注样本设置下的混淆矩阵及各状态指标。大多数轴承状态均取得较高性能:C0、C4、C6、C7和C9的F1分数至少为0.987,而C2、C3和C5保持在0.93以上。主要性能下降出现在C1和C8,F1分数分别为0.814和0.795。C1为缺陷直径0.533 mm的外圈故障,而C8为缺陷直径0.356 mm的滚动体故障,因此,这种混淆并非发生在同一故障类别的相邻严重程度之间。然而,两种缺陷均可通过相同的轴承—轴承座传递路径激发强烈的冲击响应,因此,相比与故障位置相关的更精细循环结构,潜在分类器可能更重视共有的冲击和共振模式。这一解释与错误的局部集中模式一致,因为C4、C6、C7和C9仍然具有很高的可分性。

    表5. 泵案例中预训练SWM在最大标注样本设置下的汇总混淆矩阵及各状态指标。所有行的支持样本数相同,均为7320个测试样本。
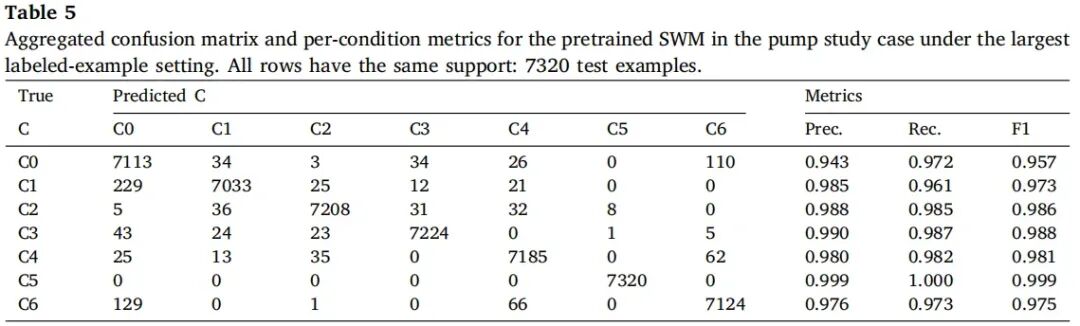
    表6. CWRU数据集中预训练SWM在最大标注样本设置下的汇总混淆矩阵及各状态指标。由于测试信号长度不同,各类别的支持样本数不同。
    4.3. 与其他自监督学习方法的比较

    图6比较了随着每个C-O对的标注微调样本数量增加,各受评估方法在两个案例中的宏平均F1。SWM在两个数据集及所有标签预算下均保持为最优方案,表明其稳健性并不局限于单一机械类型。

    在泵案例中,各方法之间的差异最为显著。SWM在5个样本时即达到    的宏平均F1,并在50个样本时升至    ;而SWM-NoPre即使在最大预算下仍处于较低水平。这一差距表明,仅靠微调无法从稀缺标注样本中恢复状态结构;有用信息主要由预训练引入。与NORF-Recon的比较同样具有启发性:NORF-Recon达到    ,证实基于NORF的时间组织能够捕捉相关信号结构,但其与SWM持续存在的差距表明,重建原始信号不如预测潜在状态转移有效。这与泵信号的特点一致,其诊断信息包含在重复水力响应和机械响应随时间演化的方式之中。

    其余泵基线的表现进一步阐明了自监督任务的作用。R-Conv仅在标签更多时才具有竞争力,在最大预算下达到    ,说明重建能够保留有用的低层信息,但需要监督阶段将这些信息组织为具有故障判别力的结构。R-Denoise和R-Mask的表现仍低于R-Conv,表明对原始信号施加扰动并不会自动产生与泵健康状态相一致的不变性。CPLI、SimSiam、Naive Siamese和DA-VICReg的性能较低或波动更大,因为其学习信号依赖通用增强、变换标签或全局嵌入约束,这些因素并不专门关联循环平稳机械响应的潜在时间演化。JEPA变体保持在接近随机的水平,表明更大的源自视觉的预测模型无法弥补其在一维振动信号中较弱的归纳偏置。JEPA变体出现零标准差,是因为在共同训练预算下,各折均坍塌到相同的、接近随机的决策状态。

    在CWRU中,由于轴承试验台信号呈现更标准化的冲击响应,性能格局有所不同。SWM从5个样本时的    提升到38个样本时的    ,但在最大预算下,CPLI、R-Mask、NORF-Recon和R-Denoise接近SWM。这种趋同表明,当故障特征更加规则且可用标签更多时,基于重建和对比的目标能够提供足够的局部信息,使诊断器区分不同状态。低标签情形对于评估表征质量仍具有更强区分力:在5个样本时,SWM仍然领先且稳定性更好,而NORF-Recon和CPLI分别达到    和    。

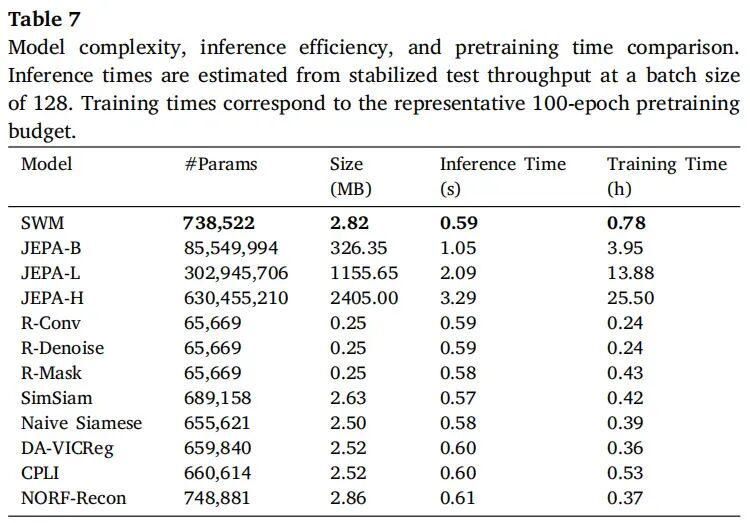
    表7从复杂度角度比较了泵案例中的各方法。JEPA系列比其他方法大数个数量级,但在两个数据集上均发生坍塌,说明当架构与一维振动动力学不匹配时,仅靠容量并不足够。相反,轻量级重建探针成本较低,但更依赖标注微调才能形成判别能力。SWM的参数预算紧凑,推理成本与其他卷积或孪生式方法相当,而其预测性潜在状态目标在低标签和跨数据集情况下提供了更强的稳定性。
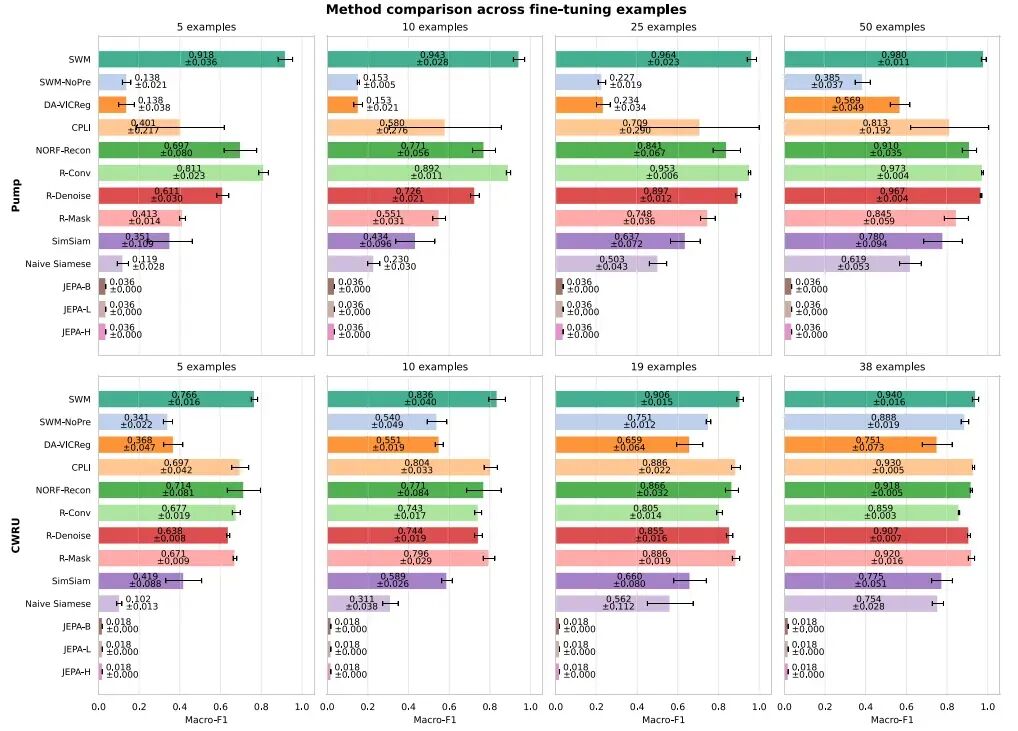
    图6. 自监督表征学习方法的标签效率比较。

    表7. 模型复杂度、推理效率和预训练时间比较。推理时间根据批大小为128时稳定后的测试吞吐量估计。训练时间对应具有代表性的100轮预训练预算。
    4.4. 消融研究

    我们开展消融研究,以确定各个架构和训练组成部分对SWM表征学习的贡献。所有变体均采用与原始SWM相同的数据划分、输入长度、优化器设置、预训练预算、微调预算和诊断器。所评估的修改包括:

    • Norm-first: 将Transformer的归一化顺序从后归一化改为前归一化,在注意力模块之前应用层归一化。
    • No-attention: 移除卷积—NORF编码器之后的Transformer注意力层,使预测器接收到未经全局自注意力混合的潜在状态。
    • Prop. 20%和Prop. 80%: 将用作预测目标的连续隐藏NORF状态比例,从默认50%分别改为20%和80%。
    • EMA-0: 将EMA系数设为0.0,禁用教师编码器的指数移动平均更新,使教师在每次更新时直接跟随学生参数。
    • SWM w/ Overlap: 为验证NORF策略的必要性,将其替换为卷积核大小7、步长6、填充3、膨胀率1的卷积层。该变体保留43个潜在状态的相同输出长度,同时增加相邻潜在状态之间的信号重叠。
    • Patch Emb.: 用单个非重叠卷积层替换多层层次化CNN编码器。该配置保持相同的NORF特性并保留43个潜在状态,但移除了层次化局部特征结构。
    • Depth 2、Depth 3和Depth 5: 将Transformer编码器深度从默认单层增加至2、3和5个注意力层,以测试额外的序列建模容量是否改善所学转移表征。
    • Block-shuffle: 预训练期间,将每个输入序列划分为与潜在状态序列所用相同的43个时间块,并在教师—学生预测任务之前,以1.0的概率针对每个样本独立地随机打乱这些块。这种方法破坏了循环平稳结构所依赖的原始时间顺序,从而检验与所提出框架固有的序列建模能力相比,这种顺序的重要性。

    图7给出了在不同微调预算下,SWM宏平均F1对这些架构和训练选择的敏感性。当预测任务失去稳定的时间参照时,性能下降最为明显。在每个C-O对5个样本时,这一效应最为清楚:SWM在泵和CWRU上分别达到    和    ,而EMA-0分别达到    和    ,Block-shuffle则分别仅达到    和    。在最大预算下,EMA-0在泵上提升至    ,在CWRU上提升至    ;Block-shuffle则分别达到    和    。这种部分恢复表明,标注样本能够弥补部分损害。不过,低预算结果说明,SWM的标签效率高度依赖EMA目标,以及对潜在状态循环平稳演化的保留。

    掩码比例结果表明,预测任务必须在难度与可见上下文之间取得平衡。Prop. 20%在整个预算范围内均接近SWM,在泵上从    提升至    ,在CWRU上从    提升至    。Prop. 80%在泵上从5至50个样本时始终表现较弱,仅从    提升至    ,原因是过多潜在轨迹被隐藏,预测器必须依据不足的上下文推断机械动力学。同一设置在CWRU上的改善更为稳定,从    提升至    ,但在每个预算下仍低于SWM,这与轴承故障产生更规则的冲击模式、能够从更少可见状态中恢复的特点一致。

    SWM w/ Overlap和Patch Emb.表明,在标签稀缺时编码器设计尤其重要。在泵上,5个样本时二者分别从    和    起步,远低于SWM的    ,且在最大预算下仍显著偏低,最终分别为    和    。SWM w/ Overlap使相邻潜在状态共享大部分信号支撑范围,使预测任务倾向于利用信息泄漏。与此同时,Patch Emb.保留片段分离,却移除了在构造潜在状态之前用于编码冲击、调制和宽带机械响应的渐进式卷积层次。在CWRU中,随着标签增多,这些变体恢复了更多性能,尤其是SWM w/ Overlap从    提升至    ,这表明监督信息能够提供部分补偿,并且对于规则的轴承冲击,对完整层次化NORF设计的依赖较低。

    与注意力相关的消融表明,少量序列建模是有用的,但额外深度并非性能的主要驱动因素。在5个样本时,No-attention在泵上达到    ,在CWRU上达到    ,说明在监督稀缺或状态区分依赖状态位置之间关系时,注意力有助于组织潜在状态。在泵上,No-attention在50个样本时达到    ,表明标注数据充足时,NORF编码器已经能够捕捉大部分用于泵状态判别的信息。在CWRU中,即使有38个样本,差距依然较大,此时No-attention达到    。Depth 2和Depth 3始终低于单层SWM,但仍可用。相比之下,Depth 5是本评估中最不利的深度变体,在泵上仅从    提升至    ,表明更深的注意力堆叠增加了优化和过参数化负担,却未改善状态转移表征。

    Norm-first从最低预算起就接近SWM,在5个样本时,泵上分别为    与    ,CWRU上分别为    与    。在泵上,从10个样本起它略高于SWM,并在最大预算下达到    ;在CWRU上,它在较高预算下仍略低于SWM。这说明归一化顺序会轻微影响优化细节,但对整体性能的影响属于次要因素。
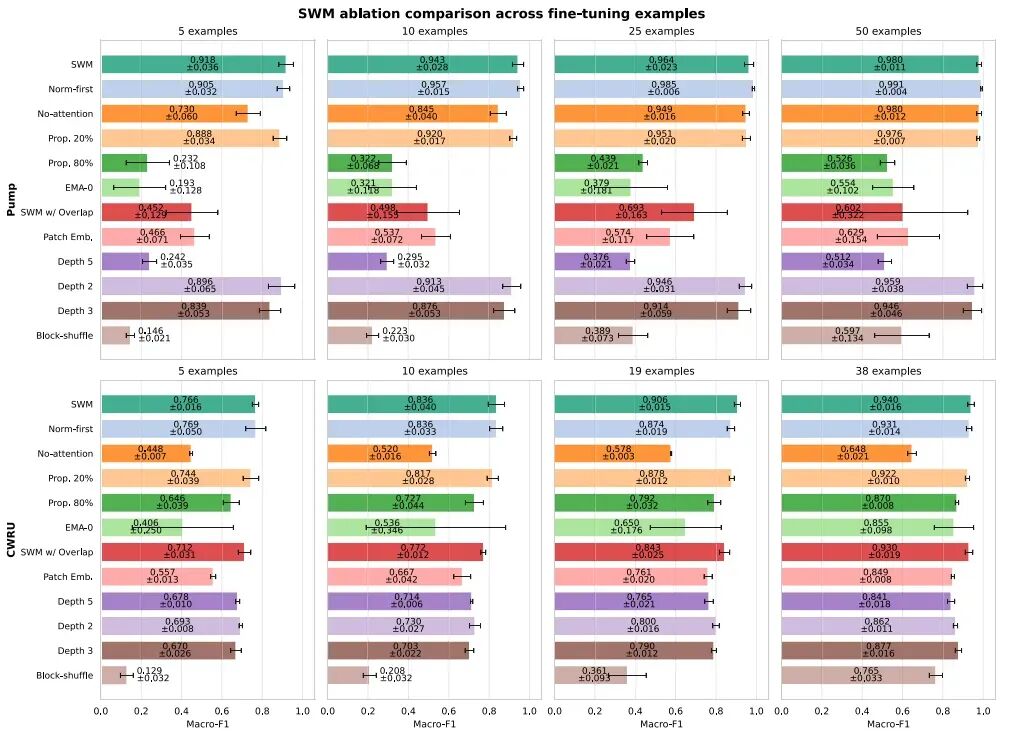
    图7. SWM主要设计组成部分的消融分析。

    5. 结论

    本工作提出了信号世界模型(SWM),这是一种通过预测性潜在状态转移对循环平稳信号建模的自监督学习框架。该方法应对三个主要挑战:(i)表征工业信号中的多尺度模式;(ii)开发克服基于重建和对比方法局限的预训练策略;(iii)在标注数据极度稀缺时实现故障诊断。

    所提出模型架构将卷积编码器、非重叠感受野策略和轻量级Transformer模块相结合。这使模型能够同时捕捉局部信号特征和长程时间依赖。在不依赖人工分段或先验周期知识的情况下,模型在受评估工况和互不重叠的数据划分中表现出稳健性能。

    SWM在CWRU轴承基准以及更复杂的离心泵试验台上,均在标签严重稀缺的条件下表现出较强性能。在后一个案例中,信号受到局部故障、不同叶轮间严重程度变化以及水力负载变动的影响,SWM仍在故障诊断任务中保持较强性能。这表明模型能够从含噪循环平稳信号中学习底层过程动力学。

    SWM优于其他自监督方法,包括基于重建的模型、基于JEPA的变体、现代孪生式和对比基线,表明预测性状态转移学习为循环平稳振动信号提供了更可靠的归纳偏置。这一优势来自SWM应对输入信号不确定性的能力,而其他方法的表征质量则出现明显下降。此外,极少标注数据的微调流程在诊断任务中有效发挥作用,进一步强化了该方法的实际适用性。

    消融研究表明,Transformer深度、掩码比例、注意力结构、目标网络更新速率、非重叠感受野的使用,以及层次化卷积编码均对性能产生显著影响,其中最稳定的配置是采用后归一化和适中掩码比例的浅层Transformer。

    本研究也存在一些局限,为未来研究提供了方向。实验在两个机械案例的受评估工况设置下开展,不应将其解读为对未见工况的全面验证。特别是,变转速运行、留一工况评估协议以及更广泛的跨机械迁移仍是开放问题。未来工作应将SWM扩展至变转速和强非平稳情形,可考虑采用阶次跟踪、时间扭曲或变转速循环平稳分析。其他方向包括融合振动与声学、电气、热学或控制器信号的多模态扩展,以及面向长期工业监测的在线适应、不确定性估计和开放集故障识别。

    编辑:Kira
    校核:李正平、陈凯歌、Leo、曹希铭、赵学功、白亮、任超、海洋、陈宇航、Tina、王金、赵诚、肖鑫鑫、张优
    该文资料搜集自网络,仅用作学术分享,不做商业用途,若侵权,后台联系小编进行删除
    来源:故障诊断与python学习
    ACTMechanical振动非线性旋转机械通用航空python海洋声学理论电机GID传动多尺度创新方法
    著作权归作者所有,欢迎分享,未经许可,不得转载
    首次发布时间:2026-11-13
    最近编辑:1天前
    故障诊断与python学习
    硕士 签名征集中
    获赞 88粉丝 155文章 348课程 0
    点赞
    收藏
    作者推荐

    基于知识-数据驱动物理信息神经网络的数字孪生铣削智能刀具磨损监测模型

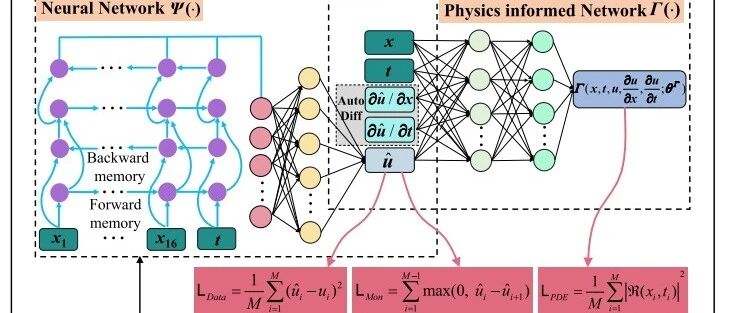
    本期分享发表于一区Top期刊MSSP的论文,基于知识-数据驱动物理信息神经网络的数字孪生铣削智能刀具磨损监测模型。针对现有刀具磨损监测模型主要从平均意义上考虑磨损过程约束,无法严格保证其符合潜在物理机制。文章面向铣削过程的数字孪生智能监测,提出一种融合知识-数据驱动的物理信息神经网络的 TWM 模型。在考虑磨损演化过程单调性的基础上,将磨损率变化的潜在机理作为硬物理约束,用于构建物理信息损失。并通过引入具有明确物理意义的知识偏差,引导神经网络学习过程,确保模型输出映射到严格遵循物理机理的值域中,从而提高物理一致性。论文链接:通过点击最左下角的阅读原文进行在线阅读及下载。论文基本信息论文题目: An intelligent tool wear monitoring model based on knowledge-data-driven physical-informed neural network for digital twin milling论文期刊: Mechanical Systems and Signal Processing论文时间:2025年作者: Xiaohui Fang(a,b,c), Qinghua Song(a,b,c,d*), Xiaojuan Wang(a,b,c), Zhenyang Li(a,b,c), Haifeng Ma(a,b,c,d), Zhanqiang Liu(a,b,c,d,e)机构:a School of Mechanical Engineering, Shandong University, Jinan 250061, PR Chinab Shandong Key Laboratory of High Performance Tools and System, Jinan 250061, PR Chinac Key Laboratory of High Efficiency and Clean Mechanical Manufacture of Ministry of Education, Jinan 250061, PR Chinad State Key Laboratory of Advanced Equipment and Technology for Metal Forming, Shandong University, Jinan 250061, PR Chinae School of Mechanical, Electrical & Information Engineering, Shandong University, Weihai 264209, PR China论文下载:https://doi.org/10.1016/j.ymssp.2025.112736作者邮箱: ssinghua@sdu.edu.cn摘要数字孪生可在加工过程中提供高精度数据融合、实时状态预测和优化决策支持。可靠的刀具磨损监测(Tool Wear Monitoring, TWM)模型对于保证数字孪生系统中的数据准确性、提高磨损状态评估可靠性至关重要。然而,现有监测模型主要从平均意义上考虑磨损过程约束,无法严格保证其符合潜在物理机制。针对这一问题,本文面向铣削过程的数字孪生智能监测,提出一种融合知识-数据驱动的物理信息神经网络(Physics-Informed Neural Network, PINN)的 TWM 模型。在考虑磨损演化过程单调性的基础上,本文将磨损率变化的潜在机理作为硬物理约束,用于构建物理信息损失。通过引入具有明确物理意义的知识偏差,引导神经网络学习过程,确保模型输出映射到严格遵循物理机理的值域中,从而提高物理一致性。三种不同加工条件下的铣削实验结果表明,与传统神经网络相比,所提出的 PINN 模型具有更高精度与更强泛化能力,平均 RMSE 分别降低 11.87%、10.35% 和 15.04%。此外,在最优模型离线训练完成后,从在线数据处理到得到磨损输出的响应时间在 2 s 内,而 PINN 模型本身的计算时间处于毫秒量级。该 PINN 模型可为数字孪生智能监测系统提供低延迟响应的实时刀具磨损数据,并与决策支持系统集成,促进数字孪生系统的迭代优化,实现智能预测与维护。关键词: 数字孪生;刀具磨损监测;物理信息神经网络;多层感知机;长短期记忆网络目录1 引言 2 相关工作 2.1 刀具磨损监测模型 2.2 物理信息神经网络 3 方法 3.1 多层感知机与长短期记忆网络 3.2 PINN 基本理论 3.3 基于 PINN 的刀具磨损监测 3.4 混合模型与纯数据驱动模型的精度对比 3.5 残差分析与路径依赖效应 3.6 采样比例对模型精度的影响 4 实验验证与分析 4.1 案例 1 4.2 案例 2 4.3 案例 3 5 讨论 5.1 PINN 关键参数比较 5.2 数字孪生场景中的有效性评估 6 结论 注:本文只选中原论文部分进行分享,若想进一步拜读,请下载原论文。 小编能力有限,如有翻译不恰之处,请多多指正~ 1 引言 作为实现智能制造的一种有效途径,数字孪生凭借先进的仿真和预测能力,能够在智能制造环境中实现自主执行监测、产品设计优化、生产过程控制、故障诊断与维护 [1,2]。数字孪生将物理实体与其数字虚拟模型相结合,并基于实时数据持续交互 [3],从而能够提供更准确的预测。在数控机床加工中,数字孪生的主要应用是建立刀具、夹具等硬件的虚拟模型,同时对传感器感知到的实时数据进行处理与分析。这使得数字孪生驱动的 TWM、刀具故障预警、预测性维护、工件颤振分析和实时误差补偿成为可能。Liu 等 [4] 利用设备和环境的基本属性构建车间静态虚拟模型,并结合生产线实时监测数据与动态逻辑信息构建动态虚拟模型,从而通过数字孪生驱动的神经网络模型预测工件表面粗糙度。Awasthi 等 [5] 在数字孪生架构下研究了用于预测功率和切削力的最优传感器组合,并采用 K 近邻算法进行刀具故障监测。Liu 等 [6] 测量主轴和夹具的振动信号,利用提取的频率响应特征构建虚拟刀具健康模型,并采用支持向量机(Support Vector Machine, SVM)模型诊断刀具状态。对物理环境状态的感知和识别,是实现数字孪生虚实映射数据交互的前提。此外,构建可靠的监测模型能够为监测系统提供准确反馈数据,从而增强对设备诊断和工艺参数调整的支持。对于 TWM 而言,准确的监测模型可帮助操作人员制定更有效的预防性维护计划,避免因设备故障导致停机。过去几十年中,TWM 方法已从传统单传感器信号分析和简单数学模型,发展到多传感器信息融合与神经网络方法。Lin 等 [7] 将刀具磨损表示为钻削力与扭矩的函数,并指出进给率会显著影响切削力信号。El-Wardany 等 [8] 将振动信号特征作为评估刀具磨损的准则。多传感器信息融合能够更全面地表征系统状态 [9]。利用多传感器信息融合和神经网络的 TWM 技术已得到成功开发与验证 [10,11]。以神经网络为代表的机器学习模型,由于其复杂非线性结构,能够有效捕捉刀具磨损过程中的隐含非线性关系,因而非常适合处理复杂刀具磨损特征,并与自动化监测系统集成。在神经网络模型基础上引入先验物理约束以提高物理一致性,已受到越来越多关注。然而,现有集成物理信息的神经网络模型在不同加工条件下重构物理信息时仍面临挑战。同时,由于缺少强制性物理定律约束,预测输出可能偏离磨损机理。本文提出一种面向数字孪生铣削智能监测系统的 TWM 模型,该模型融合知识驱动与数据驱动的物理信息神经网络。不同于现有方法,本文通过引入物理知识定义刀具磨损的物理信息损失,并将其集成到精简高效、无冗余分支的神经网络模块中。本文提出耦合损失函数以引导训练过程,挖掘刀具磨损过程中的隐含先验知识,并将其作为先验信息增强模型对系统物理规律的理解。该模型在保证精度的同时兼顾计算效率和可移植性。本文主要创新点和贡献如下。从多传感信号中提取多域特征,并对特征域相关性分布与特征相关系数分布进行综合分析。利用 Kendall、Spearman 与最大互信息相关性分析获得加权刀具磨损相关系数,筛选高相关特征,以提高监测模型可靠性,并在精度与计算效率之间取得平衡。基于刀具磨损过程的广义 PDE,提出刀具磨损 PINN 模型,并将控制方程作为硬约束知识嵌入模型。在考虑磨损演化单调性的基础上,通过分析潜在磨损率机理,引入具有物理意义的知识偏差来引导神经网络学习过程,持续修正预测误差,并确保模型输出映射到严格遵循物理机理的域内。该模型实现了数据驱动算法与物理知识的深度融合,提高了物理一致性。通过三组具有不同加工条件、材料和刀具类型的铣削实验以及一系列消融实验,验证所提方法的有效性、泛化性和实时性。所提出的刀具磨损 PINN 模型能够以低延迟响应保证加工过程中的及时反馈,并通过引入物理知识获得能够反映实际磨损过程的预测结果。结合数字孪生系统,该模型可为智能制造提供可靠的决策支持。本文其余部分安排如下:第 2 节介绍与 TWM 和 PINN 相关的研究工作;第 3 节首先回顾两种典型传统神经网络模型的输出预测过程,然后介绍 PINN 的基本框架,并重点阐述基于所提 PINN 模型的 TWM 实现过程;第 4 节通过铣削实验和消融实验验证所提方法;第 5 节讨论影响 PINN 模型性能的关键参数,并评估所提 PINN 模型的有效性;第 6 节给出结论。 2 相关工作 2.1 刀具磨损监测模型目前,TWM 模型主要包括物理模型、数据驱动模型和混合模型,如图 1 所示。 图 1. TWM 模型示意图。物理模型通常通过分析试验数据建立包含工艺参数的经验方程。Slamani 等 [12] 提出一种考虑切削速度和铣削力的经验刀具磨损指标模型。Zhang 等 [13] 提出一种考虑不同阶段磨损率的通用经验模型,并以模型系数变化表征磨损过程。Palmai 等 [14] 研究了磨损过程中的热激活扩散机制,并建立了考虑温度效应的物理磨损模型。然而,实际切削条件多变,物理模型缺乏适应性和灵活性 [15],因此难以推广。近年来,数据驱动模型已成为推动 TWM 高度自动化和智能化诊断发展的关键力量。直接测量方法通过显微镜、轮廓仪等测量工具获取磨损图像,并利用图像处理算法或智能特征提取技术实现 TWM。Lins 等 [16] 面向信息物理系统开发了一种 TWM 装置,能够可靠地提供换刀时间。然而,机器视觉测量容易受到材料表面光洁度和环境光照条件限制,且监测成本通常较高 [17,18]。间接测量方法利用传感器采集加工信号,并采用机器学习方法或统计驱动方法进行建模。机器学习方法从加工信号中提取多域特征,并采用 Kendall 分析 [19]、Spearman 分析 [20] 和最大互信息分析 [21] 等方法获得与刀具磨损相关的特征,再将其输入人工智能模型进行训练。Qin 等 [22] 将多域特征输入神经网络,并结合 SVM 实现磨损值预测。Korkmaz 等 [23] 通过分析磨损图像特征,使用多层感知机(Multi-layer Perceptron, MLP)预测刀具磨损。Marani 等 [24] 将电流信号输入长短期记忆(Long Short-Term Memory, LSTM)模型预测刀具磨损。He 等 [25] 将原始温度信号输入神经网络,并在损失函数中引入 Kullback-Leibler 散度惩罚因子。Ma 等 [26] 将 CNN 和 LSTM 串联,分别捕捉空间特征和时间特征以进行磨损预测。然而,机器学习方法可解释性较弱,并且缺乏对预测结果不确定性的量化。统计数据驱动方法是数据驱动方法的一个子集。该方法通过分析数据分布特征和趋势建立 TWM 模型,其不确定性量化能力有助于决策者更有效地管理风险。Song 等 [27] 建立了用于 TWM 的多核高斯过程(Gaussian Process, GP)模型,并采用 Adam 算法进行超参数优化,将由堆叠多层降噪自编码器提取的高相关特征输入模型。Ma 等 [28] 使用 GP 建立刀具退化模型,并通过粒子滤波优化模型参数。然而,即使是同类型设备,其退化模式也可能不一致,因此统计数据驱动方法的泛化能力较弱 [29,30]。混合模型融合多种方法,可弥补单一方法的局限。首先,通过集成机器学习与统计过程,可结合二者的数据处理能力和不确定性量化能力。Nguyen 等 [31] 采用 ANFIS 定义工艺参数与磨损之间的数学关系,并结合 GP 提供置信区间。Li 等 [32] 提出一种双阶段 SVM 框架,在离线训练中学习刀具退化特征与磨损之间的关系,并结合粒子滤波在线估计退化特征。Li 等 [33] 将 CNN 和 LSTM 串联作为机器学习模型,其输出值作为三阶段 Wiener 过程的观测值。其次,通过引入物理模型生成的二级数据源,可提高物理一致性并降低数据依赖性 [34-36]。最后,通过引入刀具磨损过程的物理知识,如磨损变化的单调性 [37,38] 和非负性 [39],可引导模型训练过程。然而,当加工条件发生变化时,物理模型必须重构,这需要由高可靠性和强泛化性的物理模型生成新的数据源。此外,仅考虑磨损变化的单调性和非负性,只能保证预测在平均意义上符合磨损规律,而不是实施严格约束,因此在某些时刻仍可能偏离磨损机理。2.2 物理信息神经网络将控制方程、物理定律和工程理论融入模型训练过程,可获得精确且物理一致的结果。物理信息神经网络最早由 Raissi 等 [40] 提出,其将物理约束以偏微分方程(Partial Differential Equations, PDE)的形式嵌入神经网络,用于模拟系统行为,或根据观测数据反演 PDE 的未知参数。PINN 主要应用于材料力学 [41]、流体力学 [42] 和医学 [43] 等领域。Kissas 等 [44] 利用动脉血流速度、血管壁位移与压力信息引导神经网络训练,用于预测动脉血压。Du 等 [45] 提出一种基于 PINN 的模型估计管道中混油浓度分布,并通过引入混油输送过程和扩散机制的控制方程引导训练过程。3 方法本节首先回顾两种典型传统神经网络——多层感知机和长短期记忆神经网络——的预测输出计算过程;随后介绍考虑 PDE 一般形式的 PINN 基本框架;最后重点阐述基于 PINN 的 TWM 实现过程,这是本文的关键组成部分。3.1 多层感知机与长短期记忆网络多层感知机(MLP)通过层间加权和非线性变换逐层从输入数据中提取特征,最终生成输出。通过反向传播算法,MLP 能够高效更新权重和偏置。假设 MLP 共有 层,其中空间坐标 与时间坐标 作为输入: 在输出层中,使用非线性激活函数可能会限制输出范围或变换形式,导致输出信息损失;尤其在回归问题中,这会对预测精度产生不利影响。因此,输出层采用线性映射生成 MLP 的最终结果 : 其中, 表示非线性激活函数, 和 分别为权重和偏置。长短期记忆网络(LSTM)具有更复杂的结构,它通过门控机制调节信息流,从而更高效地捕捉长序列数据中的长期依赖关系。首先,将空间坐标 和时间坐标 转换为适合输入 LSTM 的特征向量: 其中, 表示组合空间坐标与时间坐标的函数。双向 LSTM 是标准 LSTM 的增强形式,如图 2 所示。双向 LSTM 同时考虑历史数据和未来时刻信息,因此双向 LSTM 的输出 (h_t) 可表示为: 图 2. 双向 LSTM 结构。 其中, 和 分别为对应于 时刻前向隐藏层状态 与后向隐藏状态 的权重, 表示 时刻隐藏层状态的偏置。随后,将双向 LSTM 的输出连接到全连接层,以生成最终结果 : 其中, 和 分别表示全连接层的权重和偏置。3.2 PINN 基本理论将物理知识作为附加约束引入神经网络模型,如微分方程与守恒定律,可帮助模型避免过拟合训练数据,并促进其收敛到全局最优解。考虑一般时空 PDE: 其中, 表示空间变量, 表示时间变量, 表示空间域, 表示时间域, 表示作用于 的偏微分算子, 表示边界算子。对于实际物理系统,PINN 使用神经网络逼近 PDE。通过微调参数 ,神经网络输出逐渐接近真实解。神经网络与物理约束之间的差异可表示为残差向量: 其中, 表示神经网络输出, 表示可训练参数,包括权重和偏置。PINN 不仅考虑单一数据驱动方法中输入与输出之间的复杂映射关系,还集成物理方程以逼近 PDE 解。图 3 展示了物理信息神经网络的结构示意图,包括神经网络与附加损失项。PINN 总损失由数据损失 、物理信息损失 、边界条件损失 和初始条件损失 组成。 图 3. 物理信息神经网络结构示意图。 其中, 、 、 和 表示权重系数; 、 、 和 分别表示真实值数量、PDE 残差点数量、边界点数量和初始值点数量; 表示真实值, 表示实际初始值。训练过程中的数据损失通常被归类为监督学习任务,因为它依赖已知数据;而物理信息损失可被视为无监督学习任务,因为它通过求解 PDE 和物理定律构造,不需要外部标签。对于时空域中的给定输入,神经网络利用其非线性逼近能力与高维数据处理能力平衡所有损失项,并通过寻找最优权重 和偏置 最小化公式 (10) 中的损失函数: 在 PINN 模型中,自动微分(Automatic Differentiation, AD)用于计算偏微分算子。AD 的核心机制是通过链式法则将导数从输出节点反向传播到输入节点,逐步计算每个变量的梯度。梯度是表示参数调整方向与幅值的向量。获得梯度后,可更新参数,以逐步修正违反物理定律的预测结果。 其中, 表示学习率, 表示对参数 的梯度运算, 表示迭代步长。3.3 基于 PINN 的刀具磨损监测本文提出一种基于 PINN 模型的 TWM 实现流程,包括数据采集、数据预处理、特征分析以及基于 PINN 的模型构建,如图 4 所示。首先,从 CNC 机床获取刀具全寿命周期样本数据,包括多传感器信号与磨损值。随后处理信号异常值,并进行数据降维。通过相关性分析和特征提取技术识别刀具磨损的高相关特征,从而提高预测结果透明度并降低决策风险。最后,构建并训练最优 PINN 模型以实现 TWM。高质量 TWM 依赖全面可靠的传感器数据、有效降噪以及具有物理意义的特征提取,但其效果最终仍受模型学习能力和泛化能力制约。因此,基于 PINN 的模型构建是决定监测性能的核心部分。 图 4. 基于 PINN 的 TWM 框架。随着刀具磨损增加,刀具的主要特征是刃口逐渐变钝,这会导致刀具在有效工作时间内完成的切削量减少。学者们提出了多种经验模型来解释刀具磨损演化,例如指数模型 [12],以及对数多项式与指数的混合模型 [13,46]。这些模型将刀具磨损描述为时间的一元函数。然而,仅将刀具磨损演化建模为时间的一元函数,无法在没有实时监测数据的情况下准确捕捉磨损变化。随着刀具磨损加剧,刀具表面会出现材料疲劳、软化、微裂纹形成以及氧化物等现象。此外,多传感器数据包含反映刀具磨损状态的多维复杂特征,这些特征通常具有时间依赖性。均方根、标准差和方差等常用特征经常用于建立刀具磨损映射关系 [47,48]。因此,为更准确地建模实际刀具性能演化,引入实时加工过程监测数据可提高精度。本文将刀具磨损表示为多源相关特征的函数,并采用神经网络 对其建模。 其中, 表示刀具磨损预测值; 表示对应的方差、均方根等多维信号特征; 表示时间向量; )表示多维输入与刀具磨损之间的映射关系。刀具磨损率是单位时间内发生刀具磨损的速率。随着刀具磨损值增加,磨损率可能因磨损机理变化而改变。磨损率受切削力、切削过程振动以及切削时间等因素影响。刀具磨损率经验模型 [49] 记为 ,可表示为: 其中, 为摩擦速度, 、 和 为工件与刀具材料属性, 表示接触力,可由比例系数 与刀具磨损值 近似表示, 的计算如下: 可进一步按下式计算: 加工过程中的材料属性通常不易获得,因此刀具磨损率的显式形式未知。受公式 (15) 和公式 (17) 启发,本文建立一个更一般的非线性动力学函数,用于描述刀具磨损率: 函数 描述由参数 构造的刀具磨损率显式 PDE。当仅考虑 时,公式 (15) 可视为公式 (18) 的特例。其中, 和 分别表示 对 与 的一阶偏导数, 和 分别表示 对 与 的二阶偏导数。本文仅关注一阶偏导数的影响,而忽略高阶偏导数。一方面,一阶偏导数直接对应磨损发展速率,能够充分捕捉刀具磨损的主要动态特征。另一方面,二阶导数等高阶导数表征磨损率变化,在某些情况下可提供额外信息。然而在实际应用中,高阶导数并不能带来显著优势,反而会增加计算复杂度和内存需求,并使 PINN 模型收敛更加困难。本文采用具有可训练参数 的神经网络 对 建模,并利用 AD 机制计算 和 。同时,构建具有可训练参数 的神经网络 对函数 建模,使其能够从给定的 、 及其他偏导数中学习刀具磨损机理,并进一步推断磨损率变化。在公式 (14) 的基础上引入公式 (18),等价于引入具有物理意义的知识偏差来引导学习过程,从而约束磨损演化规律并降低预测不确定性。通过 和 建立具有 PDE 残差 的 PINN 模型: 其中, 表示神经网络 关于 的偏导数。基于上述分析,需要确保每个切削样本遵循正确的磨损演化规律。因此,物理信息损失项可表示为: 其中, 表示样本总数, 表示样本索引。对于刀具磨损而言,刀具磨损随切削次数增加而增加这一原则是公认的物理知识。然而,由于测量系统噪声导致磨损信号随机波动,预测刀具磨损值可能呈现非单调变化。为解决这一问题,本文引入单调性损失以消除物理不一致性。若预测磨损值下降,则会产生非零损失,其大小等于差值。单调性损失计算如下: 其中, 表示第 次加工操作的预测磨损值。对于监督学习任务,为逼近从输入到目标输出的函数,常用数据损失函数为均方误差: 其中, 表示第 次加工操作的实际磨损值。基于上述所有损失项,基于 PINN 的 TWM 总损失函数如公式 (23) 所示。PINN 具体流程见算法 1。 其中, 和 分别为物理信息损失项和单调性损失项的权重系数。本文中, 和 分别设为 1 和 0.5。 图 5. HMoTP 铣削实验装置与加工参数。算法 1:物理信息神经网络 4 实验验证与分析本节将采用本文研究团队于 2024 年开发的 HMoTP 刀具磨损数据集 [50]、PHM 2010 数据集 [51] 和 NASA Ames 数据集 [52]。首先进行数据预处理和特征分析;随后将物理知识融入 MLP 与 LSTM 两种传统神经网络架构,构建基于 MLP 的 PINN 模型(称为 M-PINN)和基于 LSTM 的 PINN 模型(称为 L-PINN)。通过三组不同条件下的铣削实验评估这两种模型的性能。所提方法在配备 Intel Core i5-12400 CPU、主频 2.5 GHz 的计算机系统上实现。4.1 案例 14.1.1 实验设置HMoTP 铣削实验在 DMU 70 V 机床上进行,其 、 和 轴行程分别为 710 mm、520 mm 和 520 mm。工件为 Ti6Al4V 材料薄壁件,尺寸为 150 mm × 100 mm × 5 mm。所用刀具为直径 14 mm 的可拆卸立铣刀;与整体式铣刀不同,该刀具可在不拆除刀柄的情况下保留刀柄。采用便携式数字显微镜测量刀具磨损值,以减小安装误差并避免对试验结果产生不利影响。详细实验装置和切削参数如图 5 所示。采集 、 、 、 、 、 和 七个通道的信号数据,采样频率为 5 kHz。HMoTP 铣削实验获得了三把刀具(T1、T2 和 T3)的全寿命周期数据,每把刀具完成 100 次切削,共得到 300 组切削样本。切削信号及对应磨损标签以 CSV 格式保存。HMoTP 铣削实验的刀具磨损值变化如图 6 所示。 图 6. HMoTP 铣削实验刀具磨损值变化。4.1.2 特征提取与选择切削信号中存在大量噪声和异常值,因此有必要消除异常值以减小其对信号的影响。本文采用 Hampel 滤波方法,通过移动局部范围检测异常值并用中位数替换。首先计算局部范围内数据的中位数,随后利用中位数绝对偏差(Median Absolute Deviation, MAD)表示数据离散程度。假设信号局部范围内有一组数据 ,其对应中位数为 ,则 MAD 可由下式计算: 其中, 表示对数据取中位数的操作。最后,若,则将 判定为异常值并替换为 ;否则, 保持不变。判定过程如下: 其中, 表示倍数阈值参数。 此外,在处理长时间序列时,数据量较大,直接输入模型会增加训练复杂度。滑动窗口方法可通过分段降低数据维度,同时在一定程度上平滑噪声信号并保留主要趋势信息。滑动窗口方法原理如图 7 所示。在保证处理后数据长度统一为 的前提下,假设传感器数据长度为 ,窗口大小为 ,则滑动时间步长 可表示为: 其中, 表示向下取整操作。 图 7. 滑动窗口方法原理。信号中的部分信息可能与刀具磨损无关,若直接输入这些信息,冗余数据会增加模型处理时间,从而降低效率和精度。具有物理意义的特征可提高决策可解释性。本文从多个特征域中提取特征,见附录 A。每个特征域提取 14 个特征,因此每个通道共有 42 个特征。特征选择和特征提取通常是相互补充的步骤。若不进行特征选择,冗余特征会阻碍模型准确学习数据与目标变量之间的关系。本文综合采用三种相关性分析方法,重点评估变量之间的顺序关系、单调关系和非线性关系,以提高相关性分析的全面性与可靠性。加权特征相关系数 的计算公式如下: 其中, 、 和 分别为 Kendall 分析、Spearman 分析和最大互信息分析结果。采用 Hampel 滤波方法去除异常值,并利用滑动窗口方法降低数据维度后,HMoTP 铣削实验所有通道的特征域相关性分布如图 8(a) 所示。可以观察到,与刀具磨损高度相关的大多数特征位于时域和频域。对于时频域,HMoTP 铣削实验中的 通道仅表现出少量高度相关特征,且贡献相对较低。为进一步可视化所有通道特征相关系数的分布范围,图 8(b) 给出了 HMoTP 铣削实验所有通道特征相关系数的四分位数、极值和中位数。可以看出,在 HMoTP 铣削实验中, 和 通道中大多数特征的相关程度较高,相关系数集中在 0.1 到 0.4 范围内。 图 8. 所有通道相关性分布:(a)特征域相关性分布;(b)特征相关系数分布。从所有通道中选取加权相关系数最高的前 16 个信号特征,如 mnp、mav 和 acc,并将特征值转换到统一尺度,以避免不同特征量级对模型性能产生影响。采用 Min-Max 归一化方法将取值限制在 0 到 1 范围内。HMoTP 铣削实验相关系数最高的前 16 个特征如图 9 所示。可以观察到,所选特征与刀具磨损之间存在较强正相关。 图 9. 前 16 个归一化特征,括号中数值表示对应特征的加权相关系数。4.1.3 预测结果为验证所提出物理信息神经网络在 TWM 中的有效性,本文构建 M-PINN 和 L-PINN,并分别与传统神经网络 MLP 和 LSTM 进行比较。所提模型与传统神经网络使用相同超参数,即 batch size、学习率、dropout、激活函数和优化器。然而,传统神经网络不考虑物理信息损失项,因此只包含单一神经网络 ,不包含 ,这表明上述比较等价于消融实验。所提模型与传统神经网络的结构和关键参数设置分别如表 1 和表 2 所示。训练过程中,两把刀具的数据样本用于训练,剩余刀具的数据样本用于测试,并将 20% 的训练样本作为验证集。因此,对于 HMoTP 铣削实验,训练、验证和测试样本数分别为 160、40 和 100。与特征缩放方法类似,本文将标签值限制在 0 到 1 范围内,以加快模型收敛。表 1. 所提模型与传统神经网络的结构。 表 2. 所提模型与传统神经网络的参数设置。 以高相关特征和时间为输入,M-PINN 与 L-PINN 在 HMoTP 铣削实验中的磨损预测结果分别如图 10(a) 和图 10(b) 所示。预测磨损值分布在对角线附近,说明模型性能较好。为保证公平比较,PINN 模型和传统神经网络采用相同超参数。汇总刀具磨损预测结果后,所提 M-PINN 与传统神经网络 MLP 的预测结果散点图如图 11(a) 所示,所提 L-PINN 与传统神经网络 LSTM 的预测结果散点图如图 11(b) 所示。与基准模型相比,所提 PINN 模型的预测值更接近真实值,离散程度更小,预测结果更稳定。 图 10. HMoTP 铣削实验预测结果:(a)M-PINN;(b)L-PINN。 图 11. 基于 HMoTP 铣削实验三把刀具样本评估的结果散点图:(a)M-PINN 与 MLP 对比;(b)L-PINN 与 LSTM 对比。为尽量减少随机变化和极端情况对结果的影响,本文进行了 10 次重复计算。以 RMSE 作为比较指标,所提模型与传统神经网络的预测结果如图 12 所示。在每幅图中,蓝色实线表示 10 次计算的平均 RMSE,红色虚线表示 10 次计算的中位 RMSE。值得注意的是,所提模型在测试样本上表现更好,其平均 RMSE 和中位 RMSE 通常低于传统神经网络。误差分布相对集中,表明 PINN 模型稳定性增强。PINN 模型将数据驱动算法与物理知识深度融合,不仅拟合输入与输出之间的映射关系,还在预测过程中严格遵循物理机理,持续修正预测误差,并更准确地捕捉磨损演化的复杂动态行为。此外,控制方程会基于实时监测信号持续更新,并可扩展到新的工况,从而保证 PINN 模型的鲁棒性。 图 12. HMoTP 铣削实验中 PINN 模型与传统神经网络 10 次重复计算的比较结果:(a)M-PINN 与 MLP 对比;(b)L-PINN 与 LSTM 对比。尽管传统神经网络考虑了磨损演化过程的单调性,但其只能在平均意义上符合物理规律。在考虑磨损演化单调性的基础上,本文将控制方程作为硬约束嵌入 PINN 模型。该方法引入具有物理意义的知识偏差来引导神经网络学习过程,确保模型输出映射到严格遵循物理机理的值域中,从而降低预测不确定性并提高物理一致性。此外,通过具体定量指标,即消融实验结果,对 PINN 模型与传统神经网络的性能进行比较,如表 3 和表 4 所示。在 12 个评价指标中,所提 PINN 模型始终优于传统神经网络。与传统神经网络相比,所提 PINN 模型最大可使 RMSE 降低 11.87%。表 3. M-PINN 消融实验结果。 表 4. L-PINN 消融实验结果。 图 13(a) 和图 13(b) 分别展示了所提 PINN 模型与传统神经网络的训练损失和验证损失变化。与传统神经网络相比,PINN 模型不仅最小化数据损失,即预测值与实际值之间的误差,还最小化与控制方程相关的误差。由于物理损失项引入附加约束,PINN 模型必须在数据拟合与遵循物理规律之间取得平衡,因此训练过程中的总体损失值会增加。当验证集中出现训练过程中未遇到的状态时,PINN 模型仍可通过遵循物理知识进行预测,获得更加一致的预测结果,从而提升验证集上的整体性能。 图 13. M-PINN 与 MLP 的损失变化:(a)训练损失;(b)验证损失。4.2 案例 24.2.1 实验设置PHM 2010 铣削实验采用 Röders Tech RFM760 机床进行,工件为矩形不锈钢块(HRC52),刀具为钨 carbide 三刃球头铣刀。详细实验装置和切削参数如图 14 所示。采集七个通道 、 、 、 、 、 和 AE 的信号数据,采样频率为 50 kHz。 图 14. PHM2010 铣削实验装置与加工参数。PHM 2010 铣削实验使用三把刀具(C1、C4 和 C6),每把刀具经历 315 次切削的完整寿命周期,共获得 945 组切削样本。切削信号及对应磨损标签以 CSV 格式保存。PHM 2010 铣削实验的刀具磨损值变化如图 15 所示。 图 15. PHM 2010 铣削实验刀具磨损值变化。4.2.2 特征提取与选择经过噪声去除和数据降维后,PHM 2010 铣削实验所有通道的特征域相关性分布如图 16(a) 所示。与 HMoTP 铣削实验类似,与刀具磨损强相关的特征主要位于时域和频域,而时频域特征贡献相对较小。在时频域中,仅 、 和 通道中的少数特征表现出强相关性。此外,如图 16(b) 所示,在 PHM 2010 铣削实验中,除 AE 通道外,其他 6 个通道均包含范围较宽的相关特征。与 HMoTP 铣削实验相比,相关系数分布在 0.6 到 0.9 范围内的比例更大。 图 16. 所有通道相关性分布:(a)特征域相关性分布;(b)特征相关系数分布。与 HMoTP 铣削实验类似,通过综合分析三种相关性方法,识别出相关性最高的前 16 个特征,如图 17 所示。与 HMoTP 铣削实验相比,PHM 2010 铣削实验特征变化更加平缓,且前 16 个特征的加权相关系数均高于 0.9。 图 17. 前 16 个归一化特征,括号中数值表示对应特征的加权相关系数。4.2.3 预测结果采用与表 1 和表 2 相同的网络结构和参数,M-PINN 与 L-PINN 在 PHM 2010 铣削实验中的预测结果如图 18 所示。所提模型整体预测性能较强。由于后期刀具磨损特征变化较大,预测结果存在轻微波动。通过 10 次重复计算获得的平均和中位预测误差如图 19 所示。类似地,所提模型的平均和中位预测误差始终低于传统神经网络。刀具磨损过程的广义 PDE 适用于整个磨损演化过程,可对神经网络预测过程施加硬约束。通过基于磨损率演化机理持续修正模型预测误差,预测结果保持明确的物理意义,使模型决策逻辑更加符合工业实践。 图 18. PHM 2010 铣削实验预测结果:(a)M-PINN;(b)L-PINN。 图 19. PHM 2010 铣削实验中 PINN 模型与传统神经网络 10 次重复计算的比较结果:(a)M-PINN 与 MLP 对比;(b)L-PINN 与 LSTM 对比。此外,消融实验的具体指标用于量化引入物理信息损失后预测精度的提升,如表 5 和表 6 所示。在 PHM 2010 铣削实验中,引入物理信息损失使 RMSE 最大降低 10.35%。网络层 起到惩罚机制作用。若预测结果偏离磨损机理,网络将通过反向传播更新权重,确保最终输出遵循物理规律。表 5. M-PINN 消融实验结果。 表 6. L-PINN 消融实验结果。 为更好地展示所提方法的有效性,本文将其监测精度与基于 PHM 2010 数据集发表的模型进行比较,如图 20 所示。与 SSAE-BDT [22] 和 Hybrid information-stacked LSTM [53] 相比,所提方法在 RMSE 和 MAE 指标上均取得最优结果。与 SSAE-BP [22] 相比,两种方法的 MAE 指标相同,所提方法的 RMSE 指标略高。尽管如此,值得注意的是,所提方法无需集成多个神经网络模块即可取得令人满意的结果。现有研究往往过度强调精度,导致融合模型包含多分支和多模块,参数调节复杂,参数数量增加,模型可解释性降低。不同于这些黑箱机器学习架构,所提方法基于物理知识从实际磨损机理出发获得预测结果,这对于数字孪生系统中的决策制定和故障诊断尤为重要。 图 20. 不同模型的评价指标(将预测结果转换回原始尺度后计算测试样本平均指标):(a)所提方法;(b)SSAE-BDT [22];(c)SSAE-BP [22];(d)Hybrid information-stacked LSTM [53]。4.3 案例 34.3.1 实验设置切削力信号已被证实与刀具磨损高度相关 [7]。然而,使用测力仪不仅会限制工作空间,还会改变机床的静、动态刚度,不符合加工过程监测要求 [9]。为进一步验证模型在不同切削条件下的泛化能力,以及在真实工业环境中缺少切削力信号时的可靠性,本文采用 NASA Ames 铣削数据集作为基础。NASA Ames 铣削实验在 MC-510 V 加工中心上进行。切削刀具为直径 70 mm、六齿面铣刀。工件尺寸为 483 mm × 178 mm × 51 mm。主轴和工作台上均安装振动传感器与 AE 传感器,电流传感器用于测量主轴的交流和直流分量。图 21 给出了 NASA Ames 铣削实验装置和切削参数,记录六个通道 、 、 、 、AC 和 DC)信号数据,采样频率为 100 kHz。 图 21. NASA Ames 铣削实验装置与切削参数。本文选择四把刀具(M2、M3、M11 和 M12)的全寿命周期样本。它们加工的工件均为铸铁,但进给率参数变化对模型性能提出了更严格要求。加工信号以 MAT 格式存储,对应磨损标签以 CSV 格式存储。NASA Ames 铣削实验刀具磨损值变化如图 22 所示。 图 22. NASA Ames 铣削实验刀具磨损值变化。4.3.2 特征提取与选择经过噪声去除和数据降维后,选择相关性最高的 16 个特征,如图 23 所示。在 NASA Ames 铣削实验中,与案例 1 和案例 2 相比,AE 信号特征表现出更强相关性。在所有提取特征中,AE 信号特征占总数的 62.5%。在刀具磨损后期,切削刃变钝,产生缺口和裂纹。这些缺陷会导致瞬时信号波动、特征剧烈变化,甚至出现与预期刀具磨损进程相偏离的下降趋势 [54]。 图 23. 前 16 个归一化特征,括号中数值表示对应特征的加权相关系数。4.3.3 预测结果不同于案例 1 和案例 2,本实验中不同刀具之间的切削条件发生变化。M-PINN 和 L-PINN 在 NASA Ames 铣削实验中的预测结果如图 24 所示。结果表明,即使没有直接测量的切削力信号,所提模型仍保持较高预测精度。这不仅降低了监测系统的硬件要求,也增强了其在复杂加工场景中的适用性,使其更适合实际工业条件。 图 24. NASA Ames 铣削实验预测结果:(a)M-PINN;(b)L-PINN。类似地,表 7 和表 8 给出的消融实验结果与未引入物理信息损失项时的结果进行比较。在 NASA Ames 铣削实验中,引入物理信息损失使 RMSE 最大降低 15.04%。尽管该实验样本量相对较小,但由于具有物理引导机制,在传统数据驱动方法受限时,所提出的 PINN 模型仍保持较高预测精度。表 7. M-PINN 消融实验结果。 表 8. L-PINN 消融实验结果。 5 讨论5.1 PINN 关键参数比较以案例 1 为例,当特征数量为 4、10、16 和 22 时,模型性能指标如图 25 所示。本文中,当特征数量为 16 时,预测精度达到最高。若输入特征数量过少,模型可能因信息丰富度不足而出现欠拟合;相反,若特征数量过多,例如 22 个,可能由于过拟合而限制模型精度并导致性能下降。 图 25. 不同特征数量下的 RMSE 指标。在平衡损失函数中,各损失项的权重对于增强模型性能至关重要。物理信息损失和单调性损失权重系数的适当比例,可确保数据拟合与物理一致性之间达到最优平衡。图 26 给出了 M-PINN 和 L-PINN 模型在不同权重系数下的性能指标。 图 26. 不同权重系数下的 RMSE 指标。如图 26(c) 与图 26(a) 对比所示,引入物理信息损失项后预测精度显著提高。当单调性损失项权重系数 保持不变时,将物理信息损失项权重系数 从 0.5 增加到 1 可提升模型性能,如图 26(c) 相对于图 26(b) 所示。与 , 相比,组合 , 可获得更大的精度提升,说明物理信息损失项比单调性损失项具有更显著影响。虽然同时引入物理信息损失和单调性损失相比单一损失项可提高性能,但过大的权重(例如 , )会使精度相对于纯数据驱动损失函数( , )降低 19.74%。这表明过度强调物理一致性可能导致反向传播过程中的物理损失项梯度主导训练,从而抑制数据损失梯度,阻碍模型有效学习数据分布。优化器的作用是根据损失函数调整网络参数以最小化损失。以刀具 T1 为测试样本,图 27 展示了所提出 M-PINN 模型在 Adam、RMSprop 和 SGD 三种优化器下训练过程中的物理信息损失。Adam 优化器的物理信息损失快速且稳定下降,与 RMSprop 和 SGD 相比具有更快收敛速度和更小波动,表明物理信息损失项被有效集成到优化过程中。Adam 优化器能够稳定更新参数,有效缓解梯度振荡问题。 图 27. 不同优化器下训练过程中的物理信息损失。激活函数向神经网络引入非线性。tanh、sigmoid 和 ReLU 是三种常见激活函数。本文比较了 M-PINN 模型在 tanh、sigmoid 和 ReLU 三种激活函数下训练过程中的物理信息损失,如图 28 所示。结果表明,tanh 激活函数对应的物理信息损失下降最快,说明 tanh 激活函数更有效地处理物理信息损失的非线性变化。tanh 激活函数的对称性和较宽激活范围有助于所提 M-PINN 模型捕捉物理方程解。 图 28. 不同激活函数下训练过程中的物理信息损失。进一步通过 10 次重复计算获得 Adam、RMSprop 和 SGD 三种优化器以及 tanh、sigmoid 和 ReLU 三种激活函数的预测结果,分别如图 29(a) 和图 29(b) 所示。在每幅图中,蓝色实线表示 10 次计算的平均 RMSE,红色实线表示 10 次计算的中位 RMSE。结果表明,以 Adam 作为优化器的预测结果平均 RMSE 分别比 RMSprop 和 SGD 降低 16.75% 和 46.84%。与 sigmoid 和 ReLU 函数相比,采用 tanh 作为激活函数的预测结果平均 RMSE 分别降低 29.82% 和 17.67%。 图 29. 不同优化器和激活函数下 10 次重复预测结果:(a)Adam、RMSprop 和 SGD 对比;(b)tanh、sigmoid 和 ReLU 对比。5.2 数字孪生场景中的有效性评估本文从三个方面评估所提 PINN 模型在数字孪生过程监测中的有效性:实时性、物理信息通用性以及真实加工环境中的传感器需求。首先,基于状态空间模型 [32] 构建刀具磨损过程的物理信息模型。参数估计过程会增加计算负担,并可能在实时数字孪生监测中造成延迟。所提 PINN 模型总响应时间小于 2 s,计算时间处于毫秒量级,适合长期 TWM。其次,当引入物理模型以增强样本标签的物理信息表征时 [34-36],关键在于评估该模型能否全面表征磨损过程。所提 PINN 模型基于刀具磨损过程的广义 PDE,其物理信息约束机制具有通用适用性。第三,现有物理信息模型 [35,36] 尚未评估在真实工业环境中缺少切削力信号时的可靠性。所提 PINN 模型通过涉及多种材料和切削条件的三组加工实验验证了其泛化能力,证明其在无切削力信号的真实工业环境中具有适用性。表 9 给出了所提 PINN 模型与传统神经网络的计算时间,包括训练过程以及磨损值输出响应。响应时间指从在线数据处理到磨损预测输出的完整过程。与 PINN 模型相比,传统神经网络训练时间更短。在训练过程中,PINN 模型必须调整与物理信息相关的神经网络,同时根据实时监测信号动态调整控制方程参数。损失函数集成了数据损失项、单调性损失项和物理信息损失项。为了在数据拟合与遵循物理规律之间取得平衡,训练期间不可避免地增加计算开销,因此需要额外时间进行权重调整。然而,训练过程是离线完成的,训练好的最优 PINN 模型被集成到数字孪生系统中。处理单个样本的响应时间在 2 s 内,其中数据预处理耗时 1.7405 s,特征提取耗时 0.0608 s,模型计算平均耗时 0.0062 s。因此,尽管 PINN 模型训练时间较长,其在精度和可靠性方面的优势十分显著。对于要求高精度和实时性的工业应用而言,这种额外计算成本对于提高预测精度和保证物理一致性是合理的。表 9. PINN 模型与传统神经网络训练时间和响应时间比较。 基于高保真虚拟加工过程建模、多源异构数据大规模同步采集、加工设备和工件状态智能感知以及加工参数智能搜索等关键技术,本文开发了面向铣削过程的数字孪生智能监测系统。该系统包含六个基本组成部分:物理空间、虚拟模型、数据传输模块、孪生信息数据库、实时监测系统和决策支持系统,使机床能够在智能制造环境中实现自主监测与智能决策。基于数字孪生的加工过程实时监测框架如图 30 所示。 图 30. 基于数字孪生的加工过程实时监测框架。物理空间: 物理空间是数字孪生技术的基础,包含机床、工件、刀具和控制系统等实际加工环境。虚拟模型: 虚拟模型从几何、物理、行为和规则四个维度构建。它依赖物理建模和数值仿真等建模技术,准确再现加工过程中的物理行为,包括刀具磨损、工件变形和加工误差。数据传输模块: 数据传输模块通过物联网技术和专用通信协议连接数字孪生的各组成部分,实现低延迟的双向信息交换与反馈。孪生信息数据库: 孪生信息数据库存储静态数据,如刀具编号和机床类型,以及动态数据,包括实时传感器数据、加工过程信息和设备维护记录。此外,它还支持实时数据记录和信息共享。实时监测系统: TWM 模型、切削力监测模型和温度监测模型等智能模型被集成到实时监测系统中,以实现加工过程的实时预测和异常检测。利用基于 PINN 的 TWM 模型,系统可显示实时刀具磨损状态,在需要换刀前进行预警,并直接为后续维护决策提供信息,促进制造过程优化与迭代。决策支持系统: 基于监测模型的数据分析结果,决策支持系统通过优化算法或基于知识的推理,为操作人员提供优化建议和决策支持。这六个组成部分通过实时数据流和信息反馈机制相互连接,形成协同的闭环反馈系统。采用模块化设计,刀具磨损监测 PINN 模型被集成为功能模块,并通过统一数据接口与实时监测系统交互,实现高效协同。在多机床或多刀具环境中,单机模型可通过部署分布式数字孪生扩展为支持跨设备协同的系统。不同节点的学习和预测过程可通过云计算架构协调,以应对大规模制造系统中的复杂挑战。6 结论本文面向铣削过程数字孪生智能监测,提出一种融合知识-数据驱动物理信息神经网络的监测模型。TWM 是预防性维护管理的基础,而磨损演化遵循特定物理规律。在考虑磨损演化单调性的基础上,本文分析了磨损率变化的潜在机理。进一步引入具有物理意义的知识偏差来引导神经网络学习过程,确保模型输出映射到严格遵循物理机理的值域中,从而提高物理一致性。所提模型解决了基于机器学习的纯数据驱动算法不考虑物理约束、从而导致违反物理原则的局限。基于 HMoTP、PHM 2010 和 NASA Ames 三组不同加工材料与切削条件下的铣削实验,本文获得了 40 个模型性能评价指标,并对所有所提模型进行了优化。消融实验结果表明,引入物理信息损失后,平均 RMSE 指标分别降低 11.87%、10.35% 和 15.04%。此外,在离线训练最优模型后,总响应时间小于 2 s,模型计算时间处于毫秒量级。所提模型的可靠性、泛化性和实时性为铣削过程中的数字孪生智能监测奠定了坚实基础。其低延迟能力确保系统能够在动态铣削过程中持续跟踪刀具磨损状态,并及时向操作人员提供反馈。为进一步增强 PINN 模型在复杂数字孪生系统中的适用性和可扩展性,未来研究将集成多任务学习框架,以同时预测刀具磨损、切削力和温度等关键变量,实现复杂条件下多物理场协同建模。此外,通过引入强化学习,模型可在实时监测系统中进行自优化,使其适应更复杂的动态环境,并通过探索未知工况持续提升预测能力。 编辑:Tina校核:李正平、陈凯歌、曹希铭、赵学功、白亮、任超、海洋、陈宇航、Kira、Leo、王金、赵诚、肖鑫鑫、张优该文资料搜集自网络,仅用作学术分享,不做商业用途,若侵权,后台联系小编进行删除来源:故障诊断与python学习

    未登录
    还没有评论
    课程
    培训
    服务
    行家
    VIP会员 学习计划 福利任务
    下载APP
    联系我们
    帮助与反馈