
精智知识工程 | 精智语料:让领域知识真正转化为模型能力

仿真世界 数智未来
产品概述
精智语料
大模型应用,正在进入专业化阶段
大模型正在从通用问答走向行业应用。
企业拥有大量制度文件、技术资料、专业报告和业务文档,但这些内容通常分散在不同载体中,缺少统一整理,也难以直接用于模型训练和效果评估。
很多团队面临同一个问题:
资料很多,但能够真正用于模型训练的数据不够;
模型接入很多,但缺少统一的评估标准;
数据生产投入很大,但质量审核和持续迭代难以形成体系。
大模型应用的竞争,正在从“有没有模型”,转向“有没有高质量的领域数据”。
模型能力的差异,越来越取决于数据能力
通用模型提供了基础能力,但要让模型真正理解企业知识、适应专业场景,还需要持续建设高质量的领域语料。
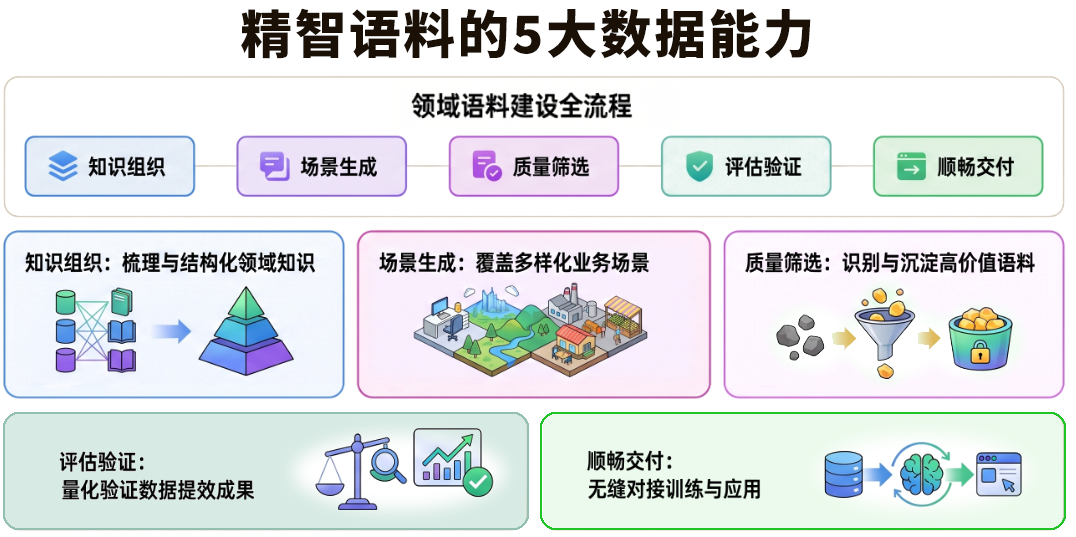
领域语料建设的关键,不只是把资料转成问答,更重要的是建立一套完整的数据能力:
能够理解和组织领域知识;
能够持续生成覆盖不同场景的数据;
能够识别、筛选和沉淀高质量内容;
能够通过评估验证数据是否真正提升模型效果;
能够将数据成果顺畅交付到训练和应用环节。
只有将知识整理、数据生产、质量治理和模型评估连接起来,企业才能把已有的专业知识真正转化为模型能力。
精智语料,构建领域数据能力闭环
精智语料面向大语言模型数据构建、质量治理与模型评估场景,帮助企业和专业团队将分散的领域资料转化为可训练、可评估、可持续迭代的数据资产。
以领域知识为核心,提升语料专业度
精智语料围绕企业制度、技术文档、专业资料和业务内容,帮助团队建立领域知识结构,增强语料对专业概念、业务语境和实际任务的理解能力。
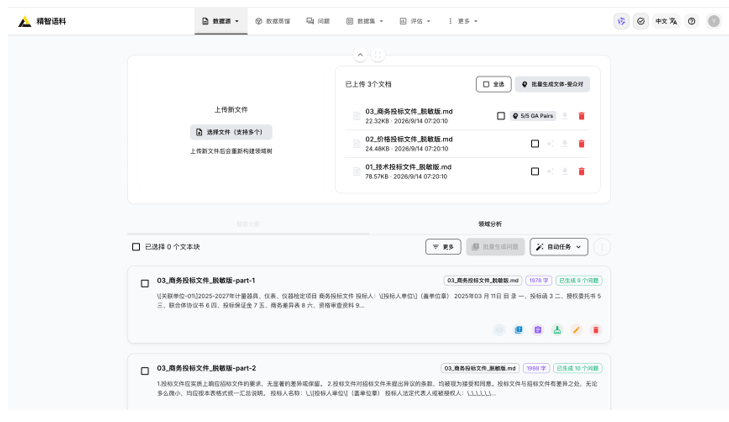
通过统一的项目化管理方式,团队可以持续沉淀领域资料、数据规范、审核结果和评估结果,逐步形成具有自身业务特色的专业语料资产。
以完整流程为支撑,提高数据建设效率
精智语料将资料处理、数据生成、审核筛选、质量评估和成果交付连接起来,帮助团队减少分散处理和重复操作,提升语料建设效率。
从原始资料到训练数据、评估数据,团队能够在统一工作空间中持续推进数据生产和项目协作,让语料建设更加规范、有序和可追踪。
以质量治理为重点,提升数据可用性
精智语料将质量管理贯穿数据生产过程,支持人工审核、评分记录、标签管理和模型辅助评估,帮助团队识别高质量数据,筛选低质量内容,建立更加清晰的数据质量标准。
数据不再只是生成结果,而是经过审核、评估和筛选后,成为能够服务模型训练与业务验证的数据成果。
以模型评估为抓手,验证数据实际价值
精智语料支持在统一题集和评估标准下,对不同模型、不同版本和不同配置进行效果比较。
通过自动评估与人工评审相结合,团队可以更加客观地判断模型能力变化,发现模型在具体领域中的优势与不足,并据此调整数据建设方向。
以多模型和多模态能力,适应复杂应用场景
精智语料支持接入多种模型服务,适应不同团队在模型选择、能力验证和成本管理方面的需求。
同时,平台兼顾文本与图像类数据建设,能够支持企业围绕文档、图片和图文资料构建多类型语料,为大语言模型和多模态模型应用提供数据基础。
从知识沉淀,到模型应用
精智语料,关注的不是单次数据生成,而是帮助团队建立持续运行的领域数据能力。通过不断补充新资料、优化数据规范、开展质量审核和验证模型效果,企业可以将分散的专业知识逐步沉淀为可管理、可复用、可迭代的数据资产。
精智语料,让领域知识更高效地进入模型训练,让数据质量更直接地服务模型效果,让企业真正拥有面向大模型时代的专业数据能力。


