首页/文章/ 详情

仿真太慢? 用代理模型给你的FEA提提速
14天前浏览276


SIMULIA · ABAQUS · 3DEXPERIENCE

仿真太慢?
用代理模型给你的FEA提提速

不写一行脚本,在3DEXPERIENCE平台上把上千次有限元计算,压缩成几秒钟就能看到结果的响应曲面。

代理模型(Surrogate Model),也叫黑箱模型、元模型或响应面模型,是一种用简化数学模型去逼近复杂仿真的方法。在SIMULIA ABAQUS、ISIGHT以及3DEXPERIENCE平台的语境下,代理模型最常见的用途,就是在需要反复运行精细仿真时,大幅降低计算成本。

与其为每一种设计变化、每一组参数都跑一次昂贵的完整仿真,不如先用有限次数的ABAQUS计算训练出一个代理模型。之后,面对新的输入参数,这个模型可以在极短时间内,预测出应力、变形等结果。

这篇文章想说清楚一件事:在3DEXPERIENCE平台上,不写脚本,也能把代理建模这件事跑起来。

代理建模是怎么跑起来的


1

实验设计

选取多组输入参数组合

2

运行仿真

用ABAQUS对每个设计点做FEA

3

构建代理模型

用多项式回归、克里金或神经网络拟合结果

4

预测与优化

做灵敏度分析、优化、不确定性量化

这一整套流程,通常由SIMULIA Process Composer 或 SIMULIA Isight 串起来,配合ABAQUS自动完成代理模型的搭建与设计优化,全程不需要人工干预。

代理模型能用在哪


设计优化 — 快速探索庞大的设计空间,不用跑几千次物理仿真也能找到最优参数。

灵敏度分析 — 看清楚输入的变化究竟怎样影响输出。

不确定性量化 — 对材料属性、边界条件的波动进行建模与管理。

实时仿真 — 在完整仿真太慢的实时系统里,直接用代理模型顶上。

多学科分析 — 把ABAQUS的输出和其他仿真工具串联,形成一体化优化流程。

为什么要把有限元和机器学习捏在一起?


答案很朴素:时间,时间,还是时间。时间就是金钱。

设想一支Formula Student或SAE BAJA车队,正在测试一辆有多根承力杆件的空间车架,想搞清楚每根杆件该怎么调整,才能降低车架的整体扭转应力。

他们搭出一个参数化模型,让每根杆件的长度、空间位置都可以变化。车架设计的每一种组合,都是一个独立的设计方案——排列组合下来,可能意味着成百上千小时的有限元分析。这还是在材料按线性假设、没有非线性行为的前提下。

代理模型,到底是个什么模型


01
是一种低阶的经验模型        
02
由仿真数据自下而上训练而成        
03
能够平滑带噪声的响应        
04
评估速度极快        
05
精度足够可靠        

建立代理模型之前,先做好三件事


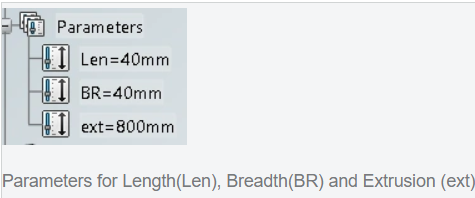
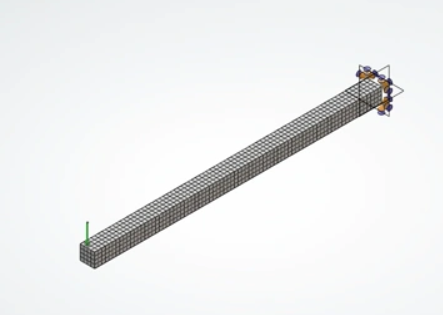
第一步:用几何参数完成一次有限元求解。比如把长度(Len)、宽度(BR)、拉伸量(ext)都设为可变参数。


第二步:在Process Composer的优化流程里,搭建一条完整的DOE执行链路,批量生成一组具有代表性的输入-输出数据。这些数据被直接送进机器学习训练管线,用响应面模型(RSM)或通用克里金(UK)去逼近真实的响应规律。为了让预测更准,流程里还会嵌入超参数调优,用优化策略去压低代理模型的平均误差(比如均方误差MSE或均方根误差RMSE)。
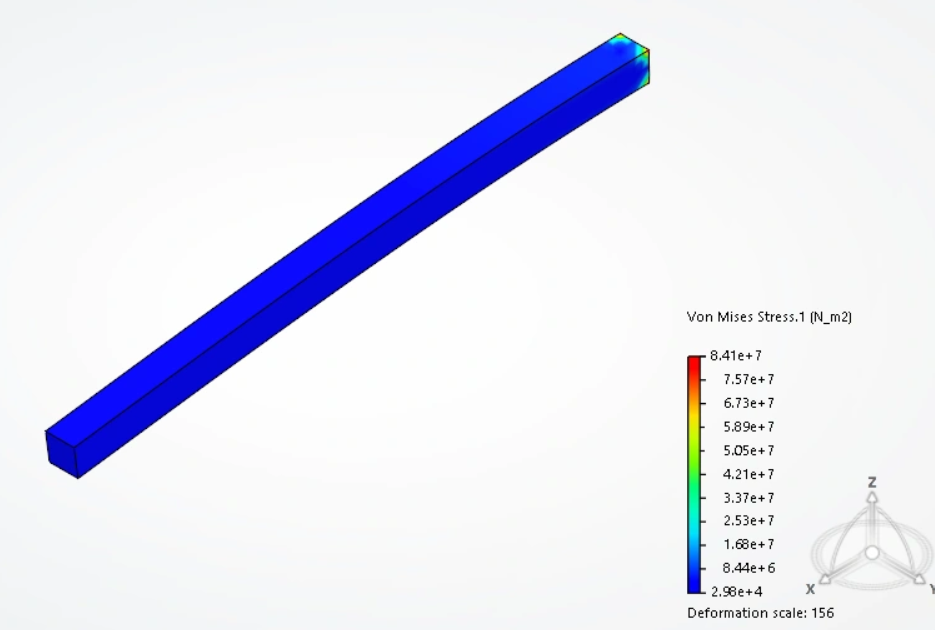


第三步:代理模型训练、验证完成后,接入Results Analytics App,就可以基于这个近似响应面做后处理、可视化和灵敏度分析了。
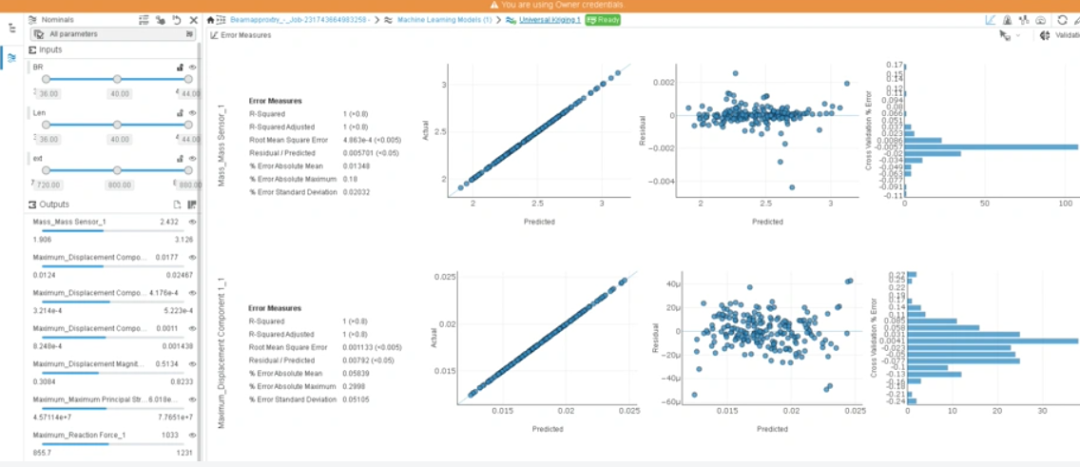
SIMULIA Results Analytics App 能帮你做什么


从ABAQUS结果里提数据

直接可视化并提取位移、应力、温度等仿真输出,高效处理大批量结果——正是搭建代理模型所需要的数据基础。

聚合、整理数据集

把多次DOE运行的结果汇总起来,自定义结果指标作为代理模型的输出,还支持跨参数组合的筛选、分组与比较。

无缝对接建模工具

整理好的数据,可以直接喂给Isight、3DEXPERIENCE Process Composer,或者外部Python/机器学习工具,用来训练响应面、克里金、神经网络等各类代理模型。

灵敏度与相关性分析

内置工具帮你分析参数间的敏感性与相关性,训练前就能做特征筛选,让模型更专注在真正重要的输入上,精度更高、复杂度更低。

轻松完成训练前预处理

在正式训练模型之前,把数据整理成规整、干净的输入格式。

反哺设计探索

分析结果和代理模型可以回流到设计流程中,支持优化、权衡研究和不确定性量化,还能用友好的界面跟踪历史设计决策。

拖一下滑块,两秒钟出结果


代理模型训练好之后,会出现在近似模型的仪表盘里,用起来就像调一个滑块那么简单:

把宽度参数 BR 调到

38.96

FEA传感器输出

2秒内完成更新

重置BR,把拉伸参数 ext 调到

840

质量 & 位移

2秒内完成更新

全程不用打开CAD,也不用进FE分析App,就能拿到有限元分析的即时结果——省下的是时间,砍掉的是重复劳动。

这套方法到底值在哪


大幅减少人工提取仿真数据的时间

提升模型搭建的效率与质量

提供一个集中的仿真数据分析平台

支撑从仿真到建模再到优化的完整链路


来源:ABAQUS仿真世界
AbaqusIsight非线性通用python材料曲面
著作权归作者所有,欢迎分享,未经许可,不得转载
首次发布时间:2026-09-24
最近编辑:14天前
yunduan082
硕士 | 仿真主任工程... Abaqus仿真世界
获赞 206粉丝 400文章 497课程 0
点赞
收藏
作者推荐

从离散数据到设计曲线: 应变疲劳分析全流程拆解

疲劳工程笔记 · NO. 04 应变控制疲劳试验不会直接给出设计曲线——它给你的,是一堆散乱的失效数据。要把这些数据变成工程师真正敢用的曲线,需要拟合两条本构关系、审查每一个离群点,再回答一个更关键的问题:到底该按哪条曲线来设计零件?材料 S355 结构钢方法 Ramberg-Osgood + Coffin-Manson标准依据 ASTM E606 应变控制疲劳试验 应变—寿命曲线(Strain-Life)反转次数 2N꜀ · 对数坐标 50:50 回归曲线(中位寿命)97.5:95 设计曲线试验数据点 为什么需要这套流程 一条曲线背后,是两次拟合和一次统计决策把疲劳试验数据变成设计曲线,本质上是两步:先用力学模型描述材料在循环载荷下"应力—应变怎么走",再用统计模型描述"应变幅—寿命怎么走"。前者靠 Ramberg-Osgood 方程,后者靠 Basquin 弹性项与 Coffin-Manson 塑性项的叠加。两条曲线拟合完,还没结束——真正决定零件安全与否的,是你最后选择站在哪条统计曲线上。分析流程 七步,从原始数据到设计曲线无论是 S355 结构钢还是新牌号铸铝,流程骨架不变——变的只是系数。01本构拟合 拟合循环应力—应变曲线对所有试样绘制应力 vs. 总应变,用 Ramberg-Osgood 方程拟合:ε =σE+ (σK′)1/n′E · K′ · n′ E 是弹性模量,K′ 是循环强度系数,n′ 是循环应变硬化指数——三者共同决定了材料在给定应力下会产生多大的塑性应变。02寿命作图 绘制总应变幅 vs. 反转数把每根试样的总应变幅对反转到失效次数(2N꜀)作图;失效通常以载荷跌落(load-drop)判据定义,标志裂纹已经起始。03弹性段 用弹性应变拟合弹性直线εelastic=σf′E(2N꜀)bBasquin 关系 σf′ 为疲劳强度系数,b 为疲劳强度指数,描述高周(长寿命)区间的行为。04塑性段 用塑性应变拟合塑性直线εplastic= εf′(2N꜀)cCoffin-Manson 关系 εf′ 为延性系数,c 为延性指数,主导低周(短寿命)区间——塑性变形占主导的地方。05联合优化 参数再优化弹性直线和塑性直线是分别拟合的,两者相加得到的总应变曲线未必贴合每个数据点,需要联合再优化,让总应变—寿命曲线整体误差最小。06数据审查 离群点分析剔除或标记明显偏离趋势、或失效位置不在标距段内的试样,避免个别异常数据扭曲整条曲线。07统计设计 计算统计设计曲线把 50:50 的中位回归曲线,转换为带有明确可靠度与置信度的下限设计曲线——这才是真正能写进图纸的那条线。回归曲线的真相 50:50 回归曲线,意味着一半零件会先失效回归曲线代表的是"50% 试样已经失效"时的寿命——换句话说,如果你直接拿这条中位曲线去做设计基准,意味着理论上有 50% 的量产零件会在这个寿命之前失效。这对绝大多数工程应用来说是不可接受的。! 设计曲线的作用,就是把这条"平均水平"的曲线,系统性地下移到一个更保守、更安全的位置——即便材料批次之间存在正常的性能波动,绝大多数零件依然能达到设计寿命。回归曲线 vs. 设计曲线Reversals to Failure · 对数坐标 选择可靠度 设计曲线常用的可靠度水平可靠度越高,允许的失效概率越低,设计曲线相对回归曲线下移得也越多。可靠度 相对下移 换算 σ 水平 失效率 95% — 5 / 100 97.5% — 2.5 / 100 99% — 1 / 100 99.87% 3σ 13 / 1,000 99.9997% 4.5σ 3.4 / 1,000,000 6σ 水平 6σ 1 / 1,000,000,000 可靠度 ≠ 置信度 97.5% 可靠度,95% 置信度行业里常见的表述是 "97.5:95 设计曲线"——前一个数字是可靠度(这条线之上有多少比例的零件能存活),后一个数字是置信度(基于当前样本量,我们对这个可靠度估计有多大把握)。测试的样本越多,散布带的估计就越稳定,置信度自然越高;样本量少的时候,同样声称"97.5% 可靠度",其实底气要弱得多——这也是为什么小样本的设计曲线往往要下移得更保守。散布带与样本量数据点越多 · 分布估计越稳 2 项核心方程:Basquin + Coffin-Manson 5 参数E · K′ · n′ · σf′,b · εf′,c 1 决策可靠度 / 置信度水平 写在最后 曲线是拟合出来的,安全是选出来的Ramberg-Osgood 和 Coffin-Manson 方程负责把散乱的试验点变成一条平滑曲线,但真正决定零件安全边界的,是最后那一步看似"简单"的选择——用哪条可靠度、哪个置信度的设计曲线去校核你的零件。曲线拟合是数学问题,可靠度选择是工程判断,两者缺一不可。疲劳工程笔记 · 应变—寿命方法参考方法学:ASTM E606(应变控制疲劳试验)来源:ABAQUS仿真世界

未登录
还没有评论
课程
培训
服务
行家
VIP会员 学习计划 福利任务
下载APP
联系我们
帮助与反馈