介绍一个开源数据集-nuScenes
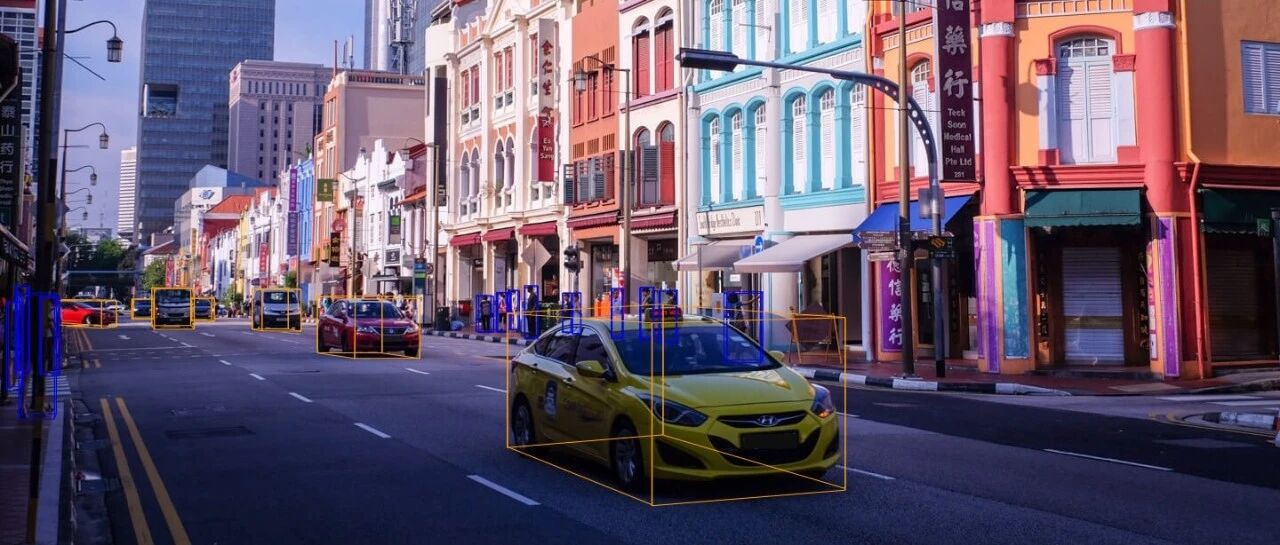
在波士顿和新加坡的街头,一辆特别的汽车正在穿梭行驶,它身上装载着价值数十万美元的传感器系统,每秒钟都在捕捉周围环境的丰富信息——这便是nuScenes数据集的诞生故事。 01 数据集简介 当谈到自动驾驶技术时,数据就像是训练AI驾驶员的“驾校教材”。在众多教材中,nuScenes数据集被誉为自动驾驶领域的黄金标准,是最全面、最丰富的公开数据集之一。 它由Motional(前身为nuTonomy)团队开发,包含了1000个精心挑选的驾驶场景,每个场景时长20秒,总计约15小时的驾驶数据。这些数据捕捉自波士顿和新加坡这两个交通密集、驾驶环境极具挑战性的城市。 以下内容翻译自官网-Overview (https://www.nuscenes.org/): nuScenes数据集(发音为/nuːsiːnz/)是由Motional(前身为nuTonomy)团队开发的自动驾驶领域公开大规模数据集。Motional致力于让无人驾驶汽车成为安全、可靠且可普及的现实。通过向公众开放部分数据,Motional旨在支持计算机视觉和自动驾驶领域的公共研究。 为此,我们在波士顿和新加坡这两个以交通密集和极具挑战性的驾驶路况而闻名的城市,采集了1000个驾驶场景。这些时长20秒的场景经过人工筛选,展现了多样化且具有代表性的驾驶操作、交通状况和意外行为。nuScenes丰富的复杂性将推动开发出能够在城市区域实现安全驾驶的方法——每个场景中都包含数十个需要识别的物体。在不同大洲采集数据使我们能够研究计算机视觉算法在不同地理位置、天气条件、车辆类型、植被环境、道路标线以及左右舵交通模式下的泛化能力。 为支持目标检测与跟踪等常见计算机视觉任务,我们在整个数据集上以2Hz的频率对23个物体类别进行了精确的3D边界框标注。此外,我们还标注了物体级属性,包括可见性、活动状态和姿态等信息。 2019年3月,我们发布了包含全部1000个场景的完整nuScenes数据集。完整数据集包含约140万张相机图像、39万次激光雷达扫描、140万次毫米波雷达扫描,以及在4万个关键帧中标注的140万个物体边界框。后续还将发布更多特性(地图图层、原始传感器数据等)。我们还在CVPR 2019自动驾驶研讨会期间举办了nuScenes 3D检测挑战赛。 nuScenes数据集的创建灵感源于开创性的KITTI数据集。它是首个提供自动驾驶汽车完整传感器套件数据(6个摄像头、1个激光雷达、5个毫米波雷达、GPS、IMU)的大规模数据集。与KITTI相比,nuScenes包含的物体标注数量是其7倍之多。 此前发布的大多数数据集(如Cityscapes、Mapillary Vistas、Apolloscapes、Berkeley Deep Drive)主要关注基于摄像头的物体检测,而nuScenes的目标是涵盖整个传感器套件的数据。 2020年7月,我们发布了nuScenes-lidarseg数据集,为该数据集关键帧中的每个激光雷达点云标注了32种可能的语义标签(即激光雷达语义分割),最终形成包含40,000个点云帧、覆盖1000个场景(其中850个用于训练和验证,150个用于测试)共计14亿个标注点的大规模语义分割数据集。 nuScenes数据集可免费用于非商业用途。非商业用途指主要非为商业优势或金钱报酬而使用。非商业用途包括但不限于个人使用、教育机构(如中小学、专科院校、大学等)使用以及某些研究用途。如需将nuScenes数据集用于商业用途,请发送邮件至nuScenes@motional.com联系商业许可事宜。 我们期待该数据集能够助力全球研究人员开发更安全的自动驾驶技术。 02 数据集概况:为什么nuScenes如此特别? nuScenes数据集不同于普通的图像或视频集 合。它是一个多传感器融合的综合性数据集,提供了自动驾驶车辆可能遇到的各种复杂场景。 数据集之所以选择波士顿和新加坡,是因为这两座城市代表了不同的驾驶文化、道路结构和天气条件。新加坡是右舵驾驶,热带气候;波士顿是左舵驾驶,温带气候。这种多样性为研究自动驾驶算法在不同条件下的泛化能力提供了理想环境。 Boston Seaport Singapore Queenstown Singapore One North Singapore Holland Village nuScenes的丰富复杂性鼓励开发者创建能够安全应对城市驾驶挑战的方法,每个场景中都包含几十个需要识别和跟踪的对象。 03 传感器配置:自动驾驶的“五官系统” nuScenes数据集通过精心设计的采集车收集数据,车上配备了完善的传感器套件,就像是赋予了自动驾驶系统人类的五官感觉,甚至更加精准。 视觉系统:6个摄像头分别位于车辆的前方、右前方、左前方、后方、右后方和左后方,形成了360度的环视视野,捕捉不同视角的图像。 激光系统:1个激光雷达(LIDAR)放置在车顶中央,通过发射激光束并测量反射时间来获取周围环境的高精度3D点云数据。 毫米波系统:5个毫米波雷达分别位于车辆的前后左右,能够探测物体的相对速度和距离,即使在恶劣天气条件下也能表现良好。 定位系统:IMU(惯性测量单元)和GPS提供车辆的精确位置和姿态信息,为其他传感器数据提供空间上下文。 这种多传感器融合的配置使nuScenes数据集能够全面反映驾驶环境的复杂性和多样性,为研究者提供了前所未有的多维度信息。 04 数据内容:海量而精细的标注 nuScenes数据集不仅提供了原始传感器数据,还包含了丰富精细的标注信息,这些都是由人工专家完成并通过多重验证确保高度准确。 数据集包含约140万个相机图像、39万个激光雷达扫描、140万个雷达扫描。在4万个关键帧中标注了140万个对象边界框,覆盖了23个对象类别,包括车辆、行人、自行车等。 每个对象都标注了对象级别的属性,如可见性、活动和姿势。数据集还提供了详细的校准信息、地图数据和车辆姿态数据,为研究者提供了全面的研究支持。 05 如何获取nuScenes数据集? 获取nuScenes数据集需要从官网下载,并按照要求注册和获取访问权限。官方下载网址为:https://www.nuscenes.org/nuscenes#download 有很多版本可以下载,初学者可以只下载mini版(不到4G),以了解/学习数据集的结构。 下载后的文件结构如下: 数据集有多个版本:完整版(Trainval、Test):包含全部1000个场景,数据量巨大(约550G+)Mini版:小型子集,约4GB,适合初学者熟悉数据结构和内容06 如何使用nuScenes数据集? 使用nuScenes数据集通常需要以下步骤: 安装开发工具:安装nuscenes-devkit等开发工具,方便读取和处理数据集。pip install nuscenes-devkit==1.0.5 注:nuscenes-devkit 是nuScenes数据集官方配套的Python工具包,堪称自动驾驶研究的“瑞士军刀”。它能高效加载和解析数据集复杂的多模态数据(包括摄像头、激光雷达、雷达等),并通过强大的可视化功能将抽象的传感器数据与3D标注框融合显示,让用户直观理解场景。同时,该工具包提供了标准化的模型评估流程,支持nuScenes检测分数(NDS)等权威指标计算,便于量化算法性能。此外,它还支持数据查询、结果导出和挑战赛提交,极大简化了从数据探索到算法评测的全流程,是使用nuScenes数据集不可或缺的桥梁。 工具源码仓库:https://github.com/nutonomy/nuscenes-devkit 数据结构熟悉:了解数据集的结构和标注格式,熟悉各个文件的作用和含义。nuScenes数据集的结构清晰明了,主要分为scene、sample和sample_data三个层级。 数据预处理:由于原始数据中包含大量冗余信息和噪声,需要进行数据清洗和预处理,包括去除无效数据、校准不同传感器间的时间戳和坐标系等。 算法开发与评估:根据研究需求编写代码,读取和处理数据集,进行算法开发和评估。nuScenes提供了专门的评估指标和基准测试,方便研究者比较不同算法的性能。 07 应用场景:从研究到现实世界 nuScenes数据集在自动驾驶领域有着广泛的应用场景,主要包括以下几个方面: 目标检测与跟踪:利用相机图像和激光雷达数据,对道路上的车辆、行人等目标进行检测和跟踪。 行为预测:通过分析驾驶场景中的交通参与者行为,预测其未来的运动轨迹。环境感知:结合多传感器数据,构建高精度的环境感知模型,为自动驾驶车辆提供全面的环境信息。 算法评估:作为自动驾驶算法的评估基准,帮助研究者评估算法的性能和泛化能力。 纯视觉3D目标检测:即使不使用激光雷达和毫米波雷达,仅使用6个摄像头也能完成车外360度的3D目标检测任务,这项技术正在推动更低成本自动驾驶方案的发展。 结语: nuScenes数据集就像是一本自动驾驶领域的百科全书,记录了城市交通的丰富场景和复杂挑战。它不仅是研究人员测试算法的试验场,更是连接人工智能与真实驾驶世界的桥梁。正如一位开发者所说:“nuScenes给了我们一双自动驾驶的眼睛,让我们能看到AI所见的世界,理解AI所面临的挑战,并最终教会AI如何安全地在这个复杂的世界导航。” 以上,本文完。来源:车路漫漫