超算互联网|工业仿真算力平台 国产工业软件-仿真秀
- 工程师知识社区
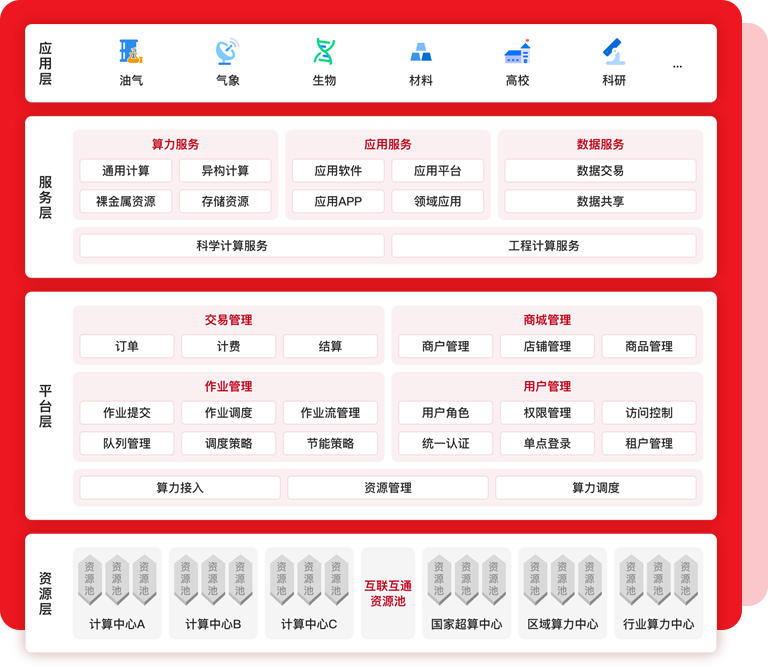
- 依托超算互联网平台,打造面向工业工程师的一站式学习与交流阵地,整合课程、资料、直播、资源库,覆盖仿真、设计、制造等多领域技术内容,助力工程师高效成长。

实战课程库
- 多领域精品课程全覆盖,从入门到进阶,适配不同阶段工程师学习需求
- 课程案例直连超算算力,在线完成大规模计算,无需本地高配设备
- 配套平台工业软件实操,真实场景同步练习,边学边练快速上手

技术知识库
- 海量行业技术资料、标准文档、案例解析,一站式获取
- 软件操作手册、最佳实践、解决方案全收录,高效解决工作痛点
- 社区用户共创内容,动态更新,形成工程师专属知识沉淀

专家直播厅
- 行业专家、资深工程师定期直播授课,拆解复杂技术与行业趋势
- 实时互动答疑,现场解决工程师遇到的技术难题
- 聚焦前沿技术与热门应用,持续更新直播主题,紧跟行业动态

工具与资源库
- 课程与项目配套超算算力资源,支撑大规模计算任务
- 平台工业软件免费试用权限,降低学习与实践成本
- 可复用的模型、模板、案例文件,直接提升工程师工作效率
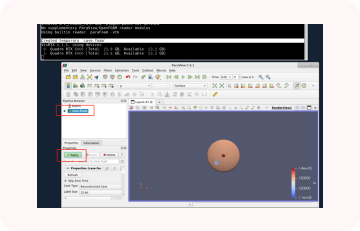
OpenFOAM 多节点并行计算
- 模拟搅拌器内部的流体流动特性,优化设计参数。
- OpenFOAM-2306。
- 调用16/64/128 核并行计算,Paraview 和Linux 桌面可视化后处理。
- OpenFOAM 算例运行时间随着核数的增加呈现明显的线性关系。
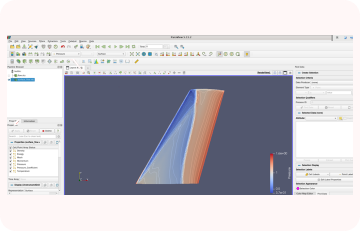
SU2 跨音速流动仿真
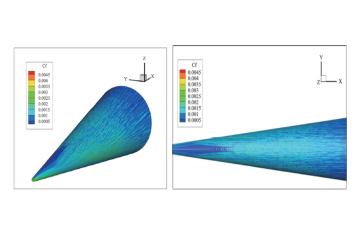
- M6 机翼跨音速复杂流动(58 万四面体网格)。
- SU2 v7.1.1。
- 分配1~ 64 核并行资源,在 ParaView 或 Tecplot 中进行可视化。
- 该算例展现了较强的并行性能,从 1 核到 32 核并行加速比基本呈线性。
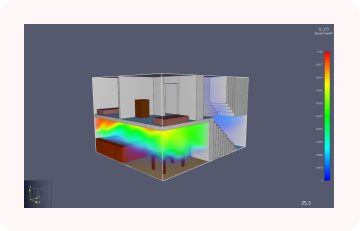
FDS 火灾模拟
- 双层建筑火灾及烟气扩散模拟。
- FDS 6.9.1。
- 启用 2 个CPU节点计算,使用软件集成的Smokeview 进行结果后处理,使用 PyroSim 软件进行深度后处理。
- 加载数据生成 2D 和 3D 图像,直观了解火灾场景的动态变化。
某科研中心风雷软件 DCU 优化
· 并行效率提升至 80%,单次仿真成本降低 40%。
· 完成国产化全链路验证,获工信部专项认证。
国产 DCU 加速卡并行效率不足 30%,仿真周期长。
· 提供国产 CPU/DCU 混合算力资源
· 工程师定制环境部署与参数调优
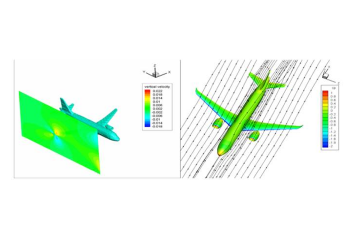
某能源企业风流场仿真
· 仿真效率提升了 10-40 倍。
· 自动化流程脚本一键提交。
本地算力资源不足,有高并发及作业监控需求。
· 计算波峰提供 2500 节点,8w 核并行计算。
· 技术支持即时响应,专题培训。
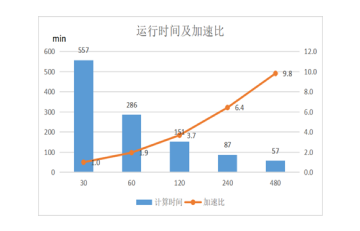
OpenCFD-SCU 基于国产异构加速卡的移植适配
· 并行效率提升至 80%,单次仿真成本降低 40%。
· 完成国产化全链路验证,获工信部专项认证。
国产 DCU 加速卡并行效率不足 30%,仿真周期长。
· 提供国产 CPU/DCU 混合算力资源。
· 工程师定制环境部署与参数调优。