一区Top综述 || 从理论走向工业:复杂环境下基于深度学习的轴承故障诊断研究综述(上)
一次轴承故障,可能让整条产线停摆。深度学习能让机器“听”出故障的苗头吗?这篇最新综述给出答案:方法已经成熟,落地才是难关——噪声干扰、样本稀缺、工况漂移,三大拦路虎如何破解?一文读懂智能故障诊断的现状与未来。
本期给大家推荐这篇辽宁石油化工大学教授团队的论文。本文系统梳理了2021—2025年间基于深度学习的滚动轴承故障诊断研究。文章首先介绍主流公开数据集(如CWRU、PRONOSTIA、IMS等)与评价指标,进而分类剖析CNN、LSTM、自编码器、GAN、DBN、迁移学习及元学习等七类方法在数据不平衡、强噪声干扰、变工况、样本稀缺等复杂场景下的改进策略与性能表现;随后结合高速列车牵引电机、海上风电、数控机床等工业案例,从部署可行性视角分析计算负载、实时性与系统集成等工程瓶颈;最后指出数据质量、模型可解释性、跨域泛化和边缘部署等现存挑战,并展望物理信息生成模型、故障诊断基础模型、联邦学习、自监督学习与数字孪生驱动的闭环自主运维系统等未来方向,为该领域从理论走向工业落地提供了清晰的路线图。 由于文章篇幅过长,小编将分两次为大家翻译介绍这篇论文。第一篇推文系统综述了该领域的数据基础与主流深度学习方法。在数据层面,文章梳理了CWRU、PRONOSTIA、IMS等实验室数据集与GE、SKF等工业现场数据集的特征差异,并给出了分类、回归、实时性三个维度的统一评估准则与实验可复现性规范;在方法层面,文章重点解读了撑起该领域半壁江山的三大主力模型——卷积神经网络、长短期记忆网络与自编码器,系统总结了它们在应对数据不平衡、强噪声干扰、动态工况变化等复杂工业挑战时的改进策略与固有局限。
论文链接:通过点击最左下角的阅读原文进行在线阅读及下载。
一次轴承故障,可能让整条产线停摆。深度学习能让机器“听”出故障的苗头吗?这篇最新综述给出答案:方法已经成熟,落地才是难关——噪声干扰、样本稀缺、工况漂移,三大拦路虎如何破解?一文读懂智能故障诊断的现状与未来。
本期给大家推荐这篇辽宁石油化工大学教授团队的论文。本文系统梳理了2021—2025年间基于深度学习的滚动轴承故障诊断研究。文章首先介绍主流公开数据集(如CWRU、PRONOSTIA、IMS等)与评价指标,进而分类剖析CNN、LSTM、自编码器、GAN、DBN、迁移学习及元学习等七类方法在数据不平衡、强噪声干扰、变工况、样本稀缺等复杂场景下的改进策略与性能表现;随后结合高速列车牵引电机、海上风电、数控机床等工业案例,从部署可行性视角分析计算负载、实时性与系统集成等工程瓶颈;最后指出数据质量、模型可解释性、跨域泛化和边缘部署等现存挑战,并展望物理信息生成模型、故障诊断基础模型、联邦学习、自监督学习与数字孪生驱动的闭环自主运维系统等未来方向,为该领域从理论走向工业落地提供了清晰的路线图。 由于文章篇幅过长,小编将分两次为大家翻译介绍这篇论文。第一篇推文系统综述了该领域的数据基础与主流深度学习方法。在数据层面,文章梳理了CWRU、PRONOSTIA、IMS等实验室数据集与GE、SKF等工业现场数据集的特征差异,并给出了分类、回归、实时性三个维度的统一评估准则与实验可复现性规范;在方法层面,文章重点解读了撑起该领域半壁江山的三大主力模型——卷积神经网络、长短期记忆网络与自编码器,系统总结了它们在应对数据不平衡、强噪声干扰、动态工况变化等复杂工业挑战时的改进策略与固有局限。
论文链接:通过点击最左下角的阅读原文进行在线阅读及下载。
本期给大家推荐这篇辽宁石油化工大学教授团队的论文。本文系统梳理了2021—2025年间基于深度学习的滚动轴承故障诊断研究。文章首先介绍主流公开数据集(如CWRU、PRONOSTIA、IMS等)与评价指标,进而分类剖析CNN、LSTM、自编码器、GAN、DBN、迁移学习及元学习等七类方法在数据不平衡、强噪声干扰、变工况、样本稀缺等复杂场景下的改进策略与性能表现;随后结合高速列车牵引电机、海上风电、数控机床等工业案例,从部署可行性视角分析计算负载、实时性与系统集成等工程瓶颈;最后指出数据质量、模型可解释性、跨域泛化和边缘部署等现存挑战,并展望物理信息生成模型、故障诊断基础模型、联邦学习、自监督学习与数字孪生驱动的闭环自主运维系统等未来方向,为该领域从理论走向工业落地提供了清晰的路线图。 由于文章篇幅过长,小编将分两次为大家翻译介绍这篇论文。第一篇推文系统综述了该领域的数据基础与主流深度学习方法。在数据层面,文章梳理了CWRU、PRONOSTIA、IMS等实验室数据集与GE、SKF等工业现场数据集的特征差异,并给出了分类、回归、实时性三个维度的统一评估准则与实验可复现性规范;在方法层面,文章重点解读了撑起该领域半壁江山的三大主力模型——卷积神经网络、长短期记忆网络与自编码器,系统总结了它们在应对数据不平衡、强噪声干扰、动态工况变化等复杂工业挑战时的改进策略与固有局限。
论文链接:通过点击最左下角的阅读原文进行在线阅读及下载。
本期给大家推荐这篇辽宁石油化工大学教授团队的论文。本文系统梳理了2021—2025年间基于深度学习的滚动轴承故障诊断研究。文章首先介绍主流公开数据集(如CWRU、PRONOSTIA、IMS等)与评价指标,进而分类剖析CNN、LSTM、自编码器、GAN、DBN、迁移学习及元学习等七类方法在数据不平衡、强噪声干扰、变工况、样本稀缺等复杂场景下的改进策略与性能表现;随后结合高速列车牵引电机、海上风电、数控机床等工业案例,从部署可行性视角分析计算负载、实时性与系统集成等工程瓶颈;最后指出数据质量、模型可解释性、跨域泛化和边缘部署等现存挑战,并展望物理信息生成模型、故障诊断基础模型、联邦学习、自监督学习与数字孪生驱动的闭环自主运维系统等未来方向,为该领域从理论走向工业落地提供了清晰的路线图。 由于文章篇幅过长,小编将分两次为大家翻译介绍这篇论文。第一篇推文系统综述了该领域的数据基础与主流深度学习方法。在数据层面,文章梳理了CWRU、PRONOSTIA、IMS等实验室数据集与GE、SKF等工业现场数据集的特征差异,并给出了分类、回归、实时性三个维度的统一评估准则与实验可复现性规范;在方法层面,文章重点解读了撑起该领域半壁江山的三大主力模型——卷积神经网络、长短期记忆网络与自编码器,系统总结了它们在应对数据不平衡、强噪声干扰、动态工况变化等复杂工业挑战时的改进策略与固有局限。
论文链接:通过点击最左下角的阅读原文进行在线阅读及下载。
由于文章篇幅过长,小编将分两次为大家翻译介绍这篇论文。第一篇推文系统综述了该领域的数据基础与主流深度学习方法。在数据层面,文章梳理了CWRU、PRONOSTIA、IMS等实验室数据集与GE、SKF等工业现场数据集的特征差异,并给出了分类、回归、实时性三个维度的统一评估准则与实验可复现性规范;在方法层面,文章重点解读了撑起该领域半壁江山的三大主力模型——卷积神经网络、长短期记忆网络与自编码器,系统总结了它们在应对数据不平衡、强噪声干扰、动态工况变化等复杂工业挑战时的改进策略与固有局限。
论文链接:通过点击最左下角的阅读原文进行在线阅读及下载。
由于文章篇幅过长,小编将分两次为大家翻译介绍这篇论文。第一篇推文系统综述了该领域的数据基础与主流深度学习方法。在数据层面,文章梳理了CWRU、PRONOSTIA、IMS等实验室数据集与GE、SKF等工业现场数据集的特征差异,并给出了分类、回归、实时性三个维度的统一评估准则与实验可复现性规范;在方法层面,文章重点解读了撑起该领域半壁江山的三大主力模型——卷积神经网络、长短期记忆网络与自编码器,系统总结了它们在应对数据不平衡、强噪声干扰、动态工况变化等复杂工业挑战时的改进策略与固有局限。
论文链接:通过点击最左下角的阅读原文进行在线阅读及下载。
论文基本信息
论文题目: From theory to industry: A survey of deep learning-enabled bearing fault diagnosis in complex environments
论文期刊:Engineering Applications of Artificial Intelligence
Doi:https://doi.org/10.1016/j.engappai.2025.113068
a Department of Mechanical Engineering, Liaoning Petrochemical University, Wanghua district, Fushun city, Liaoning Province, China
b Kunlun Anjian (Beijing) Technology Co., Ltd, Shunyi district, Beijing city, China
摘要
目录
1 引言
2 现有数据集与实验评估准则
2.1 数据集
2.2 评估准则
2.3. 实验设置与可复现性考虑
3 基于深度学习的轴承故障诊断方法
3.1 卷积神经网络
3.2 长短期记忆网络
3.3 自编码器
3.4 生成对抗网络
3.5 深度信念网络
3.6 迁移学习
3.7 元学习
3.8 其他先进网络
4 面向工业环境的系统部署挑战与案例研究
4.1 实际部署中的技术挑战
4.2 典型工业应用实例
5 深度学习当前面临的问题
5.1 数据质量与数据集问题
5.2 模型选择与训练问题
5.3 特征提取与表征问题
5.4 实时与在线诊断问题
5.5 跨域适应问题
5.6 模型集成与多模态融合问题
5.7 工业实际应用瓶颈
6 结论与未来工作
6.1 数据层面
6.2 模型层面
6.3 应用层面
1 引言
滚动轴承是旋转机械中的关键部件,被广泛应用于航空航天、轨道交通、石油化工及其他工程领域(Lei et al., 2024;Huang et al., 2024)。如图1所示,轴承故障的发生率在不同领域各不相同。这些部件通常在以重载、高温、严重腐蚀和高运行率为特征的复杂恶劣环境中工作。这些部件的功能直接影响整套装置的性能与可靠性(Wang et al., 2024a;Li et al., 2020)。然而,轴承在运行过程中不可避免地会因腐蚀、磨损和断裂等因素发生故障。这些故障会引发异常振动、噪声及其他扰动,从而降低 制造效率,并可能危及人员安全(Ji et al., 2025;Miao et al., 2023;Yan et al., 2023a;Han et al., 2025)。因此,滚动轴承缺陷诊断(fault diagnostics,FD)的研究十分必要,并已成为保障机械安全可靠运行的关键技术。快速识别机械设备中的故障,对于确保设备的长期运行寿命和提高生产效率具有重要意义(Fu et al., 2025;Li et al., 2024a)。
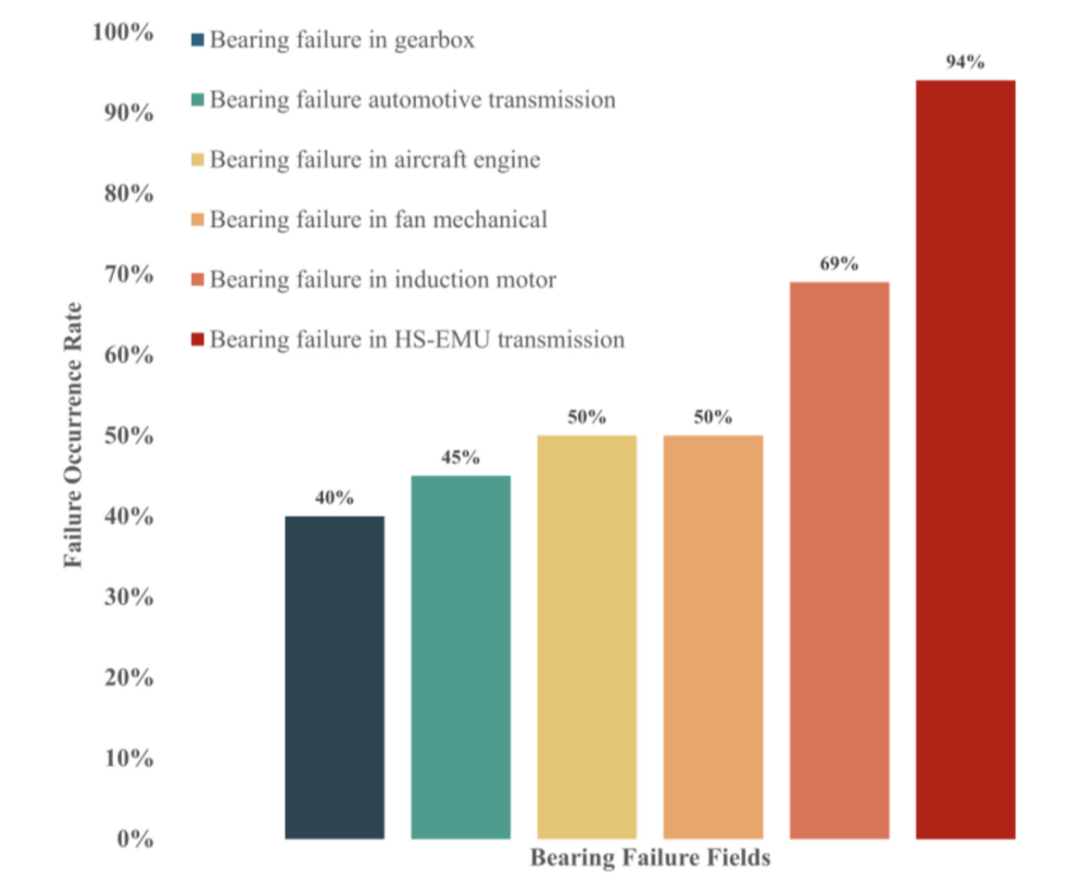
图1 轴承故障在各类故障中所占的比例
近年来,随着智能诊断技术的快速发展,轴承故障诊断领域涌现出诸多创新性复合方法,为轴承诊断问题提供了多源解决方案。对现有轴承FD技术研究的综合分析表明,存在三种主流体系:机理驱动诊断(Jiang et al., 2025;Wang et al., 2017;Zhou et al., 2023a)、信号处理驱动诊断(Hamdaoui et al., 2023;Tao et al., 2023;Wen et al., 2020)和数据驱动诊断(Zhang et al., 2023a;Tao et al., 2024)。这些体系在方法特征和实现路径上各不相同。各体系在理论基础与应用方面存在显著差异:机理驱动诊断方法涉及建立滚动轴承系统的动力学模型并分析其失效机理。该方法的一个显著优点是能够系统地识别与滚动轴承故障相关的潜在失效机理。然而,由于模拟多体耦合系统的复杂性,该方法对研究者的跨学科专业知识要求较高,从而限制了其工程应用效率。信号处理诊断领域涉及对包括振动和声学在内的多源传感器信号的检查与研究。该方法的优点在于擅长特征提取并具有抗噪能力,但需注意其对参数的高敏感性。数据驱动诊断利用深度神经网络强大的表征能力,通过端到端特征学习完成故障模式识别。该方法的主要优点在于无需对故障诊断对象具备全面理解即可获得最优的故障识别结果。然而,一个显著缺点是神经网络的训练需要大量的标注数据。
诊断技术的演进以及对先验知识的依赖程度,决定了轴承故障诊断方法可分为两大类:传统方法与人工智能方法。传统轴承FD技术主要可分为五类:(1)振动分析方法:振动分析是轴承故障检测中最主要的技术(Dolenc et al., 2016)。该方法通过分析机械振动信号的时频特性,实现对故障类型的准确诊断(Ghorbel et al., 2024)。采集到的振动信号经时域分析、频域分析和时频分析处理,以识别故障特征,其流程如图2所示。(2)声发射方法:在运行过程中,尤其是局部故障发生时,轴承会产生声信号,通常表现为高频噪声(Pham et al., 2020)。通过声发射传感器监测轴承的声发射信号,分析其波形、频谱等,可以判定轴承故障的类型。该技术的一个显著优点是能够在早期检测出微小故障,从而起到早期预警系统的作用。(3)温度监测方法:在运行过程中,轴承受摩擦、载荷等因素影响而产生一定热量(Wu et al., 2024)。当轴承发生故障时,局部摩擦加剧,导致温度异常升高。因此,利用温度传感器监测轴承温度变化有助于发现故障。(4)油液分析方法:基于润滑油状态监测,可有效识别油润滑轴承系统中的早期磨损模式与失效机理,为滚动接触疲劳和黏着等典型故障提供关键诊断信息(Zhao et al., 2023a),其流程如图3所示。(5)电流信号分析方法:对于电机驱动的轴承系统,电流信号分析可作为评估轴承健康状态的诊断工具(Chen et al., 2023a)。研究表明,轴承故障会引起电机负载变化,进而影响电流波形。通过对电流波形的细致监测与分析,可以辨别轴承故障的特征,尤其是由电机负载波动引起的电流异常。
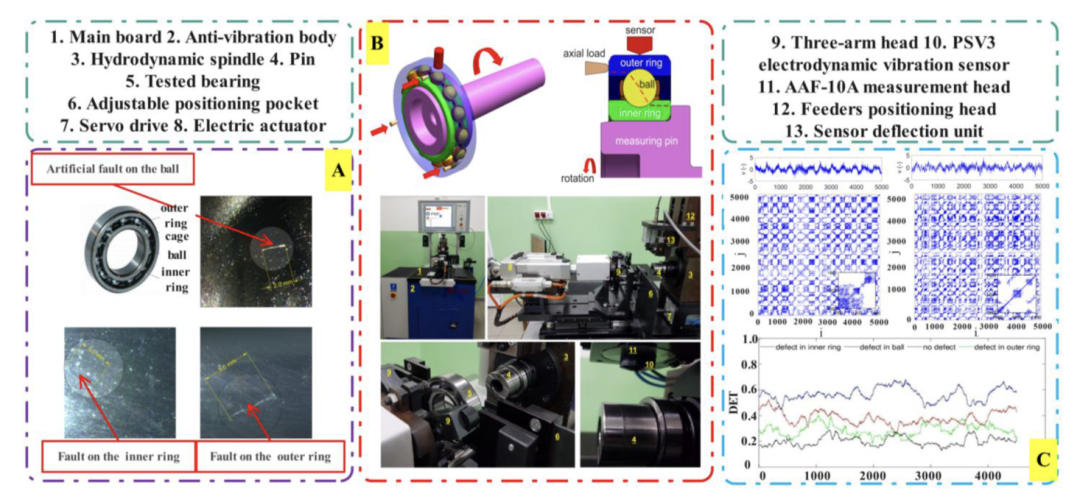
图2 基于振动信号的轴承诊断流程(Kecik et al., 2022)。A:滚动轴承6208C3的图示(a)、滚动体上的人工缺陷(b)、内圈缺陷(c)与外圈缺陷(d)。B:位于波兰克拉希尼克(Krasnik)波兰轴承厂的轴承动态测试实验装置。C:针对该轴承计算得到的递归图
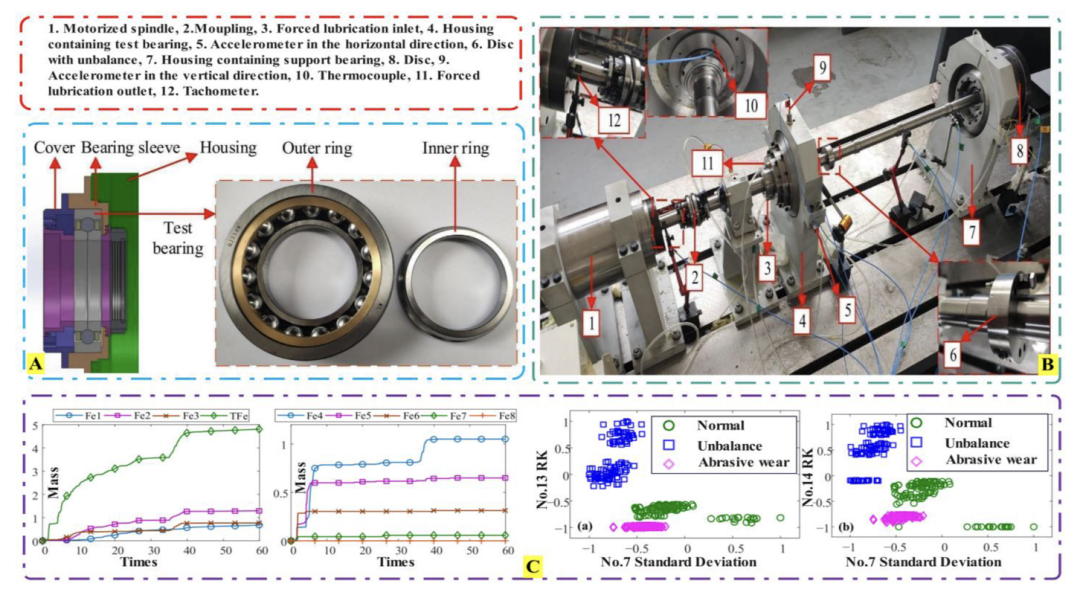
图3 基于油液检测的轴承故障诊断流程(Zhao et al., 2023a)。A:试验轴承及其安装。B:滚动轴承-转子系统试验台的配置及传感器布置。C:(a) 标准差与RK的散点图;(b) 标准差与RS的散点图
尽管已有众多优秀的综述论文探讨了基于深度学习的轴承故障诊断,但大多数聚焦于模型架构的演化以及在基准数据集上的性能提升。本综述采用批判性视角,着重探讨将该技术从实验室理论过渡到工业现场部署时所面临的挑战与解决方案。我们特别关注深度学习模型在复杂、动态、数据稀缺的真实工业环境中的鲁棒性、可解释性与部署可行性。具体而言,本文旨在通过以下方面填补现有文献的空白:
面向部署的评估框架:超越诊断准确率,系统评估模型在分布外数据上的鲁棒性、计算效率以及在真实工业系统中的集成能力。
跨工况与域自适应:深入分析应对工况变化、噪声干扰和未知失效模式的先进策略——如迁移学习与元学习,这些对模型在真实世界中的可靠性至关重要。
从数据到数字孪生:超越传统诊断范式,探讨如何将深度学习模型与数字孪生及物理信息融合相结合,以构建更智能、更主动的状态监测系统。
本综述区别于以往工作的核心贡献可归纳为以下五点:
以部署为中心的视角:建立了以工业部署可行性为中心的批判性分析框架,系统阐述了深度学习模型在计算负载、实时性能和系统集成方面的挑战与进展。
跨工况鲁棒性的深入分析:设立专门章节深入考察非平稳条件和分布外样本下模型的失效模式,总结提升模型泛化能力的前沿技术。
校准与不确定性量化:强调模型预测校准与不确定性量化在安全关键型工业应用中的关键重要性,回顾相关方法在故障诊断中的初步应用与未来潜力。
数字孪生集成路径:提出将深度学习诊断模型作为数字孪生的核心组件,建立从故障诊断到预测性健康管理的技术路径,并分析当前研究空白。
工业案例验证的统一基准:对风电、轨道交通等复杂环境下的工业案例研究进行标准化与综合,提供方法在真实场景中有效性的对比分析。
依赖物理机理和信号分析的传统诊断方法,凭借其可解释性与稳健性能,已在工业轴承健康监测系统中得到验证并广泛应用(Kecik et al., 2022)。然而,在复杂工况和非线性的真实工业环境中,传统诊断方法的准确性和效率可能受限。为克服传统方法在识别复杂故障模式和实现自适应诊断方面的局限,智能诊断方法被引入轴承健康监测领域。智能诊断方法可大致分为两大类:(1)基于机器学习的诊断方法:机器学习是人工智能的核心分支,其本质在于通过数据训练模型,使计算机系统能够从经验中学习并提升性能,并基于统计学习理论优化模型的泛化能力。常见的机器学习算法包括线性回归、逻辑回归、支持向量机、K近邻、决策树和随机森林等(Yao and Li, 2014;Ozkale et al., 2018;Ye et al., 2014;Park et al., 2016;Manwani and Sastry, 2012;Martin and Yeo, 2018)。(2)基于深度学习(deep learning,DL)的诊断方法:该方法通过端到端架构实现特征提取与决策自动化。与传统机器学习方法相比,DL采用多层非线性变换架构以增强对高维数据的特征提取,因而成为故障诊断领域的主要研究焦点。凭借分层特征提取与非线性表征能力,DL方法在轴承故障诊断中展现出显著优势(Nguyen et al., 2024)。其端到端训练模式简化了故障诊断流程(Ren et al., 2025),从而获得更高的效率与准确率。DL擅长处理高维数据,在图像、语音和文本等复杂任务中表现尤为出色(Chen et al., 2022)。其主要类型包括自编码器(Autoencoder,AE)、长短期记忆网络(Long Short-term Memory,LSTM)、循环神经网络(Recurrent Neural Network,RNN)、生成对抗网络(Generative Adversarial Network,GAN)、卷积神经网络(Convolutional Neural Network,CNN)和深度信念网络(Deep Belief Network,DBN)(Majumdar, 2019;Graves and Graves, 2012;Li et al., 2023a;Zhang et al., 2023b;Yasin et al., 2024;Tang et al., 2016)等。智能方法的持续完善正在为下一代诊断技术铺平道路。有前景的研究方向包括:采用自适应域循环变分生成对抗网络应对数据稀缺与域迁移挑战,利用可解释的时间-频率原型对比学习集成融合弥合模型准确率与人类理解之间的差距,以及通过卷积Transformer强化学习智能体实现自主的上下文感知决策。这些方法共同应对了复杂工业环境中的三大关键挑战:鲁棒性、可解释性与可部署性。尽管DL最近才成为研究焦点,但这一概念本身并不新鲜,其起源可追溯至20世纪50年代。图4展示了DL的发展历程,并按时间顺序勾勒了技术演进脉络。
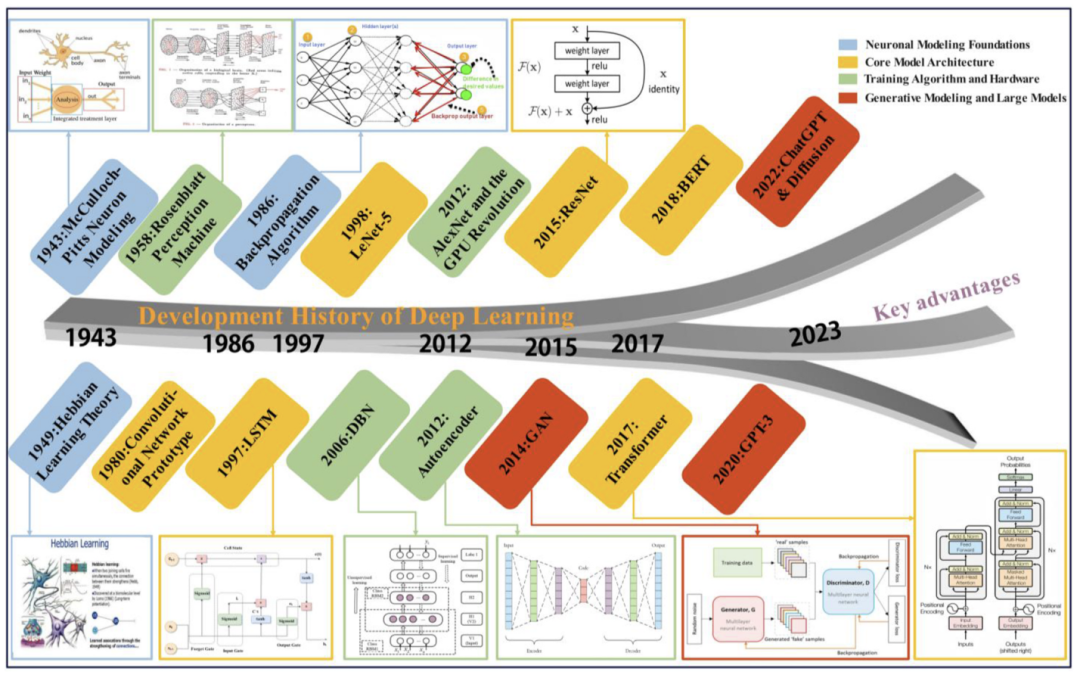
图4 深度学习的发展历程
本综述在Web of Science和IEEE(Institute of Electrical and Electronics Engineers,电气与电子工程师学会)Xplore搜索引擎中采用关键词组合检索,涵盖以下主题:“Bearings”(轴承)或"Bearing failures"(轴承故障)、“Fault Detection”(故障检测)或"Rotating Machinery"(旋转机械)、“Mechanical Fault Detection”(机械故障检测)或"Fault Diagnosis"(故障诊断)或"Intelligent Fault Diagnosis"(智能故障诊断)、“Health Monitoring”(健康监测)或"DL"、“ML”、“CNN”、“AE”、“DBN”、“LSTM”、“GAN”、“Transfer Learning”(迁移学习)、“Self-Supervised Learning”(自监督学习)、“Meta-Learning”(元学习)等。检索周期设定为最近十年,以确保本综述的时效性并保证采用最新的诊断方法。检索涵盖了大量文献。在检索到2292篇期刊文章后,其中相当一部分因不符合质量标准而被排除。经筛选,共有965篇文章进入进一步评估以确定其是否合格。本综述聚焦于基于DL的轴承FD方法。在综述过程中,472篇文章因与所讨论主题无关而被排除,另有252篇因质量不达标而被剔除。经对现有文献的全面审阅,最终共有241篇满足全部纳入标准的文章被纳入本综述。
作者认为,本文对DL方法在轴承FD与状态监测中的应用进行了系统性总结。为保证参考文献的原创性与高质量,本综述仅纳入同行评议期刊上发表的文章,同时排除会议论文、综述文章及图书章节。值得注意的是,综述中引用的所有DL方法均来自最近五年,而文中提及的部分传统方法(如振动与温度诊断)以及部分原始网络框架(如原始CNN、原始RNN)并非来自最近五年发表的文章。文献引用情况如图5所示。
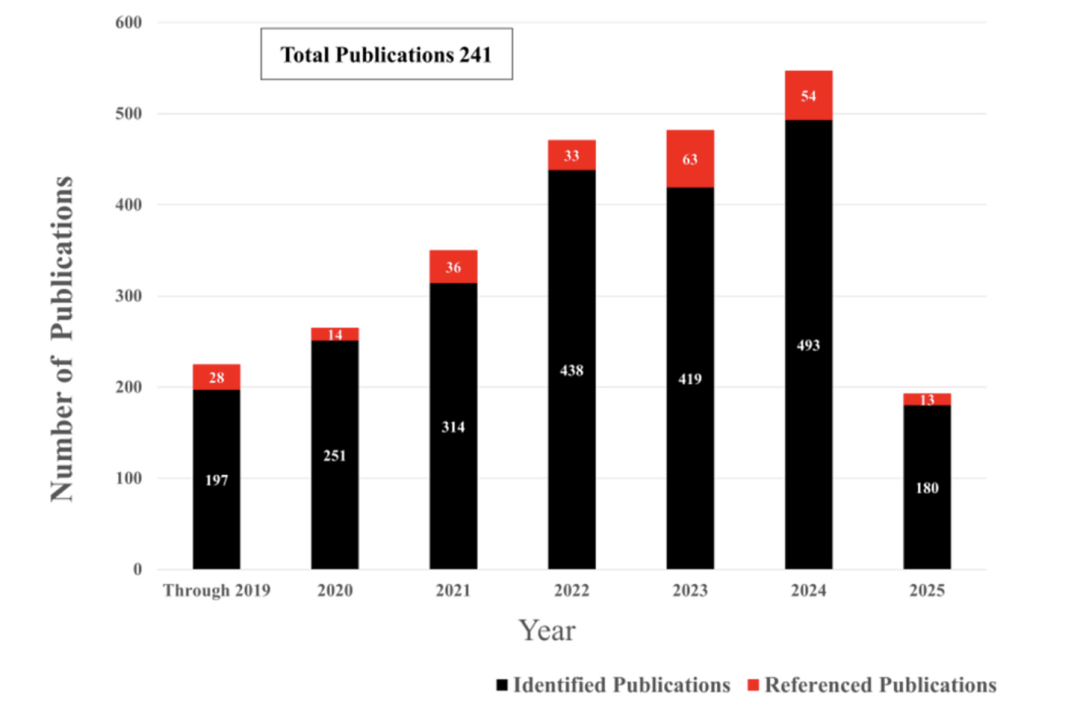
图5 发表文献数量
本文对深度学习在轴承故障诊断领域从理论基础到工业应用的研究进展进行了系统性与批判性综述。论文首先考察实验室数据集与工业现场数据集的特征以及标准化评估准则,提出涵盖跨场景鲁棒性、实时能力与计算效率的统一性能评估框架。随后,系统分类并分析各类深度学习模型的机理与适用场景,特别强调其在应对噪声和变工况等复杂工业挑战时的改进策略与局限。此外,以风力发电机和高速列车轴承诊断等工业案例为对象,从部署视角分析技术挑战与解决方案。最后,提出针对分布外泛化、数据稀缺、模型可解释性与数字孪生集成等前沿问题的未来研究方向,为学术界与工业界提供从理论验证到工业部署的清晰技术转化路径。
本文组织结构如下:第2节介绍现有数据集与评估准则;第3节讨论主流深度学习方法及其改进模型;第4节给出工业环境中的案例研究;第5节指出当前挑战与未来方向;第6节对全文进行总结。图6提供了本综述整体框架的概览。
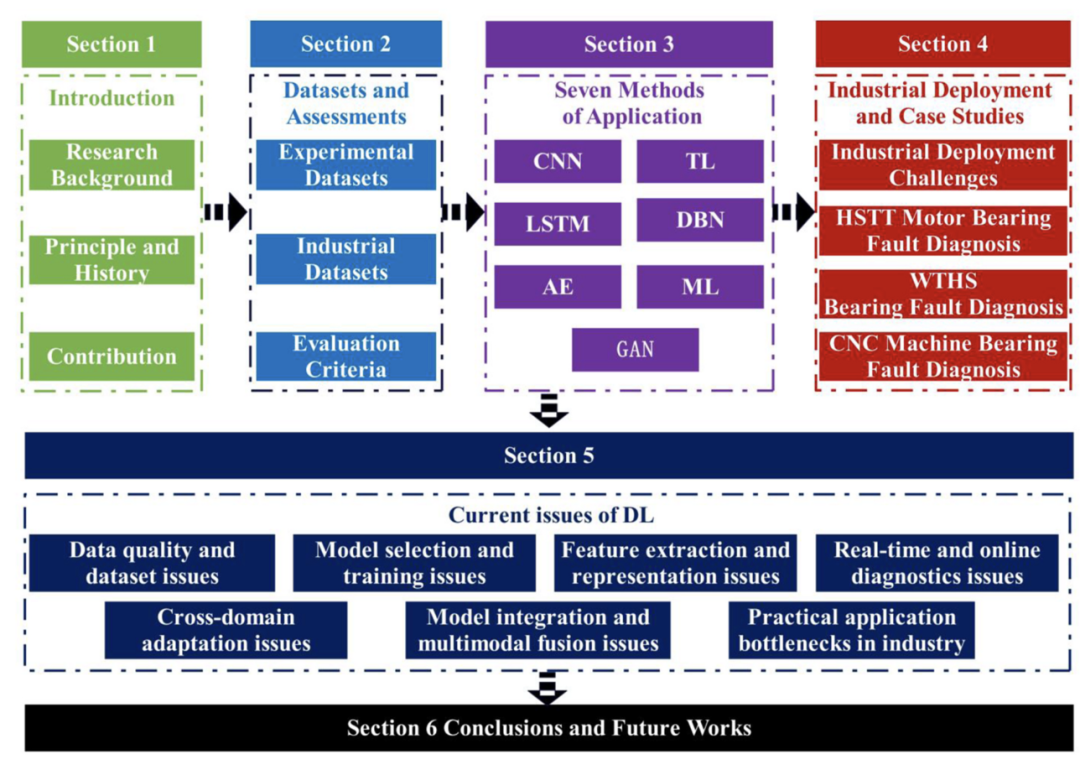
图6 展示本文献综述整体推理脉络的流程图
2 现有数据集与实验评估准则
本节将通过回顾现有知名轴承故障数据集与实验评估准则,深入评估各类诊断方法的有效性,为后续方法分析奠定数据基础。
2.1. 数据集
数据集的开放共享是推动DL技术发展的重要基础。该领域的数据集可分为两大类:实验室数据集与工业现场数据集。本节将基于这一分类框架系统阐述二者的特征与差异。
2.1.1. 实验室环境数据集
2.1.1.1. 凯斯西储大学(Case Western Reserve University,CWRU)数据集。 CWRU数据集包含四种不同的轴承健康状态:正常状态、内圈故障、外圈故障和滚动体故障。故障直径有三种:7 mils、14 mils和21 mils。电机在四种不同负载(0 hp、1 hp、2 hp和3 hp)和四种不同转速(1730 r/min、1750 r/min、1772 r/min和1797 r/min)下采集振动信号。其测试平台如图7A所示。研究对象为含人工缺陷的试验轴承,缺陷尺寸梯度设置为四个等级:0.007英寸、0.014英寸、0.021英寸和0.028英寸。驱动端轴承的缺陷数据同时以12 kHz和48 kHz双采样率采集,风扇端轴承的缺陷数据以12 kHz采样率记录。正常状态下的轴承统一以48 kHz的速率采样。
CWRU轴承数据集的应用场景:(1)基础轴承故障诊断任务;(2)变工况下的迁移学习任务;(3)仅包含单一故障。必须认识到,CWRU数据集在保留实验室数据固有局限的同时,进一步限制了其对工业场景中多故障耦合传播机理和非线性退化轨迹的表征能力。这一限制源于该数据集人工诱导的单一故障模式以及静态条件下的离散采样。
2.1.1.2. PRONOSTIA数据集。 PRONOSTIA轴承数据集包含17组加速寿命试验数据,由法国FEMTO-ST研究所发布。用于采集加速度和温度信号的试验台如图7B所示。该平台通过模拟动态工况使轴承承受可变载荷与转速。实验平台采用NSK 4804DD轴承和一台最高转速为4000 RPM的直流电机。实验每隔10 s采集一次振动信号,每次采集持续0.1 s,包含2560个数据点。采样频率为25.6 kHz。实验还同步记录三个参数:振动、温度和转速,这些参数以时间对齐方式记录。共对17组轴承进行了测试,得到17个完整寿命数据集。PRONOSTIA数据集适用于机械故障预测中的三类研究场景:(1)数据增强;(2)迁移学习;(3)不确定性量化。然而,其局限性包括实验室数据的固有局限、工况恒定、仅列出一种轴承失效模式以及样本量小。
2.1.1.3. NASA智能维护系统数据集。 本研究使用了美国辛辛那提大学智能维护系统(Intelligent Maintenance Systems,IMS)中心提供的轴承退化数据集。如图7C所示,实验平台采用四个安装在旋转轴上的Rexnord ZA-2115双列轴承,通过摩擦皮带使其保持2000 r/min的恒定转速。振动信号由安装在轴承座上的高灵敏度石英加速度计(PCB 353B33)采集,采样频率为20 kHz。该数据集适用于以下场景:(1)退化机理可解释性研究;(2)早期故障检测算法验证;(3)寿命预测模型基准测试。然而,该试验平台的结果基于受控的实验室环境,实际工业应用必须考虑工况的复杂性。
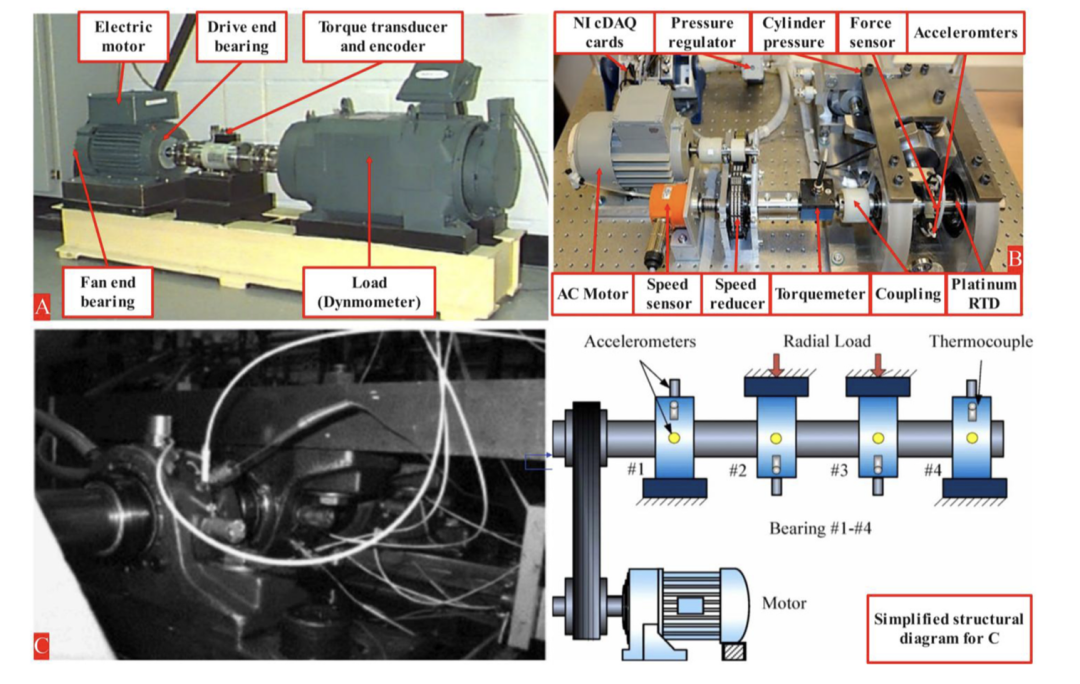
图7 A:CWRU(Case Western Reserve University,凯斯西储大学)轴承试验台;B:PRONOSTIA轴承试验台(Gousseau et al., 2016);C:IMS(Intelligent Maintenance Systems,智能维护系统)轴承试验台(Nectoux et al., 2012)
2.1.2. 工业现场数据集
2.1.2.1. 通用电气(General Electric,GE)数据集。 GE数据集是由美国通用电气公司提供的一套轴承故障数据。该数据集常用于FD、健康监测和预测性维护,包含GE工业设备轴承及机械部件的振动信号,涵盖设备的实际运行工况。基于其工业级数据源属性,该数据集为验证智能诊断算法在复杂工业场景中的域适应性与噪声鲁棒性提供了基准验证平台。它为工业设备健康管理、智能制造和预测性维护等技术的研究与应用提供了大量数据支持。这对提高运行效率和降低维护成本具有重要意义。
2.1.2.2. 东南大学数据集。 该数据集是东南大学发布的机电设备故障诊断基准数据集,聚焦于复合故障诊断与变速工况分析,适用于研究工业场景中的多故障耦合问题。数据在两种工况下采集:20 Hz(1200 RPM)空载与30 Hz(1800 RPM)负载。传感器系统包括三轴振动传感器、电机电流传感器、转速编码器和声学麦克风阵列。应用场景:(1)工业设备故障诊断;(2)变速工况下多故障分析;(3)故障耦合研究。尽管如此,其局限主要体现在以下方面:(1)单一故障模式;(2)工况多样性不足;(3)数据规模有限,总样本量仅为12000。尽管如此,该数据集仍是研究人员深入研究复杂工况下机电设备故障诊断技术的宝贵资源,有助于提高工业设备的可靠性与效率。
2.1.2.3. 瑞典斯凯孚(Svenska Kullager-Fabriken,SKF)数据集。 SKF轴承数据集是常用于轴承故障诊断、健康管理与预测性维护研究的工业数据集。SKF数据集专注于工业轴承的健康监测,包含来自全球12个工业现场2000余台设备的数据,积累时间超过五年。该数据集的主要目标是建立轴承退化的工业级基准,以推动预测性维护技术的实际落地。它已成为推动工业设备健康管理技术进步的重要数据来源。SKF轴承数据集的主要数据类型包括:时域、频域、时频域数据以及故障标签。它通常包含多个轴承测试案例,每个案例包含振动信号、转速数据、温度数据和载荷数据。每个数据文件包含详细的振动数据、运行工况和故障标签,便于后续分析、建模与故障诊断。此外,该数据集还可用于训练和测试预测剩余使用寿命的模型。
数据集中的振动信号和故障标签使企业能够实时监测轴承健康状况、实施预测性维护,避免因轴承故障导致的突发停机。这为推进工业设备健康管理与智能制造技术奠定了坚实基础。
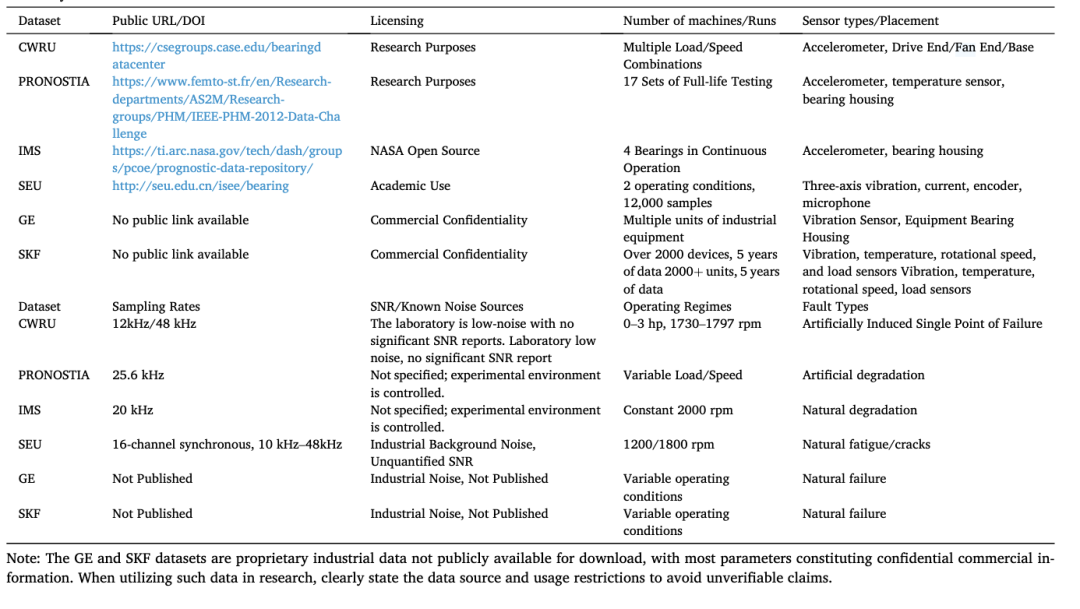
为增强数据集的覆盖面和可比性,我们编制了表1,汇总了主流轴承故障诊断数据集的关键信息。表中包括公开可访问的链接、许可详情、数据集规模、传感器配置、采样率、噪声特性、运行工况和故障类型。对于某些工业数据集(如GE、SKF),详细参数未完全公开,在表中标记为“Not disclosed”(未披露)或“Industrial confidential”(工业机密)。
表1 主流数据集详情汇总
2.2. 评估准则
轴承故障诊断的评估准则是衡量各类诊断技术有效性的基础。需根据任务类型(分类、回归或实时)选择合适的指标。以下从分类任务指标、回归任务指标和实时指标三个维度详细阐述评估准则。
2.2.1. 分类任务指标
如图 2 所示,在机械故障检测过程中,随着设备的运行,新的故障类型会随时间不断涌现。ID 使系统能够在无需重新训练整个模型的情况下,逐步获得识别这些新增故障的能力。它既提高了检测的时效性,又降低了重复建模的成本。
分类任务的评价指标主要涵盖四个核心维度:混淆矩阵、准确率(Accuracy)、召回率(Recall)和F1分数。
I 混淆矩阵(Confusion Matrix):混淆矩阵是一个二维矩阵,用于展示分类模型的预测结果与每个类别实际结果之间的比较。它向我们展示了模型识别各类别的能力,并使我们能够更直观地看出模型在哪些类别上表现良好、在哪些类别上出现误判。混淆矩阵通常由四个部分组成:真阳性(True Positive,TP)、假阳性(False Positive,FP)、真阴性(True Negative,TN)和假阴性(False Negative,FN)。混淆矩阵通过将预测结果与实际标签逐一比对,提供详细的性能评估,有助于识别模型特有的误分类模式。然而,解读混淆矩阵需要理解其构成的各项指标,这使其分析比准确率等单一指标的分析复杂得多。
II 准确率:准确率是机器学习、医学诊断和工业检测等领域中评估性能的最基础、最常用的统计量。其定义为正确预测的样本数占总样本数的比例,如式(1)所示:
准确率的优点在于简单、直观、易于理解和计算。然而,它也有自身的局限性:当故障类别不平衡时,准确率可能无法充分反映模型的性能。
召回率适用于误分类代价较高的场景。例如在轴承故障诊断中,故障误分类可能导致设备损坏或生产停机。因此,召回率是衡量模型故障检测能力的有效指标。然而,仅优化召回率可能会增加假阳性数量,降低其他指标的有效性。 IV F1分数:F1分数表示精确率(precision)与召回率的调和平均值,主要用于解决二者之间的权衡问题,在类别不平衡的场景中尤其有用,如式(3)所示:
F1分数平衡了精确率与召回率,适用于需要同时评估阳性与阴性样本分类效能的情形。F1分数在精确率与召回率之间取得平衡,缓解了过度强调某一指标所引发的问题。
对于用于轴承故障诊断(bearing fault diagnosis,BFD)的DL模型而言,选择合适的评估指标至关重要。准确率提供总体评估,但在处理不平衡数据时可能不可靠;召回率关注模型的故障检测能力;F1分数是结合准确率与召回率的平衡性指标;最后,混淆矩阵通过展示四种分类结果帮助分析模型性能。综合利用这些指标可对模型的分类性能进行全面评估,并为模型优化提供指导。
2.2.2. 分类任务指标
在回归任务中,模型性能评估需要特定指标来衡量预测值与实际值之间的差异。常见的回归任务指标包括均方误差(mean square error,MSE)和平均绝对误差(mean absolute error,MAE)。这两种指标具有不同的特点与应用场景,以下对它们进行综合介绍:
I MSE:MSE是回归项目中常用的评估统计量,它计算预测值与实际值之差的平方的均值,如式(4)所示:
其中:n为样本量; 为实际值; 为预测值。 由于MSE具有凸性和可微性,常被用作梯度下降等优化算法的目标函数。其二次惩罚机制赋予残差更高的权重,优先优化误差较大的样本。然而,MSE对异常值高度敏感,异常点的干扰可能给参数估计带来偏差。因此,MSE适用于需要精确预测的任务,尤其是当误差可能对最终结果产生重大影响时。
MAE的优点是对异常值鲁棒且结果直观。然而,其线性惩罚机制对误差不够敏感,且优化过程中梯度的不连续性可能阻碍收敛效率。因此,它适用于对误差容忍度较高的场景,尤其是当模型优化目标关注预测误差的中心趋势(如中位数)而非异常偏差时。特别地,其对异常值的低敏感性使其在含噪或非高斯分布数据中更加鲁棒。
2.2.3. 实时指标
在基于DL的BFD背景下,实时性能指标的评估尤为重要,特别是在诊断系统必须在限定时间内预测和评估故障的工业应用中。实时评估指标主要强调模型在实际运行中的响应速度和处理能力,以确保FD能够在实时或近实时环境中高效执行。以下是几种常用的实时评估指标:
I 推理时间(Inference time):推理时间指模型基于输入数据产生预测所需的时间(通常以毫秒或秒为单位),它直接决定系统的实时性能。在BFD中,推理延迟会导致维护响应延迟,影响生产安全与效率。因此,必须通过模型轻量化和硬件加速确保实时推理能力的有效性。
II 响应时间(Response Time):响应时间定义为故障发生到系统随后给出诊断结果之间的时间间隔。该指标涵盖数据采集、数据处理、模型推理和结果反馈的时间要求。在实时监测系统中,必须将响应时间控制在秒级范围内,以确保及时采取预防措施。
III 数据吞吐量(Data Throughput):在BFD系统中,数据处理能力(又称数据吞吐量)表示在给定时间间隔内处理的数据量。该指标与系统管理并发数据流的能力直接相关。更高的吞吐量性能可显著提升多通道振动信号的并行分析效率,从而实现对故障特征的快速捕获与反馈。
基于上述数据集和评估框架,本文将进一步深入探讨基于DL的BFD方法,涵盖CNN、LSTM、GAN等。
2.3. 实验设置与可复现性考虑
2.3.1. 数据划分策略
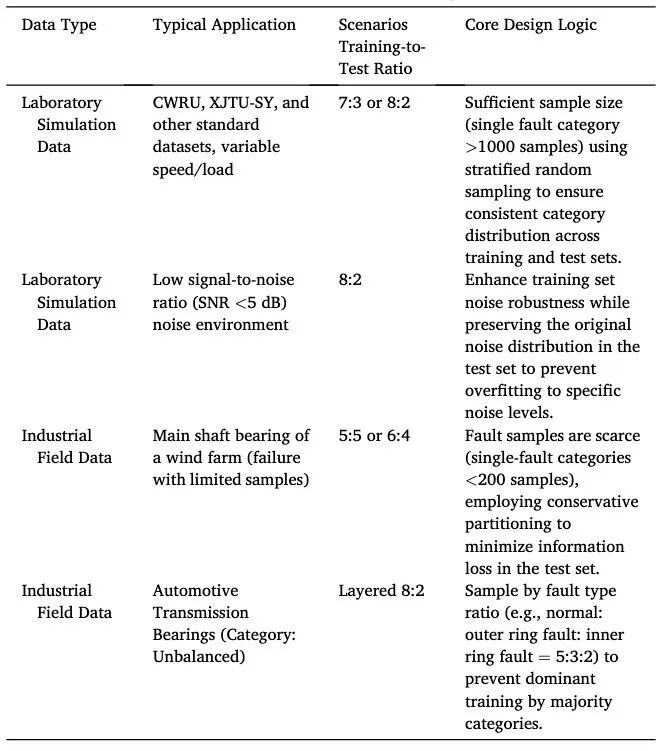
数据划分策略是基于深度学习的轴承故障诊断实验设计的核心组成部分,其关键在于通过合理划分训练集与测试集,确保模型评估的客观性、稳定性和泛化能力。在样本不平衡、工况波动和噪声干扰等复杂环境中,不当的划分方法可能导致“伪高性能”,即模型在实验室环境中表现良好,但在真实工业应用中表现不佳。表2总结了不同场景下的常用方法及其设计依据。
表2 不同情境下的常见做法及其设计依据
2.3.2. 交叉验证策略
表2 不同情境下的常见做法及其设计依据
2.3.2. 交叉验证策略
为缓解单次数据划分的随机性,尤其是在样本量有限或工况多变的情况下,必须采用合适的交叉验证方法。常见策略包括k折交叉验证、留一验证和跨工况验证,需根据数据规模和运行特性进行选择。
(1)k折交叉验证(K-Fold Cross-Validation)
k折交叉验证是机器学习中常用的评估策略。它将数据集分为k份,每次用k−1份训练模型,用剩余1份进行测试。该过程重复k次,每次迭代由不同部分充当测试集。这种方法能够全面评估模型,减少不同划分造成的误差,增强评估的稳定性和可靠性。
它常用于样本量充足、工况相对稳定的实验室环境。传统的k折交叉验证(k-Fold CV)仍是评估模型性能最广泛采用的方法。具体而言,k=10是该场景下的主流参数选择。其核心优势在于有效覆盖数据集内的所有运行子集,同时合理控制计算复杂度,从而显著降低模型性能评估结果的随机波动。这一特性对于校准实验室环境中故障诊断模型的性能至关重要。
(2)留一交叉验证(Leave-one-out cross-validation,LOOCV)
留一交叉验证(LOOCV)是k折交叉验证的一种特殊形式,定义如下:当数据集总规模为n时,将k设为n。每次迭代从数据集中选取一个样本作为独立测试集,其余n−1个样本构成训练集。该过程重复n次,确保每个样本都被用作一次测试集。最终的模型评估通过对所有n次实验的性能取平均而获得。这种验证方法的本质是“最大化数据利用”——最小化测试集规模以最大化训练集规模,从而避免因样本划分造成的信息损失。
就适用性而言,LOOCV主要适用于小样本场景。它在复杂工业环境中的轴承故障诊断中展现出不可替代的价值,尤其是在故障样本稀缺的情况下。典型应用包括:早期轴承剥落故障、特殊工况下发生的故障以及小众轴承型号的故障数据。
(3)跨工况交叉验证(Cross-Condition Cross-Validation,CCCV)
跨工况交叉验证(CCCV)是专门为评估模型在未知工况下泛化能力而设计的验证策略。其核心原则是严格分离训练数据集和测试数据集的工况,以模拟模型在真实工业环境中遇到的域偏移挑战。与假设数据独立同分布的传统交叉验证方法不同,CCCV旨在测试模型在分布变化下的鲁棒性与适应性。
CCCV主要适用于运行变化显著的复杂工业环境,特别是训练数据与测试数据之间存在显著分布差异的场景。典型应用包括但不限于:变载荷工况、变速运行;跨设备迁移学习;以及噪声环境变化。在工业背景下,经CCCV验证的模型通常被认为具有更高的外推可靠性和部署价值。
2.3.3. 硬件与软件实验环境
2.3.3. 硬件与软件实验环境
硬件与软件实验环境是确保基于深度学习的轴承故障诊断研究结果可复现性与可靠性的基础。在复杂环境中,模型训练效率、推理性能和工业部署兼容性都依赖于清晰且匹配的软硬件配置。不透明的环境描述不仅可能使实验无法复现,还会掩盖模型在真实应用中的性能局限。本节系统梳理了实验所需的硬件平台和软件工具链,为建立透明、可复现的实验工作流程提供依据。表3详述硬件平台,表4则明确软件环境。
表3 硬件规格
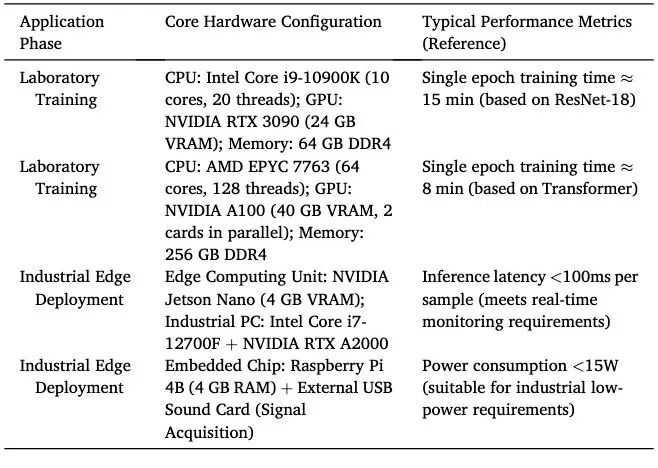
表4 软件环境
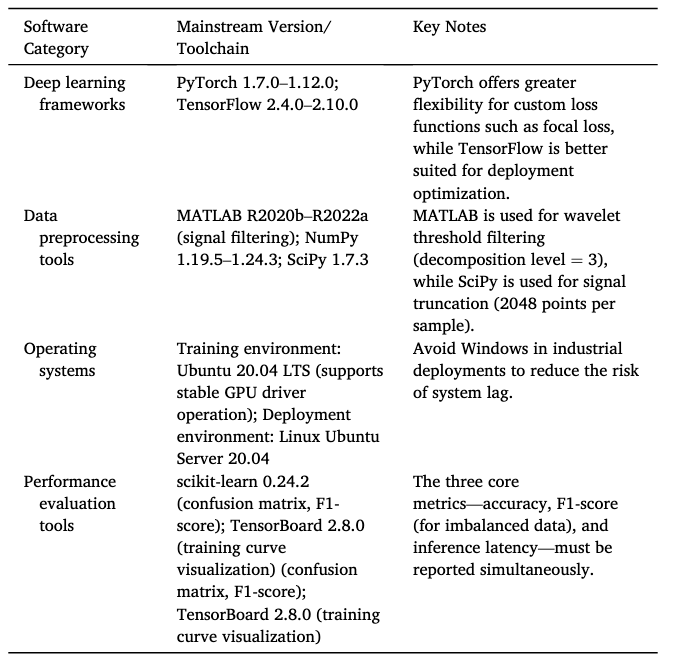
表3 硬件规格
表4 软件环境
表3 硬件规格
表4 软件环境
表4 软件环境
表4 软件环境
3 基于深度学习的轴承故障诊断方法
DL已克服人工智能领域的若干长期挑战,在研究中取得了突破。它擅长处理高维数据中的复杂结构,其关键在于特征层是从数据中学习得到的,而非由人工设计(LeCun et al., 2015)。近年来,将DL应用于状态监测的研究数量激增。本节将讨论基于DL的最新FD方法。如图8所示,所选研究的总量是各DL技术贡献的结果。大多数研究采用CNN,其能够从大量训练数据中学习数据驱动、高代表性、分层的图像特征(Shin et al., 2016),占总研究的35%。其次是RNN和LSTM,其中LSTM网络旨在解决梯度消失问题(Sherstinsky, 2020),占总研究的30%。AE主要用于无监督学习任务,旨在捕获数据中最显著的特征与模式(Çakir and Sirin, 2024),占20%。DBN是由多个受限玻尔兹曼机(Restricted Boltzmann Machines,RBMs)构成的经典深度学习网络(Sarikaya et al., 2014),占5%。GAN已被证明能够从数据中提取深层特征(Wang et al., 2025a),占5%。其他方法占5%。
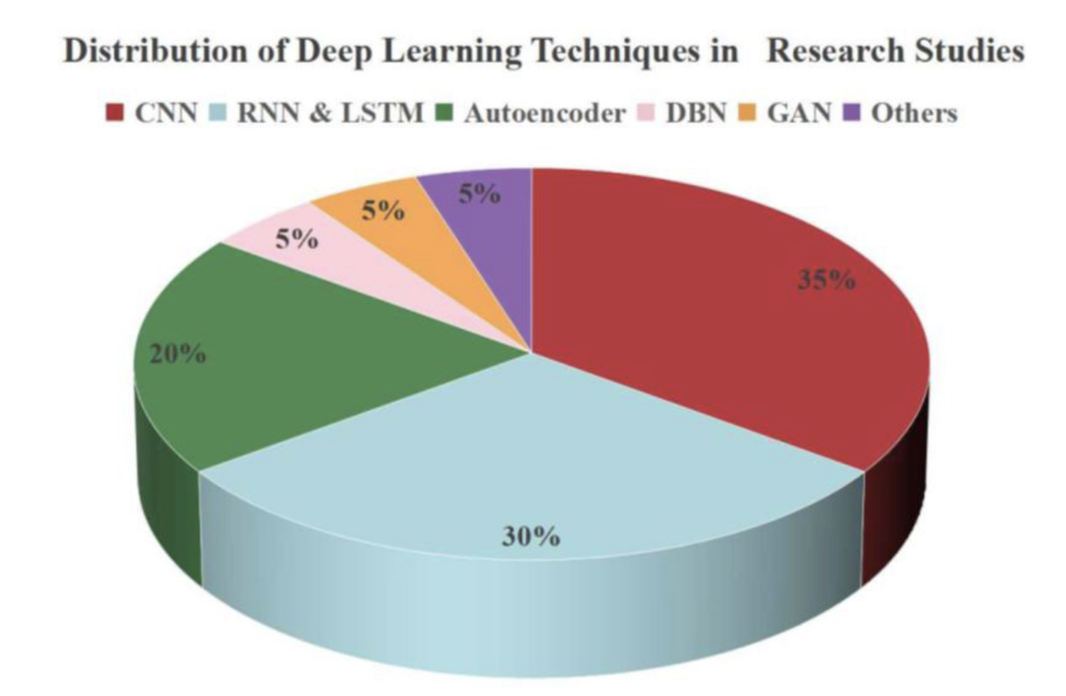
图8 深度学习技术在相关研究中的分布
3.1. 卷积神经网络
CAE 是一类基于卷积运算的无监督学习模型。输入数据通过编码器映射到低维潜在空间,随后通过解码器重构原始输入,其关键在于学习数据的紧凑特征表示。其基本结构由编码器与解码器两个关键部分组成。
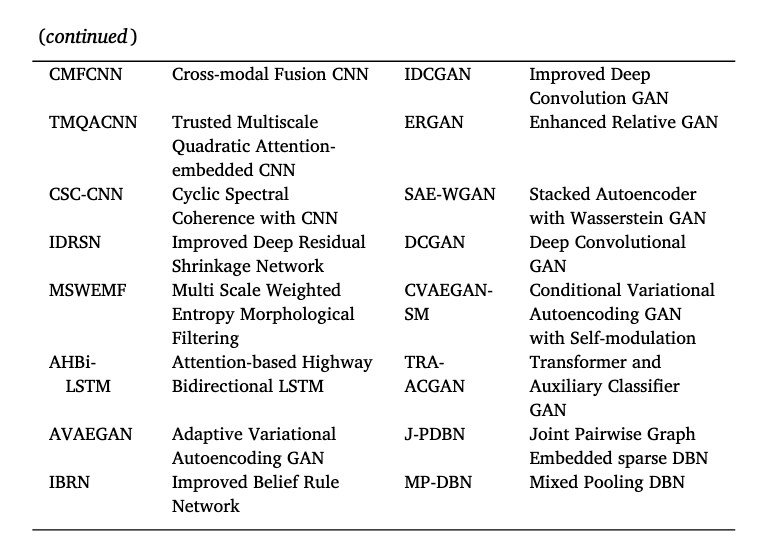
CNN最早由Yann LeCun等人(1998)于1998年提出,标志着这一类网络的正式诞生。在该论文中,作者详细介绍了一种通过卷积运算降低网络复杂度、提升泛化能力的新型神经网络架构。2016年,Janssens等人(2016)率先将二维CNN应用于旋转机械故障诊断。在该文中,特征学习通过CNN模型实现,构成端到端学习系统。CNN凭借其提取复杂数据特征与识别模式的能力,尤其在处理高维非线性信号时,已成为故障诊断领域的高效工具。如图9所示,CNN架构由卷积层、池化层和全连接层组成。卷积层是CNN的基本组成部分,负责从数据(即图像)中提取特征。池化层用于降低特征图维度、降低计算复杂度并缓解过拟合的可能性。在典型配置中,全连接层位于网络末端,将先前提取的特征进行融合,以产生最终的预测结果。后续章节将介绍基于CNN网络的BFD最新进展,更全面的概述请参见表5。
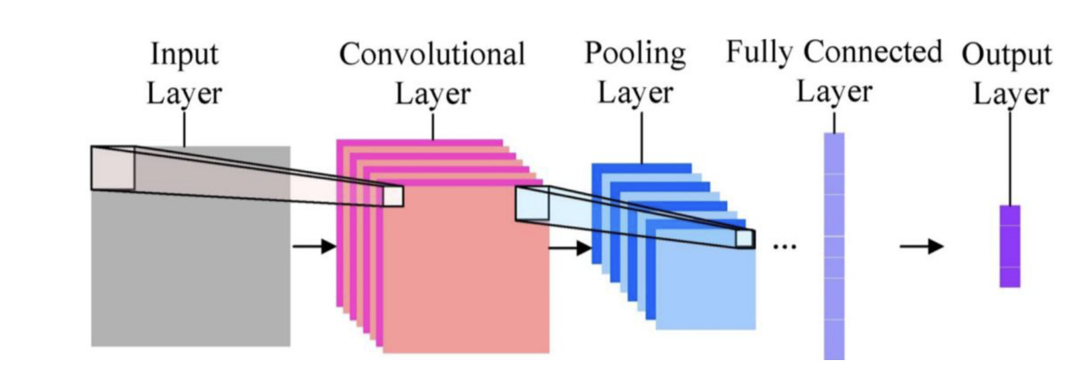
图9 卷积神经网络结构示意图(Chatterjee, 2019)
表5 软件环境
表5 软件环境
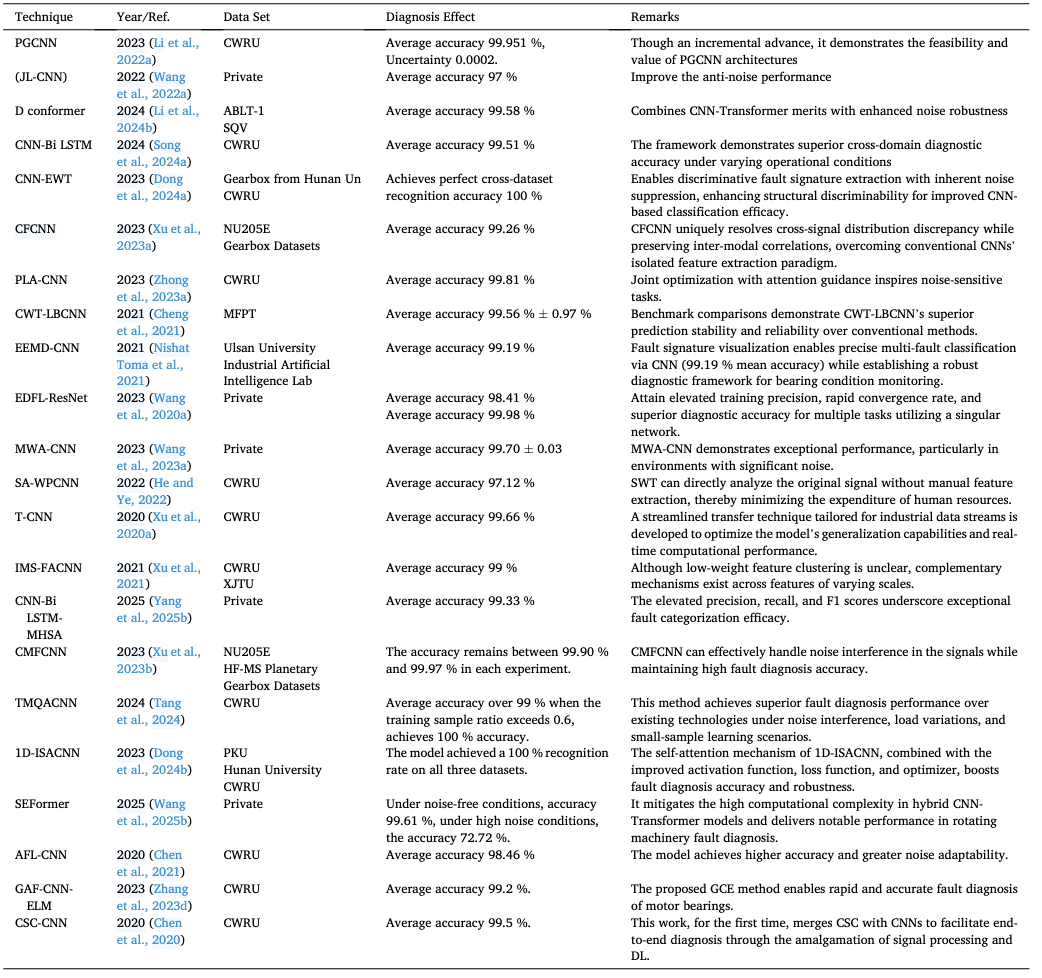
3.1.1. 改善数据不平衡的方法
工业机械系统BFD中普遍存在的数据不平衡问题严重限制了诊断模型的泛化能力,尤其是在稀有故障类别的识别方面。为应对这一挑战,现有研究提出了四种关键策略(Xu et al., 2024;Li et al., 2022a;Wang et al., 2021a;Yang et al., 2025a):通过损失加权调整样本权重;利用特征稳定技术平衡分布;通过自适应归一化机制实现动态调节;以及结合基于注意力的特征融合方法增强特征表征。然而,现有方法尚未克服模型结构对数据分布的固有依赖:损失加权仅缓解样本不平衡而未改善特征不平衡;特征稳定和自适应归一化虽优化了分布偏移,但受统计估计偏差的制约;注意力融合则依赖充足样本来建立特征关联,对长尾问题的根本改善有限。要解决这些核心缺陷与技术瓶颈,仍需进一步突破。
3.1.2. 改善独立任务诊断的方法
由于现有方法大多基于单任务学习,将故障诊断视为独立任务,因而忽略了不同任务间蕴含的丰富关联信息。Liu等人(2020)提出了一种多任务一维CNN,联合学习故障诊断、转速识别和负载识别任务,以挖掘任务间的关联信息;Wang等人(2022a)设计了一种注意力引导的联合学习CNN,将故障诊断与信号去噪任务相结合以增强噪声鲁棒性。这两种方法都突破了单任务孤立学习模型的局限,但受共享特征空间降维压缩的制约,在高维复杂故障模式下表征能力显著下降。
3.1.3. 改善强噪声干扰的方法
机械系统经常在恶劣环境中运行,振动信号极易受到强噪声的严重干扰。这种干扰会显著影响故障诊断的精度。目前,常规降噪方法被频繁采用,但它们缺乏提取全局故障特征的能力。这一现象导致关键信息丢失,从而进一步降低诊断准确率。针对这一问题,Li等人(2024b)提出了一种能够从含噪振动信号中提取局部与全局故障特征的Dconformer网络。如图10所示,采用集成故障诊断流程图来全面展示轴承故障诊断过程。该图由以下部分组成:A部分展示了实验平台设计;B部分表明经Dconformer去噪后的信号在频域中呈现出更明显的故障特征;C和D部分分别展示了变速与恒速数据集下的模型可视化与准确率对比图。各组成部分的全面概览请参见图例及相应注释。文献(Jia et al., 2023;Dong and Lotfipoor, 2023;Wei et al., 2023;Li et al., 2024c;Liu et al., 2023a;Wang and Xu, 2023;Zhang et al., 2023c)聚焦于噪声鲁棒性与特征判别力的协同优化。这些研究从初始高精度敏感模型对输入噪声的脆弱性出发,通过多域特征融合、注意力驱动的特征学习强化、物理先验知识嵌入和异构架构建模,逐层增强特征鲁棒性,最终收敛于自适应噪声抑制与多变量信号解耦——形成了从被动噪声容忍、主动特征强化到源头噪声分离的三步过渡,系统性地解决了复杂工业场景中信噪比恶化导致的特征可分性退化问题。
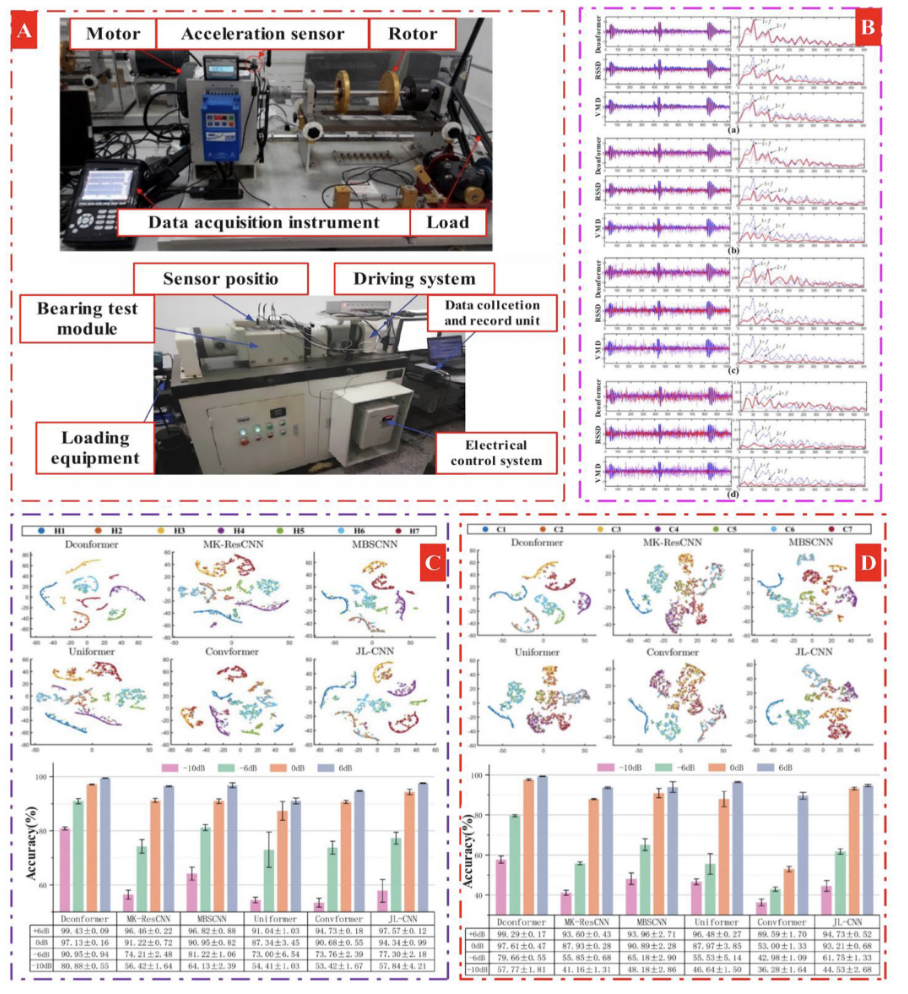
图10 A:ABLT-1A轴承试验台;SQV轴承试验台。B:在ABLT-1A轴承数据集上利用Dconformer、RSSD与VMD(variational modal decomposition,变分模态分解)所得去噪信号的展示。图中给出了原始信号、加噪信号与去噪信号的波形及平方包络谱。(a)、(b)、(c)、(d)分别对应SNR(signal-to-noise ratio,信噪比)= +6 dB、SNR = 0 dB、SNR = −6 dB、SNR = −10 dB四种噪声设置下的结果。蓝色代表不含噪声的未改动信号,紫色代表加入了高斯噪声的信号,红色代表由所选方法产生的去噪信号。C、D:六种对比方法在四种信噪比情形下的诊断精度,以及六种方法在SNR = −6 dB强噪声条件下所得特征的可视化(Li et al., 2024c)。(关于图例中颜色引用的解释,请参阅本文的网络版。)
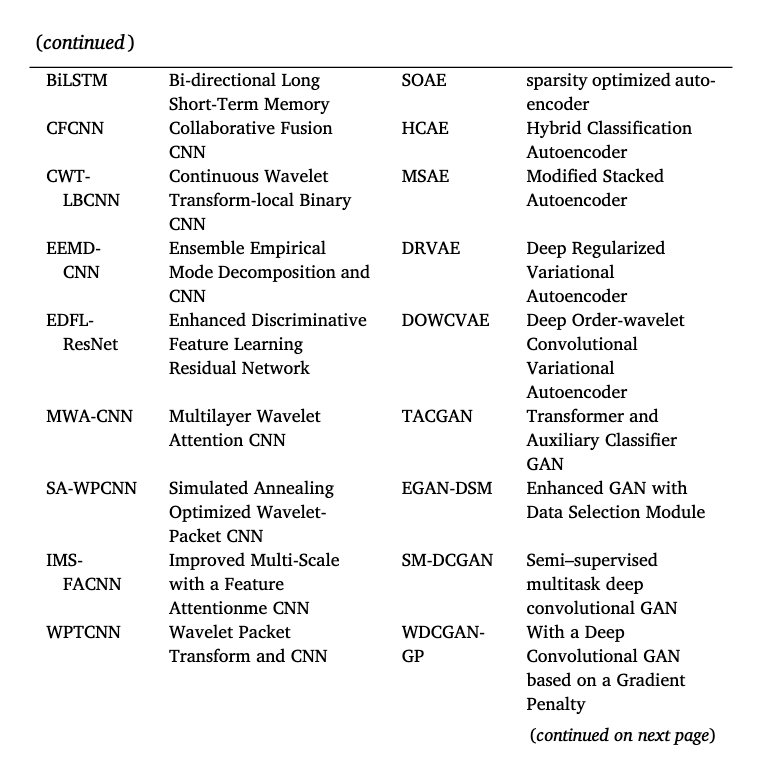
尽管基于自适应去噪卷积神经网络的故障诊断方法在噪声环境下取得了进展,但仍存在有待解决的重大挑战,包括计算复杂度高、泛化能力差、数据依赖性强、可解释性缺乏、稀有故障识别能力弱以及超参数调优复杂等。这些问题须在实际应用中进一步优化,以增强模型的实用性与稳定性。为解决上述问题,文献(Song et al., 2024a;Dong et al., 2024a;Liu et al., 2023b)通过训练超参数动态优化、特征自适应增强和架构冗余抑制的三维协同,在确保模型效率的同时最大化特征利用,实现了更准确的故障分类。Xu等人(2023a)提出了一种协同融合CFCNN。图11的A部分展示了圆柱滚子轴承试验台的实验配置,虚线表示α对CFCNN性能的影响。图示给出了应用于NU205E轴承数据集的10种方法的诊断精度。图11B描绘了行星齿轮箱试验台,训练曲线与测试曲线见C部分。
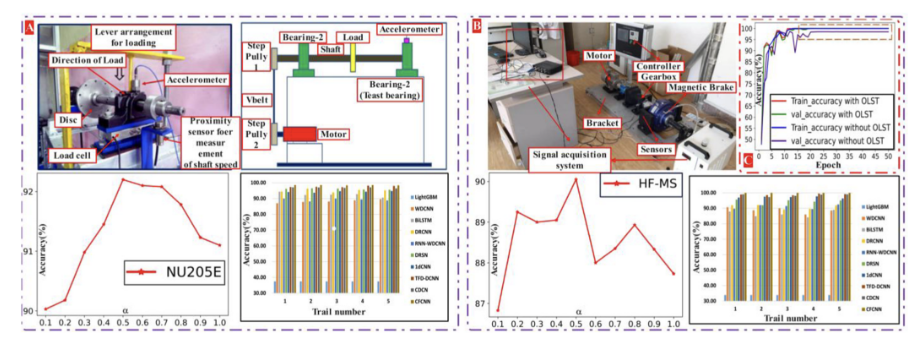
图11 A为圆柱滚子轴承试验台,B为行星齿轮箱试验台。两幅折线图展示了α对CFCNN(Collaborative Fusion CNN,协同融合卷积神经网络)性能的影响。两幅柱状图展示了应用于NU205E轴承数据集的10种方法的诊断精度。C:训练曲线与测试曲线(Xu et al., 2023a)
3.1.4. 改善动态工况的方法
为解决传统特征工程在非稳态工况旋转机械中失效的核心挑战,文献(Li et al., 2024d;Hu et al., 2024;Sun et al., 2023;Wang et al., 2022b)提出了注意力驱动、多模态融合和异构架构等特征增强策略。然而,这些策略暴露出两个根本性局限:其一,模型训练依赖单一设备场景,使跨工况泛化能力受到质疑;其二,并行特征路径导致参数爆炸与计算复杂度激增,造成梯度更新效率退化和实时推理瓶颈。Wang等人(2021b)提出了一种集成加速度计和麦克风信号的模型。该模型由三个主要阶段组成:多模态传感器特征提取、融合和分类。如图12所示,展示了从不同实验条件下获得的数据集及其相应的处理流程,每个子图对应特定的轴承故障类型及相应的分类准确率。A部分展示了实验平台;B部分描绘了各种轴承故障类型;C部分展示了算法的损失函数曲线;最后,D部分给出了相应的可视化图像。然而,卷积融合结构可能固化多源信号的协作模式,使其难以适应旋转机械的变速变载场景。在实际工业环境中,它易受工况变化影响。文献(Cui et al., 2024;Choudhary et al., 2021;Xiong et al., 2023;Niu et al., 2023)通过信号重构与轻量化建模的双路径提升了噪声鲁棒性和部署效率,但受物理-算法联合瓶颈的制约:热成像温升滞后、变工况下重构过程中的频带混叠以及轻量化造成的高频特征衰减,揭示了特征完整性、预警能力与边缘计算效率之间的零和博弈困境。
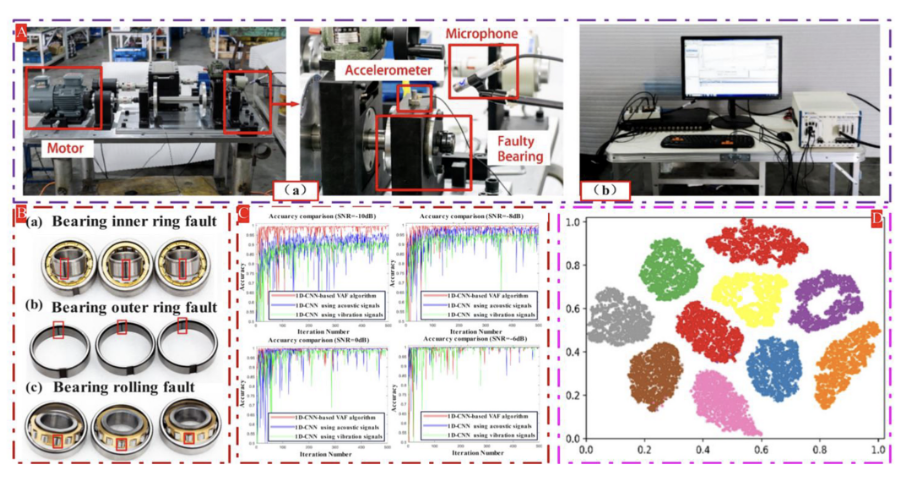
图12 A:轴承故障数据采集实验平台:(a) 试验装置;(b) 数据采集机构。共确定了十组实验用轴承:(a) 内圈故障规格为0.22 mm、0.44 mm和0.66 mm的轴承;(b) 外圈故障规格为0.22 mm、0.44 mm和0.66 mm的轴承;© 滚动体故障规格为0.22 mm、0.44 mm和0.66 mm的轴承。C:各算法的损失函数曲线,SNR取值分别为:(a) −10 dB;(b) −6 dB;© 0 dB;(d) 6 dB。D:经FC(Fully Connected,全连接)层后的数据特征可视化(Wang et al., 2021b)
3.2. 长短期记忆网络
在采用传统的反向传播时间算法或实时递归学习时,反向传播的误差信号经常引发两种不同的情形:必须考虑“梯度爆炸”和“梯度消失”现象。反向传播的误差随权重大小呈指数变化。在情形(1)中,这可能导致权重振荡;而在情形(2)中,学习跨越长期延迟可能需要极长时间或根本无法实现。因此,Sepp Hochreiter等人(Graves and Graves, 2012)融合梯度学习算法,提出了一种被称为LSTM的新型循环网络架构。LSTM是一种独特的RNN变体,旨在规避与误差反向传播相关的局限。它综合当前与历史数据来预测未来状态,巧妙地缓解了传统RNN普遍面临的梯度爆炸与梯度消失问题。其原理如图13所示。以下章节将详述一些基于LSTM的BFD前沿方法,这些方法的详细对比见表6。
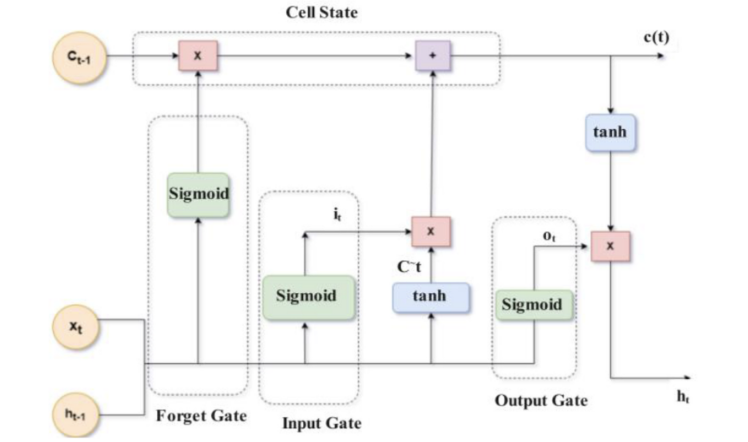
图13 长短期记忆网络结构图
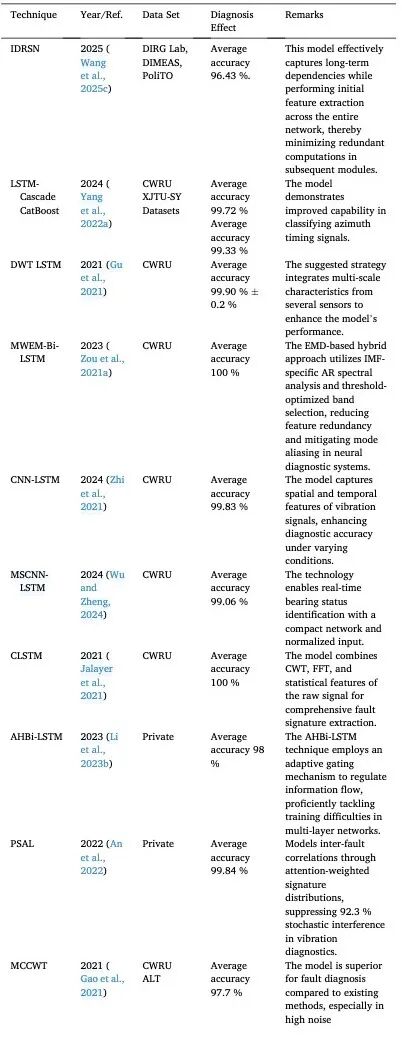
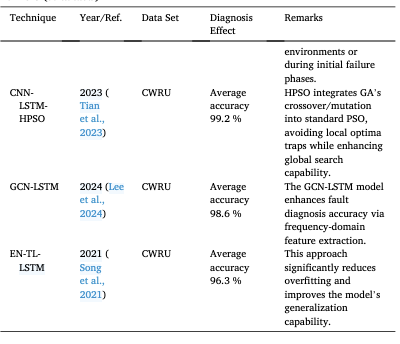
表6 LSTM相关技术、年份、数据集、诊断效果及评述
表6 LSTM相关技术、年份、数据集、诊断效果及评述
3.2.1. 改善变载荷与噪声干扰的方法
针对传统故障诊断方法在故障特征提取能力不足、变载荷与噪声干扰条件下诊断性能不佳方面的局限,许多学者尝试结合LSTM模型来提升诊断性能。Wang等人和Han等人(Wang et al., 2025c;Han et al., 2021)分别集成了LSTM/IDRSN并构建了BLC-CNN模型。前者通过半软阈值优化提升了分类准确率,后者利用Bi-LSTM实现了CNN特征的无噪融合;Wu等人(Wu and Zheng, 2024)利用MSCNN从振动信号中提取空间特征、LSTM捕获时序特征,并集成了注意力机制。然而,它们对训练前傅里叶变换等预处理方法的依赖可能影响诊断稳定性;Zhong等人(2023b)提出了SIAR谱分析与Bi-LSTM模型,使用集 合经验模态分解(Ensemble Empirical Mode Decomposition,EEMD)等算法分解信号,但固定长度分割可能截断非平稳冲击信号,导致早期故障检出率升高。这些研究在模型结构设计和特征提取方法上做出了创新性贡献,但也面临环境因素考虑不足、对预处理依赖过强或分割策略受限等需要进一步优化的挑战。Gao等人(2021)提出了一种弱故障特征提取与诊断方法,该方法将多通道连续小波变换与卷积特征基RNN(CFRNN)相结合。为便于理解所提CFRNN的学习过程,我们整合了实验工作流程,如图14所示。各分图(A至E)分别展示了实验平台搭建、轴承振动信号及其频谱、通道变化图、分类可视化以及各模型的准确率对比。
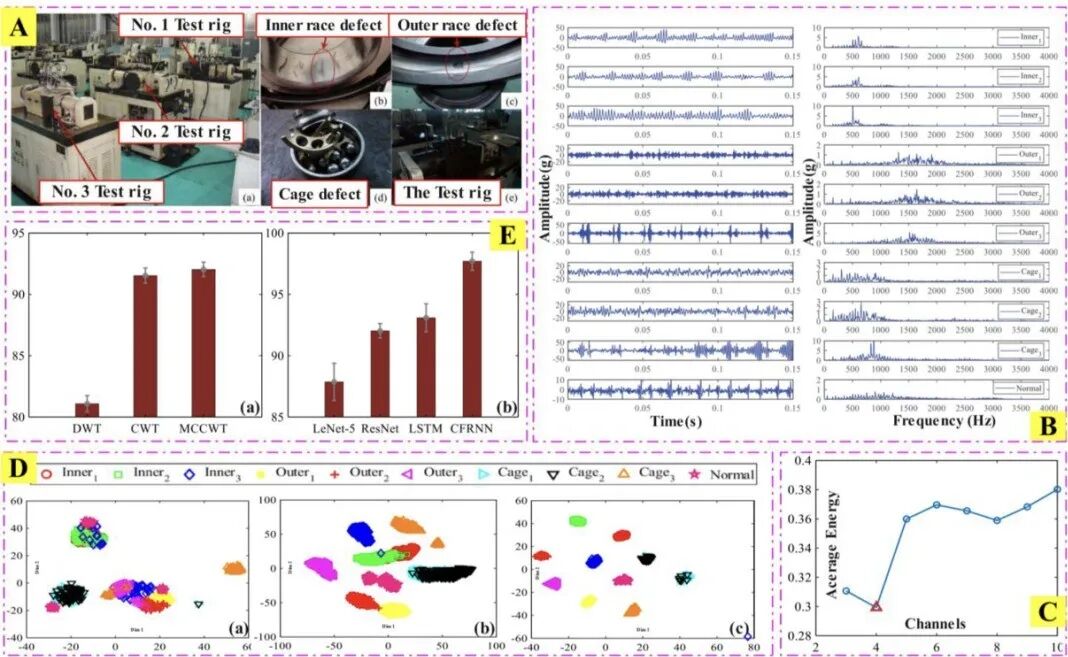
图14 A:三座试验台及呈现各种失效情形的故障滚动轴承。B:十种轴承状态下的振动信号及其对应频谱。C:联合频率的平均能量随通道数的变化。D:利用t-SNE(t-distributed Stochastic Neighbor Embedding,t分布随机邻域嵌入)在三个层上得到的特征图可视化:(a) 输入层,(b) R9层,© 输出层H1。E:在相同网络(ResNet,Residual Network,残差网络)下采用不同数据表征技术的各方法准确率,以及在相同数据表征技术(MCCWT,Multi-channel Continuous Wavelet Transform,多通道连续小波变换)下采用不同网络的各方法准确率(Gao et al., 2021)
然而,上述方法仍存在模态函数混叠、故障数据可分性低和计算复杂度高等固有问题。文献(Zou et al., 2021a;Yang et al., 2022a;Gu et al., 2021)提出了以下方法:将多尺度加权熵形态滤波与Bi-LSTM相结合的融合方法、能够直接处理多尺度高维信号的LSTM-Cascade CatBoost模型,以及基于离散小波变换的LSTM模型。前两种方法通过优化预处理或直接分类提升性能,后者能够提取多尺度特征但易受强噪声影响,可能损害LSTM性能。为解决轴承多点损伤引起的耦合调制难题,Ma等人(Ma and Wang, 2021)提出了一种自适应Chirp模态分解-基尼指数融合-天鹰优化器联合优化的LSTM模型,在无需诊断经验的情况下实现了96.67%和100%的复合故障诊断准确率。
3.2.2. 改善实时约束下计算成本的方法
尽管一些先进模型能够实现较高的诊断准确率,但其复杂架构导致计算成本高昂,严重限制了此类模型在实时故障诊断场景中的应用价值。文献(Wei et al., 2024;Vos et al., 2022;Zhi et al., 2021;Xia et al., 2021;Wu and Ma, 2022)均采用以LSTM为核心的混合模型架构,旨在通过模型结构优化或多技术集成降低计算复杂度,增强实时诊断能力。然而,这些方法受数据质量波动和突发事件响应效率限制的制约。要解决这些问题,可能需要在数据处理、模型训练和故障诊断策略方面作进一步改进。为充分利用信号并提取所有故障特征,Jalayer等人(2021)提出了一种融合快速傅里叶变换、连续小波变换和原始信号统计特征的方法。此外,还开发了一种卷积LSTM(convolutional LSTM),用于理解和分类这些多通道阵列输入。实验过程使用了三个数据集,如图15所示。所提模型在所有三个数据集上的表现均优于其他模型。
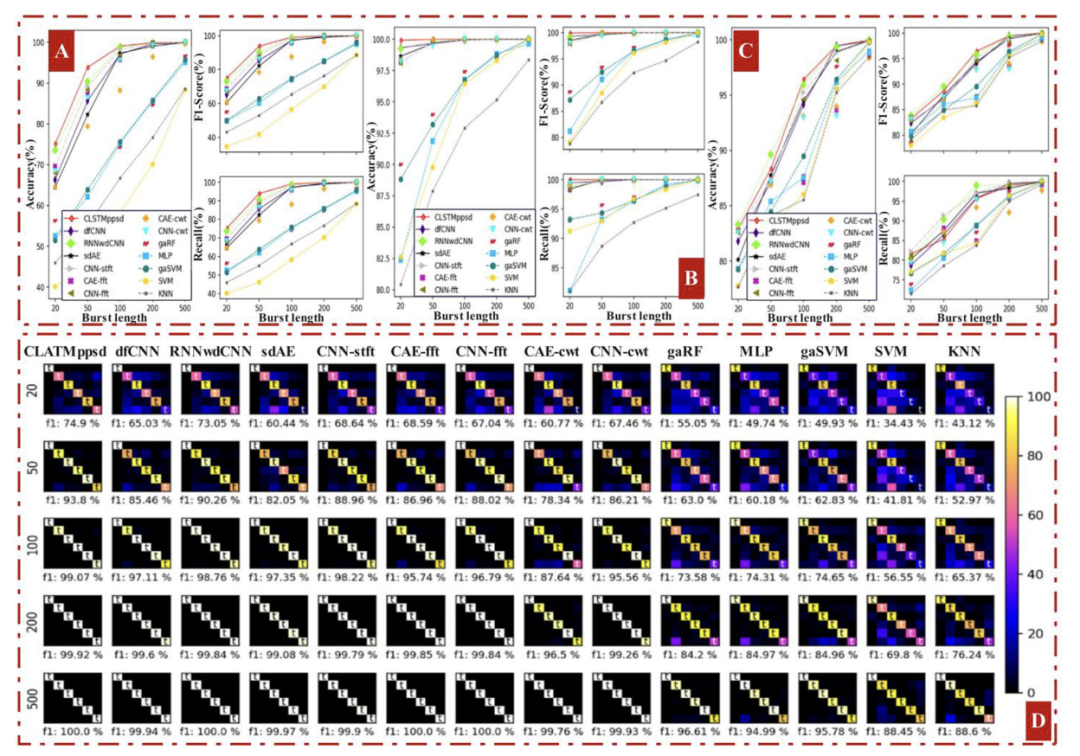
图15 A:A、B、C:各模型在CWRU、齿轮箱与风力发电机数据集上的准确率、F1分数与召回率。D:CWRU的归一化混淆矩阵(t:真实标签类别)(Jalayer et al., 2021)
3.3. 自编码器(AEs)
AE是一类无监督学习网络,其以输入数据作为监督信号,帮助神经网络学习映射关系,从而产生重构输出(Rumelhart et al., 1985)。如图16所示,自编码器通常由两部分组成:编码器(E.)和解码器(D.)。编码器将高维输入压缩为简化的低维潜在变量。解码器的任务是从隐含层中的潜在变量重建原始维度。理想情况下,重构输出应是对原始输入的精确或近乎完美的复现。若采用均方根误差(root mean square error,RMSE)作为损失函数,可将其表示为式(6)的形式:
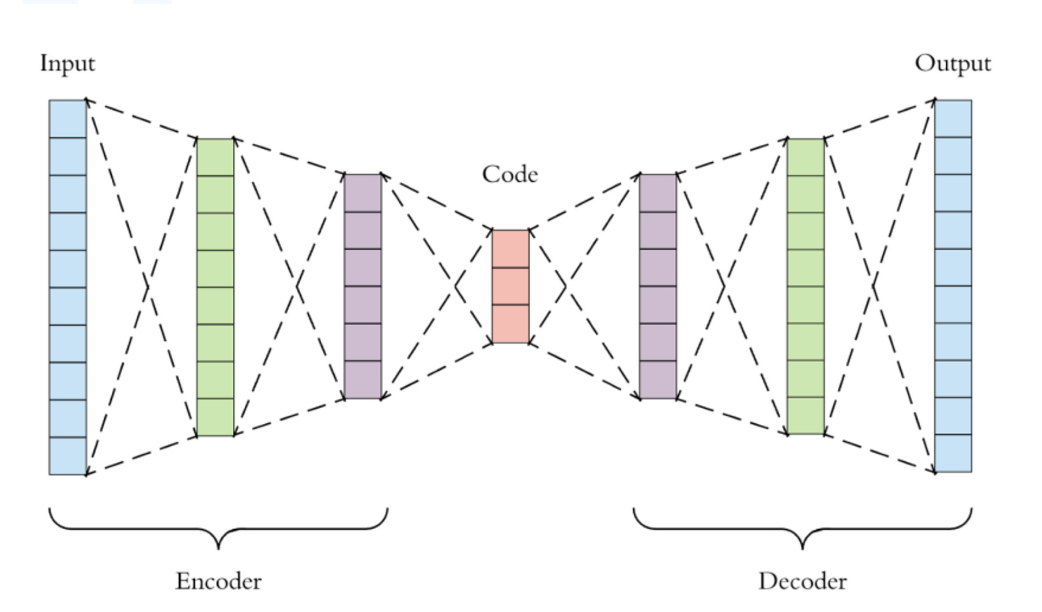
图16 自编码器结构图(Pang et al., 2024)
其中E(k)表示编码器,D(k)表示解码器,X表示原始信号。
近年来,利用AE及其增强版本的技术在轴承故障检测与诊断领域得到了广泛研究。相关学者相继提出了多种基于深度特征学习的智能诊断模型。接下来,我们将聚焦BFD领域的若干创新技术方法,系统阐述其理论基础和实现路径,并揭示这些前沿方法的理论价值与工程应用前景。方法的详细对比见表7。
表7 AE(Autoencoder,自编码器)相关技术、年份、数据集、诊断效果及评述
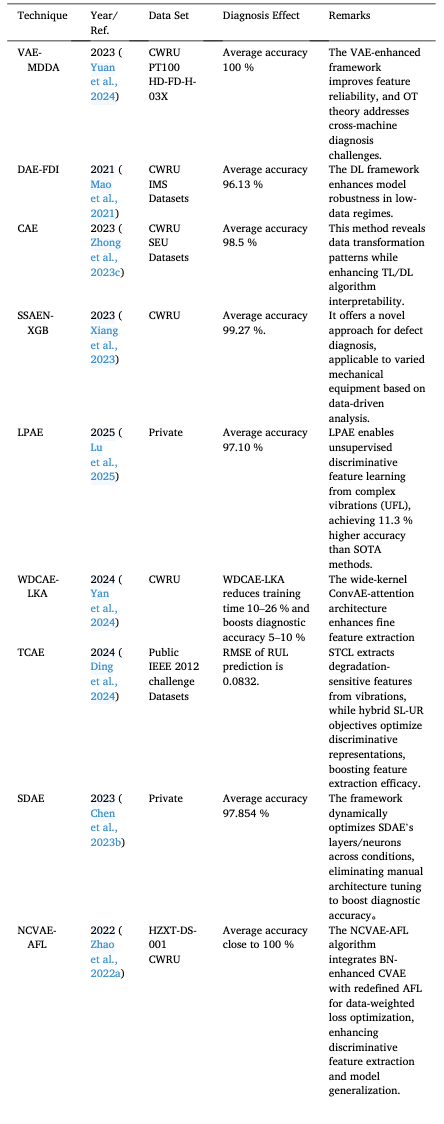
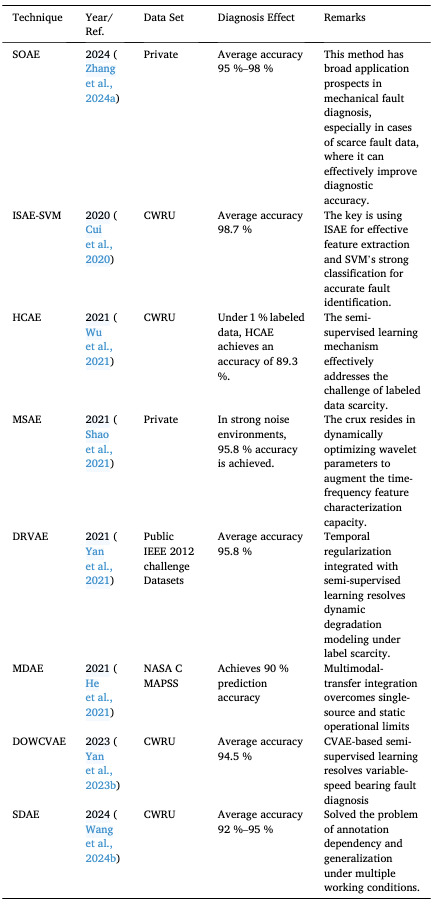
表7 AE(Autoencoder,自编码器)相关技术、年份、数据集、诊断效果及评述
3.3.1. 改善过拟合问题的方法
在解决小样本条件下基于DL的故障诊断过拟合问题的研究中,相关方法按技术路线可分为三类:第一类是基于特征增强与判别信息融合的方法,以文献(Mao et al., 2021;Zhao et al., 2022a)为代表。前者通过融合多种故障类型的判别信息并设计新的损失函数来增强特征判别能力,后者使用归一化条件变分自编码器增强数据特征学习能力,并结合自适应焦点损失优化分类性能。然而,前者缺乏对噪声的鲁棒性,后者侧重于算法优化;第二类是基于域自适应和迁移学习的方法,如Yuan等人(2024)提出的MDVAEOT模型,其集成变分自编码器、多源深度域自适应和最优传输技术,利用跨域共享特征进行诊断;以及Zhong等人(2023c)设计的用于从频谱中提取深度特征的卷积自编码器。二者均通过知识迁移解决小样本泛化问题,但前者因模型结构复杂而产生较高的计算成本,后者假设源域与目标域之间的差异可简单对齐,限制了对非线性分布变化的适应性;第三类是基于优化自编码器架构与算法集成的方法,以Xiang等人(2023)的优先消除法(Priority Elimination)为典型代表,将堆叠稀疏自编码器与极端梯度提升相结合,将诊断准确率从96.3%提升至99.27%,但模块堆叠带来了巨大的计算需求。总体而言,这些方法通过改进特征学习、跨域迁移或模型架构缓解了小样本问题,但部分方法仍存在计算复杂度高或鲁棒性不足等局限。
3.3.2. 改善固有时间依赖特性的方法
在轴承故障诊断领域,数据驱动的PHM(Prognostics and Health Management,故障预测与健康管理)技术通过集成DL取得了进展,但原始振动信号的时序相关处理与无监督特征提取仍是关键挑战。为此,相关研究采用了两种基于自编码器架构的技术途径来增强特征表征能力:一种聚焦于时序特征增强方法,如文献(Ding et al., 2024;Yan et al., 2024)。前者采用卷积结构捕获信号时间依赖性以进行退化评估和RUL(remaining useful life,剩余使用寿命)预测,后者结合大核注意力机制扩展感受野。两种途径均通过优化卷积架构来提高对长期信号中故障模式的捕获精度;另一种聚焦于基于稀疏性与局部结构保持的优化方法,如文献(Zhang et al., 2024a;Lu et al., 2025)。前者通过引入稀疏惩罚项优化隐含层特征分布,以增强故障特征区分度;后者设计局部结构保持惩罚项以保留信号的局部流形结构。两种途径均从特征约束层面增强了无监督学习对复杂故障模式的表征能力。这些方法的共性在于以自编码器作为底层架构,采用时序建模、稀疏约束或局部结构保持等策略应对轴承退化评估中的时间依赖与故障复杂性问题。然而,其共同局限在于自编码器的无监督学习机制难以充分捕获所有潜在的非线性故障关系,导致模型在多样化工况下的泛化受限。
现有常规方法在动态工况下的泛化能力存在固有局限,核心约束体现在两个方面:其一,网络架构难以实现跨工况特征自适应提取;其二,工业场景中固有的噪声污染极易导致模型在低信噪比条件下诊断可靠性大幅下降。针对这些问题,Chen等人(2023b)提出了一种堆叠去噪自编码器(Stacked Denoising AE,SDAE)模型。在故障信息获取方面,采用两个振动传感器从多个方向采集轴承振动数据,从而增强所采集故障信息的深度。针对诊断网络构建中的反向微调过程,提出了一种独特的SDAE复合损失函数,旨在改进网络的特征分类能力。
编辑:Leo
校核:李正平、陈凯歌、曹希铭、赵学功、白亮、任超、海洋、陈宇航、Kira、Tina、王金、赵诚、肖鑫鑫、张优
该文资料搜集自网络,仅用作学术分享,不做商业用途,若侵权,后台联系小编进行删除