用了40年还没被淘汰:仿真行业离不开的三大“老”算法
凌晨两点,某汽车研究院的机房里,一百多台CPU核心还在满载运转。仿真工程师小李揉了揉眼睛,看了一眼进度条:粒子群优化第38代种群,收敛曲线还在往下走。他设的闹钟是早上七点——那时候,算法 会替他从3000多组备选方案里,挑出散热最均匀、重量最轻的那一版电池包设计。
而在三年前,这份工作是他自己干的:改一组参数,跑一遍仿真,等四个小时,看结果,再凭经验改下一组。一个项目下来,他手搓了两百多版方案,头发掉了一把,性能也就提升了8%。
现在算法一晚上干完,提升23%。
你可能会问:都2026年了,AI大模型都会写诗、画图、写代码了,怎么工程优化这件事,用的还是上世纪的三套"老古董"——遗传算法(GA)、模拟退火(SA)、粒子群优化(PSO)?
这个问题,值得掰开揉碎聊透。因为答案背后,藏着仿真行业最真实、也最反直觉的技术逻辑。
一、三套算法,比很多读者的爸妈岁数都大
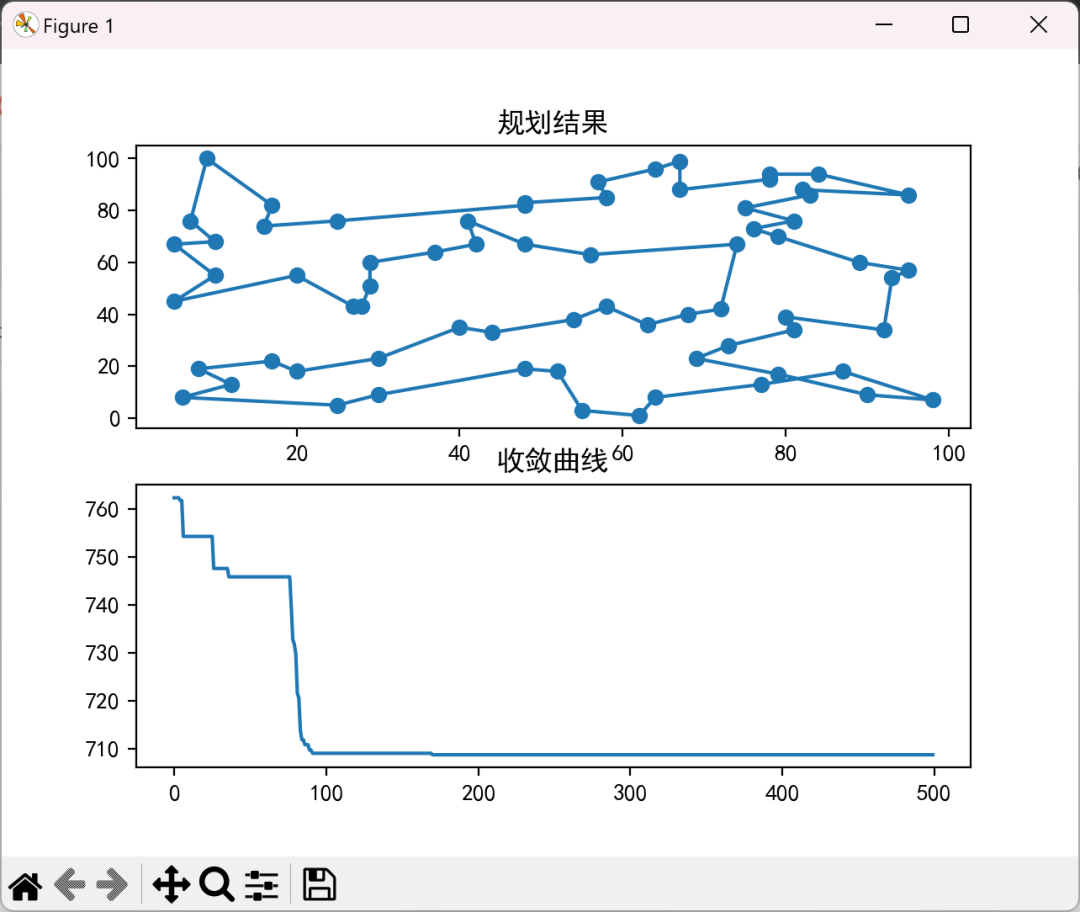
先看一组数字:遗传算法由密歇根大学的John Holland在1975 年正式提出,今年51岁;模拟退火的思想源于1983年 Kirkpatrick 等人把固体退火过程引入组合优化,再往前追溯,其概率准则早在1953年就由 Metropolis 提出,43岁;最年轻的粒子群优化算法,是 1995年Kennedy 和 Eberhart 受鸟群捕食行为启发提出的,也已经31岁了。
放在IT圈,这仨早就该进博物馆,和软盘、拨号上网摆在一个展柜里。但在CAE仿真优化这个领域,它们依然是最普遍、最被信赖的主力工具——翻开任何一个主流仿真流程集成平台,默认算法列表里躺着的就是它们;任何一个结构、热、流体、电磁优化项目招标,方案里写的还是它们。
不是行业懒,恰恰是因为行业足够严谨。这三套算法能统治仿真优化四十年,每一套都有它不可替代的生存智慧。
二、先搞懂:这三套"老古董"到底是怎么干活的
很多人听过名字,但不一定清楚它们的原理。用大白话说,三套算法其实是三种截然不同的"解题哲学"。
遗传算法,学的是达尔文。它把一组候选设计方案当成一个"种群",每个方案就是一条"染色体"——把绕组匝数、槽形尺寸、板厚这些设计参数像基因一样编码进去(连续参数可以用实数直接编码,离散参数用二进制映射)。然后是教科书级的五步循环:计算每个方案的适应度;用轮盘赌或锦标赛的方式"选择"——适应度越高的方案,被选中留下后代的概率越大;让两个优秀方案的参数"交叉",各取所长生出新方案;再以很小的概率(通常 0.01到0.1)做"变异",随机微调某个参数,给种群注入新的可能性;最后进入下一代。交叉概率一般设在0.6到0.9之间——大力提倡"优生优育",但坚决不允许全员躺平。本质上,它是把"物竞天择"四个字写成了代码。
模拟退火,学的是冶金。金属从高温缓慢冷却时,原子会自发找到能量最低、结构最稳定的状态。模拟退火借用了这个物理过程:把目标函数值看成"内能",搜索前期"温度高",它允许算法接受更差的解,从而跳出局部最优的坑;随着迭代推进"温度下降",它越来越挑剔,最终稳定在优质解上。这个"允许犯错"的尺度,就是那条著名的Metropolis 准则:新解更优,无条件接受;新解更差,也不是一票否决,而是以exp(-Δf/T) 的概率接受——温度越高,越容易接受坏消息。举个具体的数:新解比当前解差5个单位、当前温度是10,接受概率就是e的负0.5次方,约 61%,相当于掷一次硬币;等温度降到1,这个概率骤降到不足0.7%,基本不再回头。工程上常用指数降温,每一轮温度乘以0.8到0.99之间的系数——降太快搜索不充分,降太慢浪费算力,火候全在经验里。顺带说一个很多人不知道的硬核事实:在三套算法里,模拟退火的理论地位最特殊——只要降温足够慢,它可以以概率1渐近收敛到全局最优解。这是元启发式算法家族里少有的、有严格数学背书的"保票"。
粒子群优化,学的是鸟群。一群鸟在森林里找食物,每只鸟记着自己的最佳觅食点,也互相打听群体的最佳位置。它的速度更新公式看似有模有样,拆开来其实就是三项的加权:惯性项——保持上一刻的飞行趋势,不急刹车;自我认知项——朝自己历史上飞过的最好位置靠拢;群体认知项——朝整个鸟群目前发现的最优位置靠拢。三项合起来,决定每只鸟下一步飞多快、往哪飞。这三项缺一不可:把自我认知项去掉,所有鸟盲目从众,容易集体困死在一个山头;把群体项去掉,每只鸟各飞各的,收敛慢得让人着急。也正因为公式简洁、参数少、收敛快,粒子群成了工程师"顺手就能写一个"的心头好。
顺便一提,这个家族还有第四位知名成员——蚁群算法(ACO),靠"信息素越浓、路径越被青睐"的正反馈机制找最优路径,在物流配送、路径规划这类组合优化问题上大放异彩。本文聚焦仿真场景,就不再展开了。
三种哲学,殊途同归:都不依赖数学解析,都靠"模拟自然 + 大量试错"逼近最优。
问题来了——仿真行业为什么偏偏吃这一套?
三、根源:仿真问题,天生就是"最难伺候"的优化问题
做过工程仿真的人都懂,仿真的目标函数是优化算法领域的"地狱难度",难在四个地方。
第一,它是彻底的黑箱。你把结构参数、材料参数、边界条件喂给求解器,它只给你一个结果——应力、温度场、风阻系数——中间的计算过程动辄几十万行方程组的迭代,不给你解析式,不给你概率分布。传统优化方法的第一步"对目标函数求导",在这里直接无从下手。
第二,评估贵得离谱。一次精细的CFD流场仿真,跑几个小时是常态;一次整车碰撞分析,跑上一整天也不稀奇。而优化动辄需要评估成百上千个方案——如果每个方案都要真刀真枪跑一遍仿真,时间成本就是"几个月"这个量级。算法效率的每一分浪费,都被乘以"小时级"的单次成本。
第三,地形坑坑洼洼。工程响应面往往高度非线性、多峰多谷,还布满平坦区。贪心算法一进去就卡在第一个山头上沾沾自喜,根本不知道几维之外还有一座珠峰。
第四,约束无处不在。重量不能超标、应力不能超限、频率必须避开共振区、工艺上还得能造出来——可行域在设计中空间里被切得七零八落,很多"数学上的最优解"在工程上根本不可行。
面对这样的四重困难,依赖梯度、依赖解析式、依赖连续光滑假设的经典优化方法,几乎全军覆没。
而遗传算法、模拟退火、粒子群,恰好是"钝器"——不需要梯度,不挑函数形态,对黑箱天然免疫,天生抗多峰,还特别适合并行:一次种群评估扔给计算集群,几百个仿真任务同时跑。更妙的是,约束处理对它们来说轻车熟路——罚函数一加,不可行方案自动被淘汰。
这种看似"笨"的办法,在仿真场景里反而成了最聪明的选择。
这套打法早有成熟的工程范式。以电机设计为例:优化一台永磁同步电机的振动噪声,工程师把定子槽形、转子结构这些参数交给遗传算法,每一代个体的适应度,不是拍脑袋算的,而是由ANSYS Maxwell这类有限元软件实打实仿真出来——通过脚本自动调用仿真、自动回传齿槽转矩、转矩脉动、平均转矩这些指标。优化跑下来,振动位移和加速度明显下降,而电磁性能几乎不受损。同样的思路,用模拟退火调Support Vector Machine 的参数、用粒子群训练神经网络的权重,都是业界玩了几十年的成熟操作。算法与仿真软件的"自动联动",本身就是一套可以复用的生产力工具。
四、没有免费午餐:通用性本身就是工业级价值
优化领域有条著名的"没有免费午餐定理"(No Free Lunch Theorem):在所有可能的问题上,任何两种算法的平均表现完全一样。翻译成人话:一个算法在某类问题上的惊艳,必然以在另一类问题上的平庸为代价。
新算法再漂亮,往往是在特定问题上刀刃寒光,换个场景就水土不服。而工程仿真面对的问题五花八门:这个月优化散热器的翅片间距,下个月做车身结构的轻量化,再下个月调天线的电磁参数,还要处理多目标权衡——重量和刚度怎么折中,成本和性能怎么取舍。
这时候,通用、稳健、不要求使用者精通泛函分析和凸优化的三套老算法,就是工程师手里的"万能扳手":不是最快的,但什么螺丝都能拧;不保证每次都摸到全局最优,但几乎总能稳定地找到"足够好"的解——而工程上,"足够好+按时交付"永远比"理论最优+永远在调试"值钱。
还有一个常被忽视的维度:可解释性与责任。汽车、航空这些行业,设计方案要过评审、要留档、要可复现。遗传算法的进化过程清清楚楚,每一代为什么淘汰、为什么保留,都有迹可循;模拟退火甚至敢给出"概率 1 收敛"的理论承诺。相比之下,一个深度模型的黑箱决策,在工程责任面前是难以接受的。
五、生态已经长成:选算法就是选生态
必须承认,贝叶斯优化、强化学习这些新方法在学术圈风头正劲,在低维度、评估便宜的问题上确实惊艳。
但落地到真实工程,三个门槛立刻显形。
贝叶斯优化在高斯过程上建立代理模型,计算复杂度随维度增长很快,工程问题动辄几十上百个设计变量,它就喘不上气了;强化学习动辄需要百万次量级的交互训练,而仿真的单次评估是小时级——这个账怎么算都算不平;至于深度代理模型,精度看着漂亮,但在关键设计点上敢不敢信、误差怎么界定,在没有充足样本验证之前,没人敢拿它拍板一个要上产线的设计。
所以业界真正的共识打法是"AI做增量,老算法当主力":用Kriging、神经网络、径向基这些代理模型去近似昂贵的仿真,再用遗传算法、粒子群在又快又便宜的代理模型上高速寻优,关键时刻回到真实仿真做校验。你看,AI没有取代老算法——它们成了老算法的"加速外挂"。
这就是"老三样"四十年不倒的完整答案:不是工程师守旧,而是一个被反复验证过的理性选择——面对黑箱、昂贵、无梯度、多约束的仿真问题,通用稳健的智能优化算法,加上成熟的工具链生态,就是当下性价比最高的解。
六、那AI呢?它是援军,不是终结者
第三个原因,也是最容易被低估的:生态。 二三十年下来,三套老算法周围已经长出了一整片森林:主流商业软件把它们做成了标准模块,工程师拖拖拽拽就能搭建"DOE试验设计→代理模型→智能寻优"的完整流程;教材、论文、开源实现、工程案例、踩坑经验汗牛充栋,一个刚入行的工程师认真学一周就能上手干活;连算法本身的工程化细节——约束处理、多目标排序、并行调度、早停准则——都被打磨了无数轮。 技术选型从来不只是选算法本身,更是选生态、选学习成本、选"团队里任何人都能接手"的可维护性。一个冷门但理论上更优的算法,在真实的研发项目里,反而是一种风险。
七、老伙计们的软肋,恰恰藏着真正的门槛
当然,得说句公道话:这三套算法不是没有软肋。遗传算法容易"早熟",几代之后就集体躺平在局部最优上;粒子群的理论根基至今偏薄弱,收敛性分析始终不够硬气;模拟退火收敛偏慢,算力开销大。而它们有一个共同的、最要命的短板——参数敏感。
种群规模设多大?交叉概率、变异概率取几?惯性权重怎么衰减?初始温度设多高、降温策略选哪种?蚁群的信息素挥发因子给多少?——这些问题,没有任何一本教科书能给出通用公式,业内也没有放之四海而皆准的答案,全靠大量实验和工程经验去磨。同一套算法,参数调对了收敛又快又稳,调错了跑三天也未必比人工试凑强。
这恰恰解释了一个行业现象:算法和工具都是现成的、开源的、教材里都写了的,但很多企业的仿真团队搭了流程,效果却始终差一口气。差的那一口气,不在算法,在参数、在流程、在无数个项目里喂出来的经验。
同样一个散热器设计:老手凭经验试50版参数,要一个月,性能提升 8%;搭一套"DOE+代理模型+智能寻优"的自动流程,三天收敛,提升 20% 以上——而且这套流程以后每个项目都能复用。这中间的差距,就是企业实打实的研发成本、人力成本和时间窗口。
仿真行业正在经历一场悄悄的分工变革:从"仿真验证设计"走向"仿真驱动设计"。前者的工程师是算数的人,后者的工程师是设计优化流程的人。这场变革里,吃亏的从来不是不会写算法的工程师——现成的算法和工具就在那里——而是不知道可以把仿真变成自动寻优引擎的团队。
如果你也在为仿真优化的效率发愁——参数怎么定、流程怎么搭、代理模型怎么建、多目标怎么权衡——欢迎找优飞迪科技聊聊。我们深耕仿真咨询多年,在结构、热、流体、电磁等多个领域落地过大量工程优化项目,擅长把遗传算法、模拟退火、粒子群这些"老伙计"和现代优化流程组合起来,把参数调 教、流程搭建这些"经验密集型"的硬骨头啃下来,帮客户把仿真从"算一遍"升级成"自动找到最优的那一遍"。
把你的优化难题交给我们,让每一次仿真,都花在刀刃上。