当算力中心开始生产 Token,液冷为什么成了产能问题?——一次 GPU 冷板流道拓扑优化实践
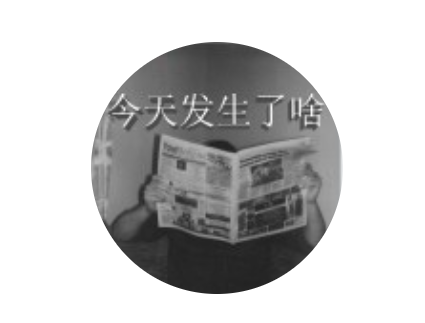
最近参加 2026 移动网络大会,一个明显感受是:行业讨论算力,正在从“有多少张卡”,转向“能够稳定、低成本地交付多少 Token”。而当我们沿着 Token 工厂向底层追溯,会发现宏大的算力叙事,最终要落实到供电、网络、散热,以及一块液冷板里的每一条流道。本文结合一次 GPU 冷板拓扑优化仿真,聊聊液冷为什么不只是散热问题,更是算力基础设施的产能问题。
一、Token 工厂
所谓 Token 工厂,可以把它理解为一种以大规模算力集群为底座,结合模型、推理优化和调度平台,持续生产并交付 Token 的新型算力基础设施。
数据和电力进入,模型服务与 Token 输出。这个类比背后,是算力评价逻辑的变化:过去我们更关心 GPU 数量、峰值算力和机柜规模;现在还要进一步追问——这些硬件究竟能稳定产生多少有效 Token?单位 Token 的能耗和成本又是多少?
大会上,中国移动披露了进一步的算力建设计划:2027 年算力投资计划达到 1000 亿元以上,同时推进吉瓦级数据园区建设,并提出在数据中心采用标准化模块设计、应用高密液冷技术。
参展企业发布的 Token 工厂方案,也把算力供给、算电协同、算网调度和液冷散热放进了同一套系统框架。
这说明一件事:液冷正在从服务器内部的散热选项,变成算力基础设施整体设计的一部分。
二、为什么 Token 产能会落到“散热”上?
GPU 的峰值算力,并不天然等于可持续交付的 Token 产能。
如果芯片温度过高,系统需要留出热裕量,甚至面临降频和可靠性压力;如果冷板流阻过大,泵功、管路设计和运行成本都会增加;如果流量分配不合理,即使总流量足够,局部热点仍可能存在。
因此,Token 工厂的有效产出不是由某一张卡单独决定的,而是由芯片、网络、供电、散热和调度共同决定。
对于高热流密度设备,冷板式液冷的价值不仅是“把温度降下来”,还包括:
换句话说,散热系统不是算力产线的附属设施,它本身就是产线能否连续运转的基础条件。
三、一块液冷板,远不是“打几条水槽”那么简单
冷板设计看似只是让冷却液从入口流到出口,实际却包含一个典型的多目标问题:
水应该往哪里走?
走最短、最直的路径,压降往往更小,但可能绕开主要发热区;让流道穿过每一处芯片间隙,有利于局部换热,却可能带来更高流阻和更复杂的制造结构。
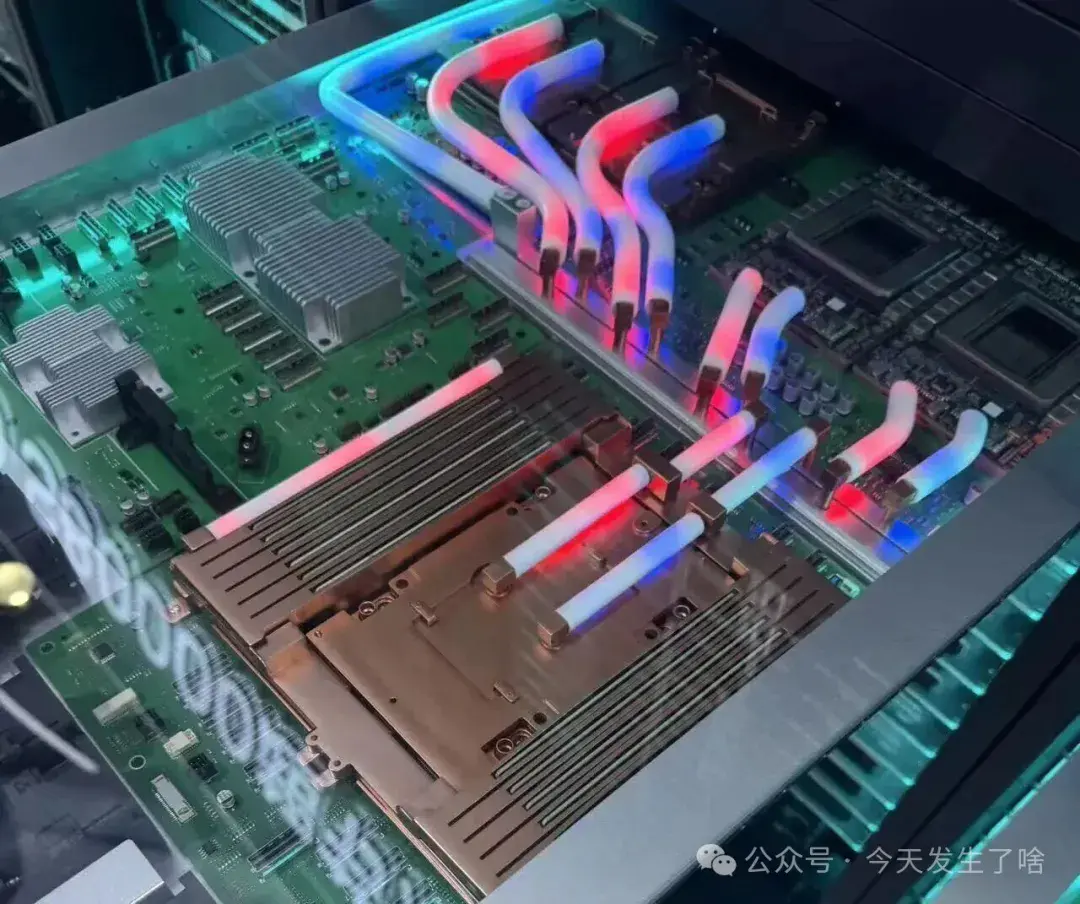
所以,冷板设计不能只问“最高温度是多少”,还要同时问:
这正是拓扑优化可以发挥作用的地方:不只比较几种人工设计的流道,而是让材料分布在目标函数和约束条件下逐步演化。
四、把液冷需求变成一次可计算的仿真
本次comsol液冷板流道拓扑优化采用二维等效冷板模型,并非某款服务器的直接工程复刻,参考论文《Topology Optimization of MIMO Cooling Plates for Discrete Heat Sources in GPUs》译《面向 GPU 离散热源的多输入多输出冷板拓扑优化》。
模型条件如下:
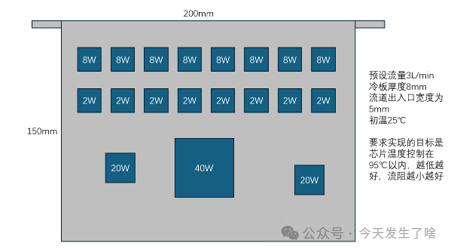
图 :仿真对象与离散芯片热源布置。不同区域对应不同热功率,总热功率为 160 W。
在低流量阶段,先用层流模型完成建模、参数检查和初步拓扑优化;
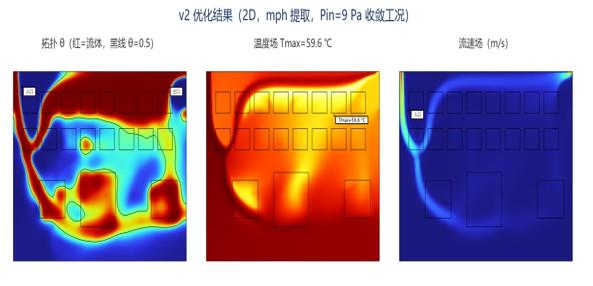
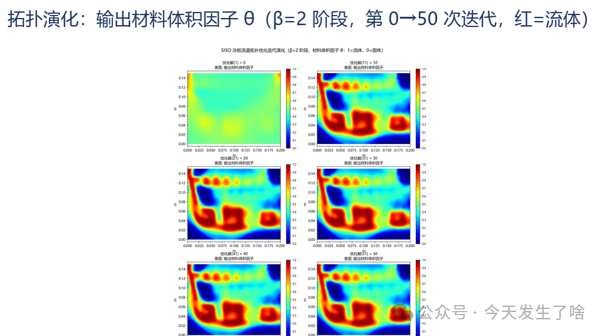
进入 3 L/min 的目标工况后,流道内雷诺数达到数千,因此进一步采用 k-ε 湍流模型进行校核和重新优化。
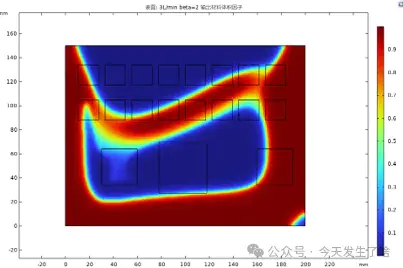
图 k-ε 湍流模型进行校核和重新优化
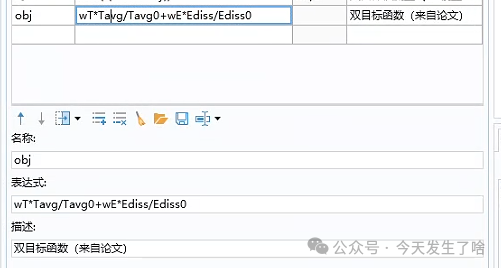
拓扑优化中,用材料体积因子描述固体与流体区域,并设置约 0.5 的流体体积分数约束。目标函数同时考虑平均温度与流动能耗:
目标 = 温度项权重 × 归一化平均温度 + 能耗项权重 × 归一化流动能耗
五、从一块冷板,看 Token 工厂的工程底色
Token 工厂听起来是一个宏大的产业概念,但它最终仍由无数具体的工程细节构成。
一条过窄的流道,可能增加泵的负担;一个被忽视的局部热点,可能压缩长期运行裕量;一个无法加工的复杂分支,可能让漂亮仿真止步于图纸。
从这个角度看,液冷板拓扑优化代表的并不只是某一种仿真技巧,而是算力基础设施建设方法的变化:
液冷当然不是 Token 工厂的全部。模型效率、推理调度、网络互联和供电架构同样重要。但当算力密度持续提升,散热已经不再是可以最后补课的环节。
写在最后:三个提醒
把温度与能耗权重从 0.5/0.5 调成 0.8/0.2,先做一组对照; 必要时加入最高温度或大功率芯片局部温度目标,别让平均温度掩盖热点; 在芯片间隙局部细化网格,给细分支留下生成空间;
Token 工厂的竞争力,不只在于拥有多少 GPU,也在于能否把每一份电力稳定、高效地转化为有效 Token。
而对热设计工程师来说,这件事可以从一个很具体的问题开始:
让冷却液在该去的地方,以合适的流量流过。
附:福利时间,这套拓扑优化液冷流道设计资料打包好了
这篇推文的"幕后"其实是一整套可照搬的资料,整理成了礼包:
🧩 复现PPT文件,参考论文——COMSOL 6.2按文档操作 即可复现,源文件需关注私信小编获取。
领取方式:
通过网盘分享的文件:presentation_01031.pptx
链接: https://pan.baidu.com/s/1pw7yMmph_a7n9v68OE5tqQ?pwd=xxh1 提取码: xxh1