
2-38 多个巡检位置,怎样让无人机从基地出发再回到基地时路线尽量短?
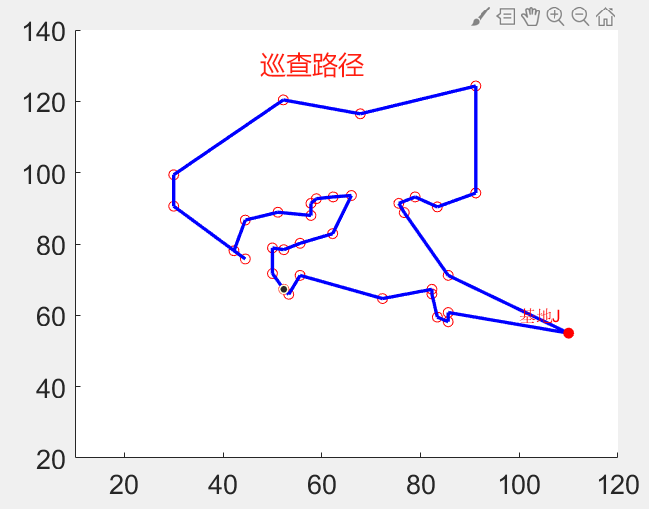
一句话介绍: 这套 MATLAB 程序把 34 个巡检位置和 1 个基地位置组成二维闭环路径规划问题,通过蚁群算法反复构造访问顺序、计算路线长度并更新信息素,最终得到一条访问全部位置并返回起点的较短巡检路线,同时给出最优距离与平均距离的迭代变化。
先看它解决什么问题
无人机执行多点巡检时,真正麻烦的并不是“怎样飞到某一个点”,而是:
这么多巡检位置应该按什么顺序访问,才能让整条闭环路线尽量短?
当前工程给出了 35 组二维坐标,其中最后一个点 (110, 55) 在程序图中被标记为 基地 J,其余 34 个点作为待访问位置。
程序要处理的就是一类典型闭环路径问题:
基地与巡检点坐标 → 建立两两距离矩阵 → 多只蚂蚁构造访问顺序 → 计算闭环路线长度 → 更新信息素 → 继续迭代搜索 → 得到较短闭环路线
工程自带的结果文件还保存了一次实际运行得到的巡检路线和收敛过程。根据当前坐标和保存路线复算,该次运行的闭环长度约为 347.7542 个坐标单位。
1. 当前工程到底由哪些部分组成?
这套程序结构很精简,主流程集中在 3 个 MATLAB 文件中。
文件 | 主要作用 |
|---|---|
mainfun.m | 设置巡检位置、调用蚁群算法,并绘制原始点、最终路线和迭代曲线 |
Antcolonyalgorithm.m | 完成距离计算、蚂蚁路径构造、路线评价、信息素更新和最优解记录 |
flightRoute.m | 根据最终访问顺序绘制闭环飞行路线 |
工程中还带有 3 个已经保存的 EMF 结果文件:
jiuyuandian.emf:原始巡检位置分布;
lujing.emf:一次运行得到的最终巡检路线;
diedaicishu.emf:最优距离与平均距离随迭代次数的变化。
程序没有读取外部数据文件,35 个位置坐标直接写在 mainfun.m 的 position 矩阵中,因此更换巡检任务时,最直接的入口就是修改这组坐标。
2. 35 个位置怎样变成一个“最短路线”问题?
每个位置都由二维坐标表示。
对于第 i 个位置和第 j 个位置,程序使用二维欧氏距离:
Dᵢⱼ = √[(xᵢ - xⱼ)² + (yᵢ - yⱼ)²]
Antcolonyalgorithm.m 会先根据 35 个坐标建立完整距离矩阵 D。
一条候选路线可以写成:
R = (r₁, r₂, …, r₃₅)
其中每一个位置在路线中出现一次。
由于无人机最终还要回到出发位置,因此当前程序评价的是闭环总长度:
L(R) = Σᵢ₌₁³⁴ D(rᵢ, rᵢ₊₁) + D(r₃₅, r₁)
所以这里优化的不是某两个点之间的最短线段,而是:
所有位置都访问一次之后,整条闭环路线的总长度。
当前坐标本身没有在源码中声明米、千米等物理单位,因此程序输出的路线长度首先应理解为坐标单位。只有当输入坐标本身具有明确物理单位时,路线长度才继承相同单位。
3. 一只“蚂蚁”在程序里究竟代表什么?
在这套代码中,一只蚂蚁并不是在连续平面中自由移动,而是在 35 个离散位置之间构造一个访问顺序。
Tabu 矩阵记录每只蚂蚁已经访问过的位置。
当某只蚂蚁选定第一个位置以后,后续每一步都只能从尚未访问的位置中选择下一站,因此一条完整路线天然满足:
35 个位置全部访问;
每个位置只进入访问序列一次;
最后再从末位置连接回首位置。
也就是说,程序通过禁忌表直接保证了“不能漏点、不能重复访问同一点”的基本路线约束。
当前默认有:30 只蚂蚁
而位置总数是:35 个
每一轮开始时,代码利用 randperm 随机安排蚂蚁的初始位置。由于默认蚂蚁数量小于位置数量,同一轮最开始的 30 只蚂蚁会从 30 个不同位置出发,再分别构造自己的完整路线。
4. 蚂蚁为什么不会完全随机选择下一站?
真正体现蚁群算法特点的地方,是下一位置的选择概率。
程序先定义距离启发信息:
ηᵢⱼ = 1 / Dᵢⱼ
距离越短,ηᵢⱼ 越大。
同时,每条有向连接还具有信息素 Tau。
从当前位置 i 前往尚未访问的位置 j 时,代码使用下面的权重关系:
wᵢⱼ = (Tauᵢⱼ)^Alpha × (ηᵢⱼ)^Beta
然后在全部未访问候选位置之间归一化:
Pᵢⱼ = wᵢⱼ / Σ wᵢₖ
最后利用累计概率和随机数进行轮盘赌选择。
这意味着下一站并不是简单选择“眼前最近的点”,而是同时参考:
历史搜索经验 + 当前距离启发
其中:
Alpha 越大,历史信息素对选择的影响越明显;
Beta 越大,距离近的候选点越容易被选择。
当前程序令两者都为 0.9,也就是让信息素和距离启发保持相同的指数权重。
5. 为什么较短路线会越来越容易再次出现?
一轮中的 30 只蚂蚁都完成闭环路线后,程序会计算每一条路线的总长度 L(i)。
随后按照路线长度释放信息素:
ΔTauᵢⱼ ← ΔTauᵢⱼ + Q / Lₖ
其中 Lₖ 是第 k 只蚂蚁的闭环路线长度。
这个关系最关键的一点是:
路线越短,Q / Lₖ 越大,对经过边的强化越明显。
完成本轮信息素累积以后,程序再执行:
Tau ← (1 - Rho) × Tau + ΔTau
这里的 Rho 是信息素蒸发系数。
因此每一轮都同时发生两件事:
旧信息逐渐衰减 → 本轮较好路线重新强化
如果完全不蒸发,早期偶然形成的路径可能长期占据优势;如果蒸发过快,又可能使历史搜索经验难以积累。
当前代码使用:Rho = 0.1
即每轮保留原信息素的 90%,再叠加本轮新释放的信息素。
6. 程序怎样避免已经找到的好路线被下一轮随机搜索丢掉?
当前源码还有一个很重要的实现细节。
从第 2 次迭代开始,程序会执行:
Tabu(1,:)=R_best(NC-1,:);
也就是把上一轮最好的路线直接放入本轮第一只蚂蚁。
因此虽然其他蚂蚁仍然继续随机探索,但上一轮的最好结果不会被直接丢弃。
这也解释了工程自带收敛图中最短距离曲线为什么呈现明显的阶梯式下降:
发现更短路线 → 保存该路线 → 下一轮继续保留 → 再发现更好路线 → 再次下降
所以 L_best 虽然在代码含义上记录的是“每一轮的最短距离”,由于这种精英保留机制,它实际上不会因为下一轮搜索较差而重新大幅升高。
7. 当前默认设置下,算法具体搜索多少次?
mainfun.m 对蚁群算法的实际调用为:
Antcolonyalgorithm(position,2000,30,0.9,0.9,0.1,0.1)
对应关系是:
最大迭代次数 NC_max = 2000;
蚂蚁数量 m = 30;
信息素重要程度 Alpha = 0.9;
距离启发重要程度 Beta = 0.9;
信息素蒸发系数 Rho = 0.1;
信息素增加强度 Q = 0.1。
因此一次默认运行不是只生成 30 条路线以后就停止,而是最多执行 2000 轮迭代。
每轮都会经历:
随机安排起点 → 构造 30 条候选路线 → 计算闭环长度 → 保留本轮最好路线 → 计算平均距离 → 更新信息素
之后再进入下一轮。
算法最终返回:
R_best:各轮最优路线;
L_best:各轮最优路线长度;
L_ave:各轮候选路线平均长度;
Shortest_Route:全部迭代中找到的最好访问顺序;
Shortest_Length:对应的最短路线长度。
8. 工程自带的一次实际运行得到了什么路线?
工程中的 lujing.emf 保存了一次实际运行结果。
结合当前 position 坐标,可以还原出这次保存结果中的完整闭环访问顺序。该结果恰好以第 35 个位置,也就是基地 J 开始。
为了便于阅读,将路线分成前后两段表示:
前半段:
35 → 21 → 22 → 23 → 18 → 20 → 19 → 3 → 5 → 29 → 2 → 1 → 33 → 30 → 31
后半段:
31 → 9 → 8 → 14 → 7 → 6 → 4 → 11 → 12 → 27 → 28 → 32 → 25 → 13 → 26 → 10 → 24 → 16 → 34 → 15 → 17 → 35
按照源码中的二维欧氏距离重新计算这条闭环路线:
路线长度约为 347.7542 个坐标单位。
从 diedaicishu.emf 也可以看到,搜索初期最优距离较高,随后经过多次阶梯式下降,最终稳定在接近上述数值的位置。
图中还有另一条明显更高、持续波动的曲线,它对应每轮全部蚂蚁的平均路线长度 L_ave。
需要注意,当前 mainfun.m 把 L_best 和 L_ave 都画成蓝色,而且没有添加图例,因此两条曲线主要需要结合源码判断:较低的阶梯曲线是最优距离,较高的波动曲线是平均距离。
9. 为什么这里不直接采用“每次都去最近的点”?
如果从基地开始,每次都选择当前最近的未访问位置,实现会非常简单。
但这种方法只考虑:
眼前这一段是否最短。
它不会主动考虑:
现在走到这个点以后,会不会导致后面出现一段很长的回程或跨区连接。
蚁群算法则允许不同蚂蚁探索不同访问顺序,并利用整条闭环路线的总长度反过来调整后续搜索概率。
因此当前程序的思路不是:
每一步都必须最短
而是:
允许探索不同顺序 → 比较完整闭环总长度 → 强化整体表现更好的路线
这也是蚁群算法更适合当前多点访问顺序优化问题的原因。
10. 为什么这里的“最优路线”不能理解成数学上已经证明的全局最优?
当前程序采用的是随机启发式搜索。
源码没有设置固定随机种子,randperm 和轮盘赌过程都会产生随机性,因此:
不同运行之间可能得到不同的访问顺序,也可能得到略有差别的最短路线长度。
工程自带的 347.7542 是提供资料中保存下来的一次真实运行结果,而不是代码对所有可能排列进行穷举以后得到的全局最优证明。
对于 35 个位置,如果直接枚举所有访问顺序,组合规模会迅速增大。当前程序选择蚁群算法,目的正是在不进行完整穷举的前提下,通过持续迭代寻找质量较好的路线。
因此更准确的表述是:
当前算法找到的最好路线
而不是:
已经严格证明不存在任何更短路线。
如果需要做算法实验或结果复现,还应主动设置随机种子,并进行多次独立运行后比较最优值、平均值和结果方差。
11. 当前源码还有哪些边界需要特别注意?
基地在算法内部并没有特殊身份
虽然 mainfun.m 把第 35 个位置 (110,55) 绘制为“基地 J”,但 Antcolonyalgorithm.m 实际上把 35 个位置完全等价地参与搜索。
也就是说,源码没有规定:
访问序列的第一个编号必须等于 35。
它只保证最终形成一个包含全部位置的闭环。
对于闭环路线而言,同一个环可以从任意节点开始重新编号,因此如果实际无人机任务必须明确写成“基地出发 → 巡检 → 基地返回”,可以在得到 Shortest_Route 后把路线循环移动,使基地编号位于第一位。
工程自带的 lujing.emf 这次结果恰好已经以 35 号基地开始。
信息素是按有向边更新的
当前距离矩阵是对称的:
Dᵢⱼ = Dⱼᵢ
但是代码更新 Delta_Tau(i,j) 时,没有同时把相同增量写入 Delta_Tau(j,i)。
因此在算法学习过程中:
i → j 和 j → i 的信息素可以不同。
这与严格对称旅行商问题中常见的“双向同时强化”实现并不完全相同,是当前源码的一个具体实现特征。
当前模型没有加入真实飞行约束
程序优化的是二维平面中的欧氏距离,没有进一步考虑:
障碍物;禁飞区;飞行高度;转弯半径;
风场;电池容量;飞行速度变化;巡检时间窗;不同巡检点的服务时间。
因此它适合解决的是:
已知二维巡检坐标条件下的访问顺序与闭环距离优化。
如果任务中存在建筑物、山体、禁飞区域或续航约束,就不能直接把两点间的欧氏直线距离当作真实可飞距离。
最短路线长度已经计算,但主程序没有直接显示数值
Antcolonyalgorithm.m 会返回 Shortest_Length,mainfun.m 也接收了这个变量。
但是当前 mainfun.m 没有继续使用 disp、标题或文本框把它显示出来。
所以直接运行时主要看到的是:
原始位置图 + 最佳路线图 + 迭代曲线图
而不会自动在命令窗口中明确打印“最短路线长度 = …”。
如果希望每次运行后直接得到数值,应在主程序中增加对 Shortest_Length 的显示或输出。
12. 怎么运行这套程序?
运行:mainfun
程序会按照当前源码中的 35 个二维位置执行蚁群搜索,并依次得到原始散点分布、优化后的闭环路线以及迭代过程。
当前实现使用的都是常规 MATLAB 数值、随机数和绘图函数,没有看到必须依赖额外数据文件、训练模型或专用工具箱的算法调用。
如果要换成自己的 UAV 巡检位置,主要修改 mainfun.m 中的 position。
例如增加、删除或替换位置以后,Antcolonyalgorithm.m 会通过 size(C,1) 自动取得新的位置数量,不需要把算法内部的 n 手动改成 35。
但当前基地的绘图标记仍然写死为 (110,55)。因此如果基地位置也发生变化,还应同步修改 mainfun.m 中基地圆点和“基地 J”文字的绘制位置,否则算法使用的新坐标与图上的基地标记会不一致。
如果实际任务要求“必须明确从基地编号开始输出”,还需要对最终闭环访问序列做一次以基地为首节点的循环重排。
13. 哪些参数最值得修改?
当前程序中真正会明显改变搜索过程的,主要是下面这些蚁群参数。
参数 | 当前值 | 为什么值得改 | 调整后的主要影响 |
|---|---|---|---|
NC_max | 2000 | 决定允许搜索多少轮 | 增大通常能给算法更多改进机会,但运行时间也增加 |
m | 30 | 决定每轮同时探索多少条候选路线 | 增大可提高搜索覆盖度,同时增加每轮计算量 |
Alpha / Beta | 0.9 / 0.9 | 决定历史信息素与距离启发的相对作用 | 改变二者比例会影响探索性、局部距离偏好和收敛行为 |
Rho | 0.1 | 控制旧信息素衰减速度 | 增大遗忘更快,减小则历史路线影响保持更久 |
Q | 0.1 | 控制每轮路线对信息素的强化幅度 | 会改变信息素累积速度,需要结合 Rho 一起观察 |
对于迁移到新的巡检任务,优先应该先修改的并不是这些算法参数,而是真实巡检坐标position。
在坐标固定以后,再调整蚂蚁数量、迭代次数以及信息素相关参数,比较多次独立运行结果,才更适合判断某组参数是否真的更稳定。
14. 一句话看懂这个项目
这是一个蚁群算法的 UAV 多点巡检闭环路径优化程序:当前工程直接给出 35 个二维位置,其中第 35 个(110,55)被标记为基地 J,程序先建立欧氏距离矩阵,再让默认 30 只蚂蚁按照信息素和距离启发概率构造完整访问顺序,以闭环总距离评价路线,并通过Q/L信息素强化、Rho=0.1蒸发和上一轮最优路线保留机制持续搜索 2000 次;工程自带的一次运行结果得到35 → 21 → … → 17 → 35的完整闭环路线,按当前坐标复算长度约为 347.7542 个坐标单位。需要注意的是,算法本身把基地当作普通节点、没有固定随机种子,也没有加入障碍物、禁飞区、续航和飞行动力学等约束,因此它更适合作为二维巡检点访问顺序优化和蚁群算法实验程序,而不能直接等同于完整的真实无人机航迹规划系统。


